一句话定位
MAGVIT(MAsked Generative VIdeo Transformer)是 Google Research × CMU 提出的首个面向视频的”3D-VQ tokenizer + 掩码 token 生成(MaskGIT 式非自回归)“框架,用一个模型支撑 10 种视频合成任务;在 UCF-101 类条件生成上把 SOTA FVD 从 332→76(↓77%),BAIR 帧预测 84→62(↓26%)、Kinetics-600 16.2→9.9(↓39%),且推理比扩散模型快两个数量级、比自回归 transformer 快 60×。它是后续 magvit-v2 与 Open-MAGVIT2 tokenizer 家族的源头。
背景与定位
2022 年视频生成主要走两条路线:扩散模型(video-diffusion-models-vdm、RaMViD)质量高但需 256–1000 步去噪、采样极慢;自回归 transformer(tats、CogVideo、phenaki、NÜWA、VideoGPT)把视频量化成离散 token 后逐 token 解码,序列长、推理 60× 慢于本工作。图像域已有 maskgit(Masked Generative Image Transformer,CVPR 2022,同组 Huiwen Chang/Lu Jiang)证明”VQ 量化 + BERT 式掩码 token 双向并行解码”能在 12 步内生成高质量图像。
MAGVIT 把 MaskGIT 范式从图像搬到视频,并解决两个视频特有难题:
- 如何高保真量化视频——提出 3D-VQ(时空联合量化),重建质量超过 2D-VQ(逐帧)和已有 3D-VQ(tats),且 token 序列更短(4×16×16=1024)→ 直接决定生成效率上界。
- 如何用一个掩码模型支撑多种条件任务(帧预测/插帧/内外画补全/类条件)——提出 COMMIT(COnditional Masked Modeling by Interior Tokens),把”内部条件”(部分可观测的视频体素)嵌进被损坏的 token 序列,避免直接 unmask 条件区导致的非因果信息泄漏。
定位:它不是文生视频模型(作者明确把 text-to-video 留作 future work,仅 Web 数据模型展示泛化),而是面向”视频合成 + 编辑/补全”的高效多任务生成器,并顺带贡献了一个被后续广泛复用的视频 tokenizer 设计。CVPR 2023 收录(Highlight)。作者横跨 Google Research(主)、CMU(Lijun Yu/Hauptmann)、Georgia Tech(Irfan Essa)。
模型架构
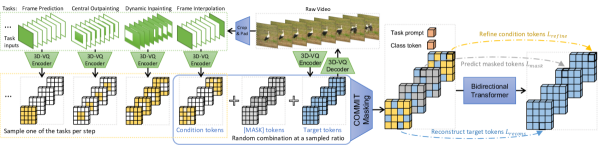
图源:Figure 2 “MAGVIT pipeline overview”,MAGVIT: Masked Generative Video Transformer (arXiv:2212.05199)
两阶段:第一阶段训 3D-VQ tokenizer,第二阶段冻结 tokenizer 训双向掩码 transformer。
① 3D-VQ tokenizer(基于图像 VQGAN 扩展)
- 把 16 帧 128×128 视频量化为 4×16×16 = 1024 个离散 token(BAIR 为 64×64),压缩率 4×16×16(时×空×空,即时间 4×、空间 8×8)。
- 码本(codebook):1024 个 entry,embedding 维度 256——刻意比 TATS 的 16384 小得多。
- 架构相对 tats 3D-VQGAN 的关键改动(见论文 Tab.7 与附录 A.1):
- 下采样用 average pooling 而非 strided conv;上采样用 nearest resize + conv。
- 靠近 latent 用纯空间(2D)下/上采样,靠近像素用时空(3D)下/上采样,编码器/解码器镜像;3D 层放在 encoder 浅层。
- 卷积 padding 由零填充改为 reflect padding,提升同内容不同位置的 token 一致性。
- 单个更深的 3D 判别器(取自 StyleGAN 判别器并 inflate 到 3D),而非 TATS 的 2D+3D 双浅判别器。
- GroupNorm 替 BatchNorm,Swish 替 SiLU;加 LeCam 正则稳定 GAN——使模型从训练初期就能稳定带 GAN loss(不同于 VQGAN)。
- 3D inflation:小数据集(UCF-101)上用 ImageNet 预训的 2D-VQ 初始化 3D-VQ,central inflation(2D kernel 填入零 3D kernel 的时间中心切片),其余层直接拷贝;central inflation 优于 average inflation(Tab.7)。
- 规模:B 版 41M(VQVAE)+15M(判别器),L 版 158M+61M(基通道 c=1→2,base channels 64→128,通道倍率 1,2,2,4)。
② 双向 transformer(BERT 架构)
- 用 BERT(Flaxformer 实现),非自回归并行解码,序列长度 1026(1 task prompt + 1 class token + 1024 visual token)。
- 三个规模(Tab.8):B = 87M(12 层/12 头/hidden 768/MLP 3072),L = 305M(24 层/16 头/1024/4096),H = 634M(32 层/16 头/1280/5120,仅用于 12M Web 数据训练做 demo)。
- 论文正文里 “MAGVIT-B 128M / MAGVIT-L 464M” 指 tokenizer+transformer 合计。
- 条件注入:task prompt token + class token 作为前缀;内部条件经 COMMIT 嵌入 token 序列(见训练方法)。
COMMIT 多元掩码(核心创新):对每个目标 token zᵢ,按采样的掩码比例随机替换为:① 若对应体素含条件像素 → 条件 token z̃ᵢ(refine);② 否则 → [MASK](predict);③ 高于阈值 → 保留原 token(reconstruct)。这给出定长序列(不同区域条件都映射到 1024 长),且提供正确因果掩码。
数据
全部使用公开 benchmark 训练(作者强调,除 Web 模型外不用任何非公开/付费数据;text-to-video 因需大规模非公开图文/视频对而留作 future work)。各数据集(附录 B.2/Tab.9):
| 数据集 | 训练规模 | 评测规模 | 分辨率 | 任务 |
|---|---|---|---|---|
| UCF-101 | 9.5K 训练视频 | — | 128×128 | 类条件生成(101 类) |
| BAIR Robot Pushing | 43K | 256 | 64×64 | 帧预测 / 8 任务 MT |
| Kinetics-600 | 384K | 29K | 128×128(评测 central-crop→64×64) | 5 帧帧预测 |
| SSv2 (Something-Something-v2) | 169K | 24K(174 类) | 128×128 | 10 任务 MT |
| nuScenes(自动驾驶,仅前视) | 5.4K | 0.6K | 128×128 | 泛化展示 |
| Objectron(物体中心多视角) | 14.4K | 3.6K | 128×128 | 泛化展示 |
| Web videos | ~12M | 26K | 128×128 | 泛化展示(H 模型) |
- 统一学习配方,仅训练 epoch 数随数据集变化(如 UCF-101 transformer 2000 epoch,Kinetics-600 180–360,Web 仅 20)。
- 数据清洗/过滤/re-captioning/美学/安全过滤:论文未披露(非文生视频,无文本标注流程;用标准 benchmark 原始划分)。
- 训练用 16 帧、frame stride 1 的片段。
训练方法
目标:掩码 token 建模(masked-token / MTM),非扩散、非自回归。
3D-VQ 训练(阶段一)
- 损失:逐帧 image perceptual loss(权重 0.1)+ GAN loss(non-saturating,对抗权重 0.1)+ LeCam 正则 + 判别器 r1 gradient penalty(cost 10) + VQ 量化损失。
- Optimizer:Adam(β1=0, β2=0.99);峰值 lr 1e-4;linear warmup + cosine decay;EMA decay 0.999。
- Batch:B=128 / L=256。
Transformer 训练(阶段二,冻结 tokenizer)
- 目标函数(Eq.3/4)= 多任务条件掩码交叉熵,按 COMMIT 分解为三项:L_refine(精修条件 token,COMMIT 新引入)+ L_mask(预测 [MASK],即标准 MTM loss)+ L_recons(重建未掩码目标 token)。消融(Tab.5)显示三项叠加最佳:BAIR FP FVD 由 L_mask 单独 388 → L_mask+L_recons 51 → 全三项 48;MT8 FVD 143→53→33。
- 掩码调度:cosine γ(·)(先采每 token 分数 sᵢ
U(0,1),再采 rU(0,1) 取 ⌈γ(r)N⌉ 阈值)。 - 多任务训练:每步采样一个任务(10 选 1)及其 prompt,构造任务专属内部条件→COMMIT 掩码。
- Optimizer:Adam(β1=0.9, β2=0.96);峰值 lr 1e-4,linear warmup + cosine decay;weight decay 0.045;label smoothing 1e-4;max grad norm 1;hidden/attention dropout 0.1;batch 256。
- 推理(Algorithm 1,COMMIT 解码):K 步(典型 12 步)非自回归并行解码,从嵌入内部条件的多元掩码出发(而非 MaskGIT 的全 [MASK]),每步预测全部待定 token、保留高置信、对低置信加 Gumbel 噪声重掩码,按 γ(t/K) 递减掩码比例,逐步把条件 token 精修、把目标 token 填满。温度按数据集调(BAIR exp schedule T=400,Kinetics-600 uniform T=7.5)。
- 蒸馏/一致性加速:无——MAGVIT 的快是结构性的(短序列 1024 + 12 步并行解码),不依赖步数蒸馏。
Infra(训练 / 推理工程)
- 框架:JAX/Flax,TPU 训练;transformer 用 google/flaxformer,FVD 用 JAX 实现。基础设施由 Google Scenic 团队支持。
- 算力(附录 B.2,按 steps/sec 披露,未给总 GPU·时):
- 3D-VQ:B 版 0.41 steps/s on 16× TPU-v2;L 版 0.56 steps/s on 32× TPU-v4。
- Transformer:B 版 1.24 steps/s on 16× TPU-v2;L 版 2.70 steps/s on 32× TPU-v4。
- 每数据集单独训练一个模型(非联合大预训练)。
- 推理效率(核心卖点,Fig.5):16 帧 128×128 片段 12 步、单 TPUv4i 上 0.25 秒。
- GPU(单 V100)逐帧 runtime(Fig.5 折线,越长序列差距越大):MAGVIT-B 在 128×128(seq 1024)0.027s(37 fps) vs 自回归 transformer 1.60s;在 64×64(seq 256)MAGVIT 0.008s(125 fps)、AR 0.11s、扩散 ≫2.00s(图中扩散仅在 64×64 测;64×64 之外未测);192×144(seq 1728)MAGVIT 0.050s(20 fps)、AR 5.21s。即 AR 的 5.21s 是 192×144 处的值、扩散的 ≫2.00s 是 64×64 处的值,二者非同分辨率可比。
- TPUv4i:MAGVIT-B 190 fps,MAGVIT-L 65 fps。
- 比扩散快两个数量级(256–1000 步 vs 12 步),比 tats 自回归快 60×(逐 token 1024 步 vs 12 步),比并发的非自回归 MaskViT 快 4–16×(序列 1024 vs 4096,且步数更少)。
- 部署:随论文开源 JAX 代码 + checkpoint(github.com/google-research/magvit,CVPR 2023);提供 conda 环境(CUDA 11 / CuDNN 8.6),但官方注明”非 Google 官方支持产品”。
评测 benchmark(把效果讲清楚)
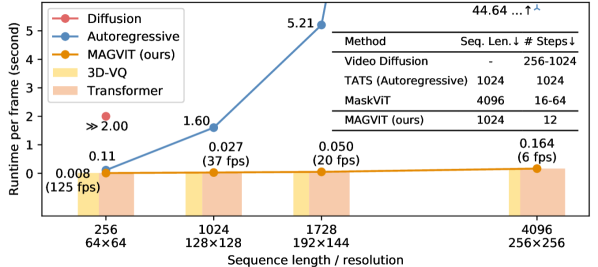
图源:Figure 5 “Inference-time generation efficiency comparison”,MAGVIT: Masked Generative Video Transformer (arXiv:2212.05199)
主指标 FVD(I3D on Kinetics-400 提特征),辅以 IS(C3D on UCF-101)、PSNR/SSIM/LPIPS。所有数字均 4 次运行均值±标准差。
类条件生成 · UCF-101(Tab.1,FVD↓ / IS↑)
- 前 SOTA:TATS 332 / 79.28;Make-A-Video(额外 10M 视频预训练)367。
- MAGVIT-B-CG:159 / 83.55;MAGVIT-L-CG:76 / 89.27 —— FVD 332→76(↓77%),IS 创新高。且仅用 UCF-101 的 9.5K 训练视频就超过预训练于额外 10M 视频的 Make-A-Video。
帧预测 · BAIR(Tab.2,FVD↓,括号为去偏 FVD)
- 前 SOTA:RaMViD 84、MCVD 90、NÜWA 87。
- MAGVIT-B-FP:76 (48);MAGVIT-L-FP:62 (31) —— 84→62(↓26%)。
- 图像质量(Tab.3):MAGVIT-L PSNR 19.3 / SSIM 0.787 / LPIPS 0.123,优于 CCVS、MCVD。
帧预测 · Kinetics-600(5 帧条件,Tab.2,FVD↓)
- 前 SOTA:Video Diffusion 16.2、RaMViD 16.5。
- MAGVIT-B-FP:24.5;MAGVIT-L-FP:9.9 —— 16.2→9.9(↓39%),大规模数据集上立新 SOTA。
多任务(Tab.4,FVD↓,均值跨全部任务)
- BAIR 8 任务(Tab.4 主文):MAGVIT-B-MT 平均 FVD 32.8、MAGVIT-L-MT 22.8(L-MT 各任务 FVD 多在 19–31)。单任务模型在未训练任务上显著退化(灰值,如 B-UNC 在 IPC 上 145.0、B-FP 在 OPC 上 247.1),多任务模型在所有任务上更好,甚至在 FP 上略超同尺寸单任务模型。
- SSv2 10 任务(Tab.12 附录):MAGVIT-B-MT 多任务平均 FVD 43.4,L 版 27.3;含 CG/CFP 两类条件任务。CFP 上 B-FP 单任务与 B-MT 多任务相当(同为 59.3),到 L 版多任务(CFP 28.5)才明显更优。
关键消融
- 条件建模方式(Tab.5):相同 3D-VQ 下,MaskGIT 式 latent masking(直接 unmask 条件区)FP FVD 74、MT8 151(泛化差,信息泄漏);prefix condition 序列变长不可控(55 / 训不收敛);COMMIT 定长 1024,FP 48 / MT8 33,全面最优。
- 解码方法(Tab.6,BAIR FP,FVD↓(括号去偏)):MaskGIT(2D-VQ,4096 len,12步) 222(177);MaskGIT(3D-VQ,1024,12步) 122(74);MaskViT(2D-VQ,4096,18步) 94*(原文引用值);AR(3D-VQ,1024,1024步) 91(56);MAGVIT(3D-VQ,1024,12步) 76(48)——质量最好且比 AR 少 85× 步数(1024 vs 12)、比 2D-VQ 短 4× 序列。
- tokenizer 架构 + 初始化(Tab.7,UCF-101 重建 FVD↓/IS↑):from scratch 下 MaskGIT 2D-VQ 240/80.9、TATS 3D-VQ 162/80.6、MAGVIT 3D-VQ-L 45/87.1;ImageNet central inflation 后 MAGVIT-L 降到 25/88.9。证明 3D-VQ 即便压缩率更高、参数更少,重建质量仍优于 2D-VQ,且更大模型 + central inflation 进一步大幅提升。
- 文生视频/text-to-video、人评 ELO/Arena、VBench、GenEval 等:本工作未报告(非文生视频、且早于 VBench)。
创新点与影响
核心贡献
- 首个面向视频的掩码多任务生成 transformer——一个训练好的模型推理时支持 10 种任务(帧预测/插帧、中心/垂直/水平/动态外画、中心/动态内画补全、类条件生成、类条件帧预测)。
- 高保真 3D-VQ 视频 tokenizer 设计(average pooling 下采样、镜像时空采样布局、reflect padding、小码本 1024、单深 3D 判别器、LeCam+r1 稳定 GAN、3D central inflation)——重建质量超 2D-VQ 与既有 3D-VQ,是 magvit-v2(“语言模型用 LFQ 无查找量化 + 更大码本击败扩散”)与 Open-MAGVIT2 直接的起点。
- COMMIT 多元掩码:把内部条件嵌进损坏 token,给出定长序列 + 正确因果掩码,三项损失(refine/mask/recons)协同。
- 在 UCF-101 / BAIR / Kinetics-600 三大基准刷新当时最佳 FVD,并兼具两个数量级的推理加速。
影响:确立”3D 视频 tokenizer + 非自回归掩码生成”为扩散之外的高效视频生成范式;MAGVIT tokenizer 家族(MAGVIT → magvit-v2 → Open-MAGVIT2)成为后续视频/统一多模态生成(含 token 化视频生成、世界模型、autoregressive 视频)广泛复用的视觉 tokenizer。作者 Lijun Yu / Lu Jiang / Huiwen Chang 等延续到 v2 与更大规模工作。
已知局限(作者明言或可见):
- 仅 16 帧短片段、≤128×128 分辨率;不做长视频、不做文生视频(无文本条件)。
- 每数据集单独训练,无统一大规模预训练 / scaling 结论。
- 码本 1024、4× 时间压缩相对保守,重建质量虽好但仍受 VQ 量化上界约束(v2 用 LFQ 大码本解决)。
- 未报告人评、未在文生视频通用基准上评测(受限于发表时间)。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2212.05199
- pdf: https://arxiv.org/pdf/2212.05199
- code (GitHub, 含 checkpoint 发布): https://github.com/google-research/magvit
- project page: https://magvit.cs.cmu.edu (demo/应用 gallery + benchmark 链接,已查阅:仅视频样例与外链,无论文之外的方法/数据/数字,故未单独落盘)
- 权重发布说明 (issue): https://github.com/google-research/magvit/issues/16
一手源存档(sources/)
- arxiv-2212.05199.pdf (论文全文 PDF,gitignore 不入库,本地已精读)
- readme.md (官方 GitHub README,含模型/FVD 发布表)