一句话定位
用一组可优化的各向异性 3D 高斯(显式、非神经)替代 NeRF 的隐式 MLP,配合可微的 tile-based 软光栅化器,首次在 1080p 全场景上做到 SOTA 画质 + 实时渲染(≥100 FPS)、训练只需几分钟到几十分钟——在 Mip-NeRF360 数据集上 30K 步达到 PSNR 27.21 / SSIM 0.815,渲染 134 FPS,而同等画质的 Mip-NeRF360 需 48 GPU·时训练、单帧 10 秒。SIGGRAPH 2023 论文,成为 2024 年后几乎所有 3D 生成(DreamGaussian / LGM / TRELLIS 系)的底层表示。
背景与定位
辐射场(radiance field)方法此前两条路线各有短板:
- 隐式神经路线(nerf、Mip-NeRF360)画质最高,但用大 MLP + 体渲染沿光线随机采样,训练 48 小时、渲染 0.06–0.14 FPS,远不能实时。
- 加速路线(InstantNGP 哈希网格 + 小 MLP、Plenoxels 稀疏体素)训练快(几分钟),但仍依赖体素/哈希这类结构化加速结构做 ray-marching,画质受网格分辨率限制,且渲染只能到 10–15 FPS 的交互级而非实时;空空间表示效率低。
3DGS 的核心论点是:连续表示并非高质量、快速辐射场训练的必要条件。它回到”点/网格”这种 GPU 友好的显式表示,但用”高斯椭球”取代固定大小的点,既保留体渲染(α-blending)可优化的好处,又能像点一样被高效投影光栅化、并自由地创建/销毁/移动几何。与传统 point-based / surfel 方法不同,它只需 SfM 稀疏点初始化(不需要 MVS 稠密几何),避免了 MVS 在弱纹理/反光/细结构上的过/欠重建伪影。它在技术脉络上是 EWA volume splatting(Zwicker 2001)+ Pulsar 球面光栅化(Lassner 2021)+ 神经点渲染(Kopanas 2021)三条线的工程化集大成,并把”体渲染图像形成模型”显式化为有序 α-blending。
模型架构
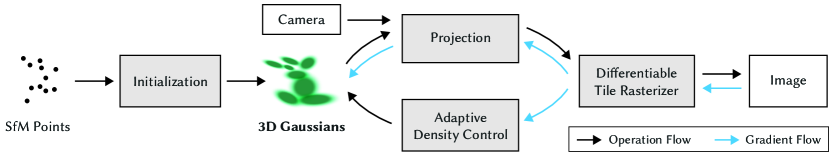
图源:Kerbl et al., “3D Gaussian Splatting for Real-Time Radiance Field Rendering” (SIGGRAPH 2023), Figure 2 — 优化 pipeline 总览(https://arxiv.org/abs/2308.04079)
不是神经网络——没有 MLP、没有 backbone、没有 text encoder/VAE/tokenizer。“模型”就是一组显式 3D 高斯参数集合(典型 1–5 百万个),每个高斯由以下可优化属性定义:
- 位置(均值 μ):世界坐标 3D 向量。
- 协方差 Σ(各向异性):定义椭球形状朝向。为保证优化中 Σ 始终半正定,不直接优化 Σ,而是分解为
Σ = R S Sᵀ Rᵀ,分别存缩放向量 s(3D)与旋转四元数 q(4D),优化时各自更新再组装(q 归一化为单位四元数)。 - 不透明度 α:经 sigmoid 激活约束到 [0,1)。
- 颜色 c:球谐(SH)系数,4 个 band(degree 0–3,含 0 阶共 16 个 SH 系数/通道 ×3 = 48 个 SH 系数),表达视角相关外观(view-dependent appearance)。
**渲染(图像形成模型)**与 NeRF 等价:沿像素累积 C = Σ Tᵢ αᵢ cᵢ,但用排好序的高斯做有序 α-blending 而非体渲染随机采样。3D 高斯投影到 2D:给定视变换 W,相机坐标协方差 Σ' = J W Σ Wᵀ Jᵀ(J 为投影仿射近似的 Jacobian),取左上 2×2 即得 2D 椭圆 splat。梯度全部手工推导(缩放 s、旋转 q 的解析导数,论文正文引为 appendix A 的”gradient computation”节给出完整公式),不走自动微分以避免训练开销。
核心架构创新——快速可微 tile-based 光栅化器(第 6 节 + 附录 C):
- 屏幕切 16×16 像素 tile;高斯按 99% 置信区间做视锥 + 逐 tile 剔除(极端位置用 guard band 直接剔除以免 2D 协方差计算不稳定)。
- 每个高斯按其覆盖的 tile 数实例化,给每个实例一个 64-bit key:低 32 位编码 view-space 深度、高位编码 tile ID。
- 用一次 GPU Radix sort(NVIDIA CUB)全局排序——没有逐像素排序,所有 splat 一次排好序后近似 α-blending(splat 接近单像素时近似误差可忽略)。
- 每个 tile 起一个 thread block,协作把高斯批量加载到 shared memory,逐像素 front-to-back 累积,α 饱和(→1)即该线程停止;整个 tile 全部像素饱和则终止。
- 反向传播无 splat 数量上限(不同于 Pulsar 只对前 N 个 splat 回传梯度):back-to-front 重新遍历 per-tile 列表,只存”前向结束时的累计不透明度”,反传时除以各高斯 α 即可恢复中间系数,避免存储任意长的 per-pixel 列表。数值稳定性上:跳过 α<1/255 的混合、α 上限 clamp 0.99、累计透明度超 0.9999 即停止包含新高斯。
数据
这是重建/反演方法,不是生成模型——没有大规模训练数据集。每个场景独立优化,输入是:
- 一组静态场景的多视角照片;
- 用 COLMAP(SfM, Schönberger & Frahm 2016)标定相机,并免费副产出一份稀疏点云作为高斯初始化(无需法线、无需 MVS 稠密点)。
评测用数据集(13 个真实场景 + 合成):
- Mip-NeRF360:全部 9 个室内外无界场景(bicycle/flowers/garden/stump/treehill/room/counter/kitchen/bonsai)。
- Tanks&Temples:Truck、Train 两场景。
- Deep Blending(Hedman 2018):DrJohnson、Playroom 两场景。
- 合成 Blender(NeRF-synthetic):8 个有界单物体场景,用 100K 随机初始化高斯(无背景、视角充分时随机初始化也能达 SOTA)。
train/test 划分沿用 Mip-NeRF360 约定:每第 8 张图作测试。合成场景用白背景。无 re-captioning / 美学过滤 / 安全过滤等生成式数据流程——不适用。
训练方法
逐场景优化(per-scene optimization),非两阶段预训练。核心是”渲染—比对—更新”循环 + 周期性自适应密度控制(adaptive density control),算法 1 给出完整伪代码:
优化目标(损失):L = (1−λ) L1 + λ L_D-SSIM,λ=0.2。用 Adam(标准 SGD 框架 + 自定义 CUDA 核)。激活函数:α 用 sigmoid、协方差 scale 用 exp。初始协方差设为各向同性,轴长 = 到最近 3 个点距离的均值。
自适应密度控制(关键 trick):
- 优化 warm-up 后每 100 步densify 一次,并剔除 α<阈值 ε_α 的近透明高斯。
- densify 判据:view-space 位置梯度均值 > τ_pos = 0.0002(欠重建与过重建区域都呈现大位置梯度)。
- 欠重建(小高斯)→ Clone:复制同尺寸高斯并沿位置梯度方向移动(增体积、增数量)。
- 过重建(大高斯,高方差区)→ Split:拆成两个,尺度除以实验定的 φ=1.6,用原高斯作 PDF 采样新位置(保体积、增数量)。
- 每 N=3000 步把所有 α 重置到接近 0:抑制相机近处 floater 堆积,让优化重新”挣回”真正需要的高斯,配合 culling 移除冗余。周期性移除世界空间过大、或 view-space footprint 过大的高斯。
- 高斯始终是欧氏空间原语,无需 NeRF 那种空间压缩/warp/投影处理远处物体。
渐进式策略:
- 分辨率 warm-up:以 1/4 分辨率起训,250 / 500 步各上采样一次。
- SH 逐 band 引入:先只优化 0 阶(漫反射基色),每 1000 步引入一个新 SH band,直到全部 4 band——避免角度信息不足时基色被优化坏。
- 位置用指数衰减学习率调度(init 1.6e-4 → final 1.6e-6,30K 步,delay_mult 0.01,仿 Plenoxels);scale_lr 5e-3、rotation_lr 1e-3(来自官方实现默认)。
- densify 区间默认 500→15000 步;总训练 7K(快速版)或 30K 步(完整版)。
无蒸馏/无步数蒸馏/无 RLHF/DPO——生成式扩散那套加速与对齐手段在此不适用。后续(2024.10 官方更新)集成 Taming-3DGS + fused-SSIM 的 drop-in 替换:--optimizer_type default 提速 ×1.6、sparse_adam 提速 ×2.7;并加入深度正则(depth regularization,来自 Hierarchical-3DGS,对 DeepBlending 等场景显著去 floater)、抗锯齿、曝光补偿——均为原方法之上的工程增量。
Infra(训练 / 推理工程)
- 硬件:所有结果在单张 NVIDIA A6000 上跑(Mip-NeRF360 基线为对比在 4×A100 节点跑 12h,折合单卡 48h)。训练大场景峰值显存可超 20 GB(作者称这是”未优化原型”,仅光栅化用 CUDA、优化逻辑仍在 Python,若像 InstantNGP 那样做底层优化可大幅降低——论文未给具体目标值)。官方实现要求 Compute Capability 7.0+ 的 CUDA GPU、24 GB 显存达到论文质量;推理 4 GB 显存即可。
- 实现:PyTorch + CUDA。光栅化是唯一用优化 CUDA 核实现的部分;其余优化逻辑仍在 Python(作者坦承 ~80% 训练时间花在 Python,全部移植到 CUDA 还能大幅提速)。排序用 NVIDIA CUB 的 Radix sort。配套开源 SIBR 交互式 viewer(OpenGL)测帧率。
- 训练时长(A6000,30K 步):Mip-NeRF360 约 41 分、Tanks&Temples 约 27 分、Deep Blending 约 36 分;7K 步快速版 4–7 分钟即达不错质量。
- 模型大小/显存:优化后参数 270–734 MB(按场景);渲染时除模型外另需 30–500 MB 给光栅器。相比 NeRF 系(InstantNGP 13MB、Mip-NeRF360 8.6MB)显存占用大得多——这是 3DGS 的主要代价,作者指出点云压缩技术可改善。
- 推理:实时光栅化,无需迭代采样;A6000 上真实场景 30K 配置 134(Mip360)/154(T&T)/137(DeepBlending)FPS,7K 配置更快(160/197/172);合成场景 180–300 FPS。
评测 benchmark(把效果讲清楚)
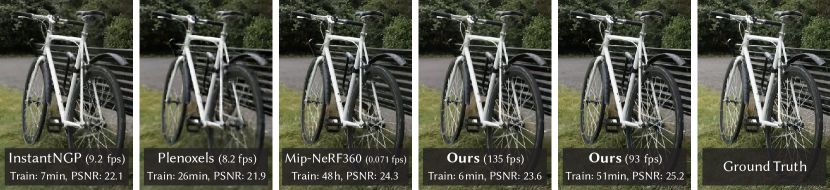
图源:Kerbl et al., “3D Gaussian Splatting for Real-Time Radiance Field Rendering” (SIGGRAPH 2023), Figure 1 — 画质等同 Mip-NeRF360 而渲染达实时(FPS / 训练时长对比)(https://arxiv.org/abs/2308.04079)
所有数字来自论文 Table 1–9(A6000,自跑各方法代码,Mip-NeRF360 数字直接采原论文)。指标 PSNR↑ / SSIM↑ / LPIPS↓。
Mip-NeRF360(9 场景平均,Table 1):
| 方法 | SSIM↑ | PSNR↑ | LPIPS↓ | Train | FPS | Mem |
|---|---|---|---|---|---|---|
| Plenoxels | 0.626 | 23.08 | 0.463 | 25m49s | 6.79 | 2.1GB |
| INGP-Base | 0.671 | 25.30 | 0.371 | 5m37s | 11.7 | 13MB |
| INGP-Big | 0.699 | 25.59 | 0.331 | 7m30s | 9.43 | 48MB |
| Mip-NeRF360 | 0.792† | 27.69† | 0.237† | 48h | 0.06 | 8.6MB |
| Ours-7K | 0.770 | 25.60 | 0.279 | 6m25s | 160 | 523MB |
| Ours-30K | 0.815 | 27.21 | 0.214 | 41m33s | 134 | 734MB |
→ Ours-30K 在 SSIM/LPIPS 上超过此前 SOTA Mip-NeRF360,PSNR 略低(27.21 vs 27.69),但训练快 ~70×、渲染快 ~2200×。
Tanks&Temples(2 场景平均):Ours-30K SSIM 0.841 / PSNR 23.14 / LPIPS 0.183 / 154 FPS,全面优于 Mip-NeRF360(0.759/22.22/0.257/0.14 FPS)。 Deep Blending(2 场景平均):Ours-30K SSIM 0.903 / PSNR 29.41 / LPIPS 0.243 / 137 FPS,与 Mip-NeRF360(0.901/29.40/0.245)持平而实时。 合成 Blender(8 场景平均 PSNR,Table 2):Ours-30K 33.32,与 INGP-Base(33.18)/Mip-NeRF(33.09)/Point-NeRF(33.30) 同档,随机初始化即可,最终每场景仅 200–500K 高斯。
消融(Table 3,PSNR)——逐一拆掉组件:
- Limited-BW(反传只对前 10 个 splat 给梯度,仿 Pulsar):Truck-30K 暴跌到 13.84(vs Full 24.81,掉 ~11 dB)——无上限梯度回传是画质关键。
- Random Init(不用 SfM 点):Average-30K 20.42 vs Full 26.05——SfM 初始化重要(真实场景,主要在背景退化、floater 增多)。
- No-Split:Average-30K 23.90;No-Clone:25.91;二者都掉但 split 对背景重建更关键,clone 对细结构收敛更快。
- Isotropic(去各向异性,只优化单标量半径):Average-30K 25.23 vs Full 26.05——各向异性让高斯贴合表面、表达细结构,显著提升质量。
- No-SH:Average-30K 25.35——SH 补偿视角相关效果,有正向贡献。
- Full:Average-30K 26.05(最高)。
压缩性对比:相比 Zhang 2022 的紧致 point-based 模型,3DGS 用约其 1/4 点数即超过其 PSNR,平均模型 3.8 MB vs 其 9 MB(此实验仅用 2 阶 SH)。
局限(论文第 7.4 节):弱观测区有伪影;可能产生拉长/斑驳高斯;偶有 popping 伪影(来自 guard band 粗剔除 + 简单可见性排序导致深度顺序突变,可用抗锯齿缓解);无任何正则化;超大场景(城市)需调低位置学习率才收敛;显存远高于 NeRF 系。
创新点与影响
核心贡献:
- 各向异性 3D 高斯作为高质量、非结构化、显式的辐射场表示(可优化、可微、可高效光栅化、自由增删几何)。
- 优化 + 自适应密度控制(clone/split/opacity-reset)从 SfM 稀疏点长出精确稠密表示。
- 快速可微 tile-based 光栅化器:visibility-aware、支持各向异性 splatting、反传无 splat 数上限,是训练与实时渲染共同提速的引擎。
影响:3DGS 把高质量辐射场从”小时级训练 + 秒级单帧”拉到”分钟级训练 + 实时渲染”,并证伪了”高质量辐射场必须用连续/神经表示”的主流观念。它迅速取代 NeRF 成为 2024 年后 3D 重建与3D 生成的事实标准底层表示——DreamGaussian、LGM、GaussianDreamer 等文本/图像到 3D 工作、以及后续 TRELLIS 时代的 3D 生成 pipeline 大量以 3DGS 为输出/中间表示;衍生出动态 4DGS、SLAM、抗锯齿(Mip-Splatting)、表面重建(2DGS/SuGaR)、压缩、城市级 Hierarchical-3DGS 等庞大生态。论文获 SIGGRAPH 2023 最佳论文级关注,是近年计算机图形学引用增长最快的工作之一。
已知局限:见上节——显存大、对未观测区/反光/popping 仍有伪影、无正则化、超大场景需调参。这些短板正是后续大量改进工作的切入点。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2308.04079
- paper (arXiv pdf): https://arxiv.org/pdf/2308.04079
- project page (Inria GRAPHDECO,含视频/评测图/高清 PDF): https://repo-sam.inria.fr/fungraph/3d-gaussian-splatting/
- code (官方实现 GitHub): https://github.com/graphdeco-inria/gaussian-splatting
- DOI (ACM TOG 42(4)): https://doi.org/10.1145/3592433
一手源存档(sources/)
- arxiv-2308.04079.pdf (arXiv 原文 PDF,不入 git)
- readme.md
- project.md