一句话定位
DreamFusion 提出 Score Distillation Sampling (SDS)——把一个冻结的 2D 文生图扩散模型(Imagen 64×64 base)当作”评论家”,对一个随机初始化的 NeRF 做逐 prompt 优化,使其任意视角的渲染图在扩散模型眼里都像高概率样本,从而不用任何 3D / 多视角训练数据就能生成可重打光、可任意视角观看的 3D 物体。在 object-centric COCO 上 CLIP L/14 R-Precision(彩色渲染)达 79.7%、纹理无关几何渲染达 58.5%,全面超过 Dream Fields / CLIP-Mesh,并开创了影响后续几乎全部 SDS 类工作的”2D 先验蒸馏 3D”范式。
背景与定位
2022 年文生图已被 ddpm 类扩散模型推到很高水平(Imagen、dall-e-2、GLIDE),但把扩散直接搬到 3D 行不通:既缺大规模带标注的 3D 资产数据集,也没有高效的 3D 去噪架构。已有的零样本文生 3D 工作(Dream Fields、CLIP-Mesh)依赖 CLIP 做 image-text 对齐损失去优化 NeRF/mesh,几何质量差(纹理常被”画”在扁平面上)。
DreamFusion 的核心 insight 是:不要训练 3D 生成模型,而是把已训练好的 2D 扩散模型当成可微分先验,用它的 score 去监督一个可微分图像参数化(DIP)的优化。这里 DIP 取 NeRF(体渲染把 3D 参数 θ 映射成 2D 图像 x = g(θ)),扩散模型则提供”这张图像合不合理”的梯度。这条路线相对前作的三点根本改进:(1) 把弱的 CLIP 对齐先验换成强得多的扩散生成先验;(2) 提出 SDS,绕过对扩散模型 U-Net 的反向传播,使整个流程高效且无需改动扩散模型;(3) 配一套 NeRF 渲染 + 光照 shading + 几何正则,让几何(而非贴图)真正立体。它是 score-based diffusion 思想在生成式优化上的一次关键迁移。
模型架构
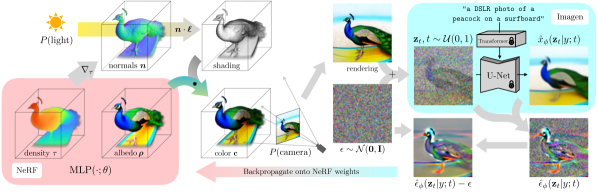
图源:DreamFusion: Text-to-3D using 2D Diffusion (arXiv:2209.14988) Figure 3
DreamFusion 没有可训练的”模型权重”产物——每个 prompt 都从零训一个 NeRF,扩散模型全程冻结。两个组件:
(1) 冻结的 2D 扩散先验。 直接用 Imagen 的 64×64 base 文生图模型(Saharia et al. 2022),不用其超分级联,原封不动、无任何 fine-tune。文本编码用 T5-XXL embedding 条件。它在训练期只作为”评论家”输出噪声预测 ε̂φ(z_t|y;t),不接收梯度。
(2) 可优化的 NeRF(DIP)。 在 mip-NeRF 360(Barron 2022,比 NeRF 抗锯齿)基础上改造:
- MLP:5 个 ResNet block × 128 隐藏单元,Swish/SiLU 激活,block 间 LayerNorm;密度 τ 用 exp 激活,RGB 反照率(albedo)ρ 用 sigmoid,即 (τ, ρ) = MLP(µ; θ)。
- Shading(关键设计):不像传统 NeRF 直接发出与视角相关的 radiance,而是输出材质 albedo,再由自带控制的光照做着色。法向量 n 由密度梯度取负归一化得到 n = −∇µτ/‖∇µτ‖;用 Lambert 漫反射 c = ρ∘(ℓρ∘max(0, n·(ℓ−µ)/‖ℓ−µ‖)+ℓa) 渲染。以一定概率把 albedo 换成纯白(textureless render),逼模型把内容刻进几何而非画在平面上——这是几何能立体的核心 trick。
- 积分位置编码 + 协方差退火:沿用 mip-NeRF 的 integrated positional encoding(L=8 频率),协方差 Σ=λΣ²I3,λΣ 在前 5k 步从 5e-2 线性退火到 2e-3,实现 coarse-to-fine。
- 场景结构:NeRF 只在固定包围球(半径 1.4)内查询;背景由第二个 MLP(输入位置编码的射线方向)生成 environment map,按累积 alpha 合成,防止密度堆在相机前。
- 空间密度先验 blob:优化早期在原点加一个高斯密度 blob(λτ=5, στ=0.2),把内容聚到中心。
参数量/分辨率:渲染分辨率仅 64×64(受限于所用 Imagen base 分辨率),NeRF MLP 很小(5×128)。这也是其细节有限的根因。
数据
DreamFusion 本身不训练、不使用任何 3D 数据,也不重新收集图文数据——这正是它的卖点(“requires no 3D training data”)。所用数据全部来自冻结的 Imagen base 模型在预训练阶段见过的大规模 web image-text 数据(论文原文:“trained on large-scale web-image-text data”,并在 Ethics 段提到 Imagen 数据含经部分过滤的 LAION-400M 子集)。Imagen 训练数据的来源/规模/配比/清洗细节未在本文披露(属 Imagen 论文范畴)。评测用 prompt 取自 Dream Fields 的 object-centric COCO 验证子集的 153 条 caption。
训练方法
核心损失 SDS(Score Distillation Sampling)。 对 x = g(θ) 注入对应时间步 t 的噪声得 z_t,让冻结扩散模型预测噪声 ε̂φ(z_t;y,t),梯度直接取噪声残差乘生成器雅可比:
∇θ L_SDS = E_{t,ε}[ w(t) (ε̂φ(z_t;y,t) − ε) ∂x/∂θ ]
关键在于省去 U-Net 雅可比项 ∂ε̂/∂z_t:作者发现该项计算昂贵(要反传扩散 U-Net)且在小噪声下病态;扔掉后得到一个稳定有效的更新方向。论文在附录证明这正是一个加权概率密度蒸馏(probability density distillation)损失的梯度,等价于最小化 E_t[σ_t/α_t·w(t)·KL(q(z_t|g(θ);y,t) ‖ pφ(z_t;y,t))](mode-seeking 的反向 KL)。直觉上:扩散模型当”冻结的、高效的 image-space 编辑评论家”,DreamFusion 只在参数空间 SGD,不反传扩散模型。
每步优化循环(共 15,000 步):
- 随机采样相机(球坐标:仰角 φ∈[−10°,90°]、方位 θ∈[0°,360°]、距离[1,1.5])与点光源;
- 64×64 渲染 NeRF,随机在”带光照渲染 / textureless / 纯 albedo”三者间选一种;
- view-dependent prompting:按相机方位给 prompt 追加 “front/side/back/overhead view”(仰角>60°用 overhead,否则按方位插值 front/side/back,取最近方位的 text embedding),缓解”多面狗”这类几何崩坏;
- 采 t∼U(0.02,0.98)(避开极端噪声防数值不稳),加噪、算 ε̂、按 SDS 公式回传到 NeRF 参数。
关键超参 / trick:
- CFG guidance ω = 100(远大于普通图像采样的 ~7.5)——mode-seeking 目标在小 guidance 下会过平滑,必须大 guidance;
- 权重 w(t)=σ_t²,但作者称均匀权重表现相似;
- 优化器:Distributed Shampoo(β1=0.9, β2=0.9, exponent override=2, block size=128, graft=SQRT_N, ε=1e-6),lr 在前 3000 步从 1e-9 线性 warmup 到 1e-4 再 cosine 衰减到 1e-6(长 warmup 显著改善几何一致性);
- 几何正则:Ref-NeRF orientation loss(权重~1e-2,前 5k 步从 1e-4 退火,让法向朝向相机防”背面”)+ 累积 alpha/opacity 正则(~1e-3)防填满空域、改善前后景分离;shading 早期 1k 步关闭漫反射(纯 ambient),之后 75% 概率开漫反射、其中 50% 用 textureless。
无蒸馏/无 SFT/无 RLHF:这是一个纯优化方法,不存在多阶段预训练/偏好对齐/步数蒸馏等流程。
Infra(训练 / 推理工程)
- 硬件:每个 3D 场景在**一台 TPUv4 机器(4 chips)**上优化;每个 chip 渲染一个独立视角并评估扩散 U-Net,per-device batch size = 1(即等效 4 视角/步)。
- 耗时:15,000 步约 1.5 小时/prompt;计算时间在”渲染 NeRF”与”评估扩散模型”之间大致各占一半。
- 效率关键:SDS 不反传扩散 U-Net,使每步只需一次扩散前向 + NeRF 前后向,是该方法可行的工程前提。
- 推理/部署:无独立”推理”形态——生成即优化,产物是一个训练好的 NeRF(可导出网格、视频,项目页提供可加载的 3D 模型与 mesh)。未披露量化/缓存/步数蒸馏等加速(彼时尚无;后续 SDS 加速由 LCM/一致性等后继工作完成)。
评测 benchmark(把效果讲清楚)
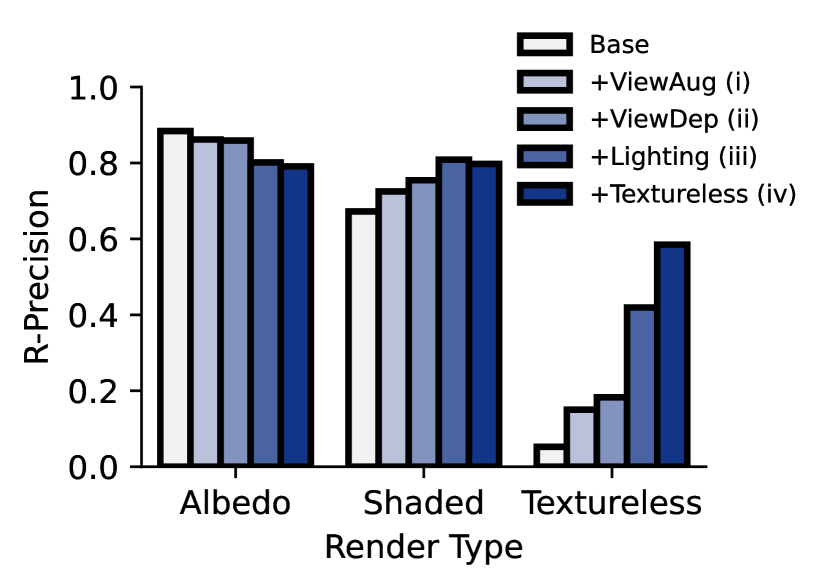
图源:DreamFusion: Text-to-3D using 2D Diffusion (arXiv:2209.14988) Figure 6 (left)
评测用 CLIP R-Precision(用 CLIP 从 153 条 object-centric COCO caption 中检索回正确 caption 的准确率),分别在彩色(Color)渲染和纹理无关(Geo,textureless)几何渲染上各测一次(后者专门评几何质量,因为带贴图的扁平几何会虚高)。Table 1(CLIP L/14,主指标):
| 方法 | Color R-Prec ↑ | Geo R-Prec ↑ |
|---|---|---|
| GT 真实图像(oracle,B/16 79.1) | — | — |
| CLIP-Mesh | 74.5† | — |
| Dream Fields(论文)B/16 | 74.2 | — |
| Dream Fields(作者增强重实现) | 82.9 | 1.4(近随机) |
| DreamFusion | 79.7 | 58.5 |
- 在 CLIP B/32:DreamFusion 75.1(Color)/42.5(Geo);CLIP B/16:77.5 / 46.6。
- 核心对比结论:Dream Fields / CLIP-Mesh 因训练就用 CLIP,对 CLIP 评测有”不公平优势”,但 DreamFusion 在彩色上仍超过它们、逼近真实图像 oracle;而 Dream Fields 的几何评分近乎随机(1.4%),DreamFusion 几何达 58.5%,几何质量是质变。
- 消融(Fig.6, CLIP L/14):从 Base 起逐项加入 ViewAug(大视角范围)→ ViewDep(视角相关 prompt)→ Lighting(带光照渲染)→ Textureless(纹理无关几何渲染),几何随每一项显著改善,全渲染整体 +12.5%。论文强调 albedo 渲染会”骗人”:Base 的 albedo 分最高却几何崩坏(多头狗);要拿到正确几何必须靠 view-dependent prompt + 光照 + textureless 三件套。
注:本文未报告 FID / GenEval / T2I-CompBench / 人评 ELO 等指标(这些是后来才标准化的 2D/编辑评测,且本任务无 ground-truth 3D,作者明确指出 Chamfer/PSNR 等参考式指标不适用)。
创新点与影响
核心贡献:
- Score Distillation Sampling (SDS):把扩散模型的 score 当作可微分先验,在任意可微参数空间(不止 3D)用优化做采样,且不反传扩散模型——理论上证明其为加权概率密度蒸馏(反向 KL)的梯度。
- 零 3D 数据的文生 3D 范式:只用冻结 2D 扩散先验 + 一套 NeRF 渲染/光照/几何正则,生成可重打光、任意视角、可导出 mesh 的 3D 物体。
- 几何质量的工程配方:view-dependent prompting + Lambert shading + textureless 渲染 + 大 CFG(100) + 几何正则,系统性解决”内容画在平面/多面”病态。
影响:SDS 成为后续几乎所有 text-to-3D 工作的基石——Magic3D(高分辨率两阶段)、Fantasia3D、ProlificDreamer(VSD 修正 SDS 的过饱和/低多样性)、DreamGaussian / GaussianDreamer(换 3D Gaussian Splatting 表示)、以及 SDS 在图像编辑、纹理生成、4D 等方向的大量衍生,均直接源自本文。(同期另有 Point-E 走”文生图+图到点云扩散”的前馈快速路线,与 SDS 优化路线形成对照。)
已知局限(作者明确列出):
- 过饱和、过平滑:SDS 用于图像采样不是完美损失,结果比 ancestral sampling 更饱和更平滑;动态阈值在 NeRF 语境下不能根治。
- 低多样性:源于反向 KL 的 mode-seeking 特性,不同随机种子 3D 结果差异很小。
- 细节有限:仅用 64×64 Imagen base,分辨率低;用更高分辨率扩散 + 更大 NeRF 可改善但会慢到不可行。
- 3D 从 2D 重建的本质病态:同一组 2D 图像对应无数 3D 世界,优化高度非凸,仍偶现”内容画在单一平面”的局部最优。
- 伦理:继承 Imagen 的数据偏见;3D 假信息可能比 2D 更具迷惑性。
原始链接
- arxiv_abs: https://arxiv.org/abs/2209.14988
- arxiv_pdf: https://arxiv.org/pdf/2209.14988
- project_page: https://dreamfusion3d.github.io/
一手源存档(sources/)
- arxiv-2209.14988.pdf (arXiv 原文 PDF,不入 git)
- arxiv-abs.md
- project-page.md