一句话定位
DALL·E 2(论文名 unCLIP)用「CLIP 图像 embedding 作为中间表征」把文生图拆成两段——prior(文本→CLIP 图像 embedding)+ 扩散 decoder(CLIP 图像 embedding→图像),在保持与 glide 相当的逼真度的同时显著提升了生成多样性,MS-COCO 256×256 零样本 FID 10.39(diffusion prior)刷新当时 SOTA;产品版分辨率较 DALL·E 1 提升 4×(到 1024×1024),并在 OpenAI 评测中以 71.7% 文本匹配 / 88.8% 逼真度 的偏好率压过 DALL·E 1,是 2022 年引爆公众 AIGC 关注的标志性工作。
背景与定位
2021–2022 年文生图有三条主线:自回归 token 路线(dall-e-1、CogView)、GAN 路线(AttnGAN/XMC-GAN)、以及刚兴起的扩散路线(glide、latent-diffusion-ldm)。OpenAI 自家的 glide 已证明「文本条件扩散 + classifier-free guidance」能产出高逼真图,但 guidance 在提升保真度的同时会牺牲多样性(语义随 guidance 升高而坍缩)。
unCLIP 的核心洞察是:把 clip(对比学习得到的图文联合表征)的图像 embedding 当成显式的中间变量。生成被分解为 P(x|y) = P(x|z_i, y)·P(z_i|y),先用 prior 从文本 y 采样 CLIP 图像 embedding z_i,再用 decoder 把 z_i「反演」成图像 x——因此叫 unCLIP(inverting the CLIP image encoder)。把语义「冻结」在 z_i 里,使得 decoder 端即便用高 guidance 提升画质,场景语义也不坍缩,从而在同等逼真度下保留更高多样性。CLIP 的图文同空间还顺带解锁了零样本的图像变体、插值、文本引导编辑(text diffs)等能力。相对 GLIDE 的改进可一句话概括:用 CLIP 隐空间换来更好的「多样性-保真度」权衡 + 一组图像操纵能力。
模型架构
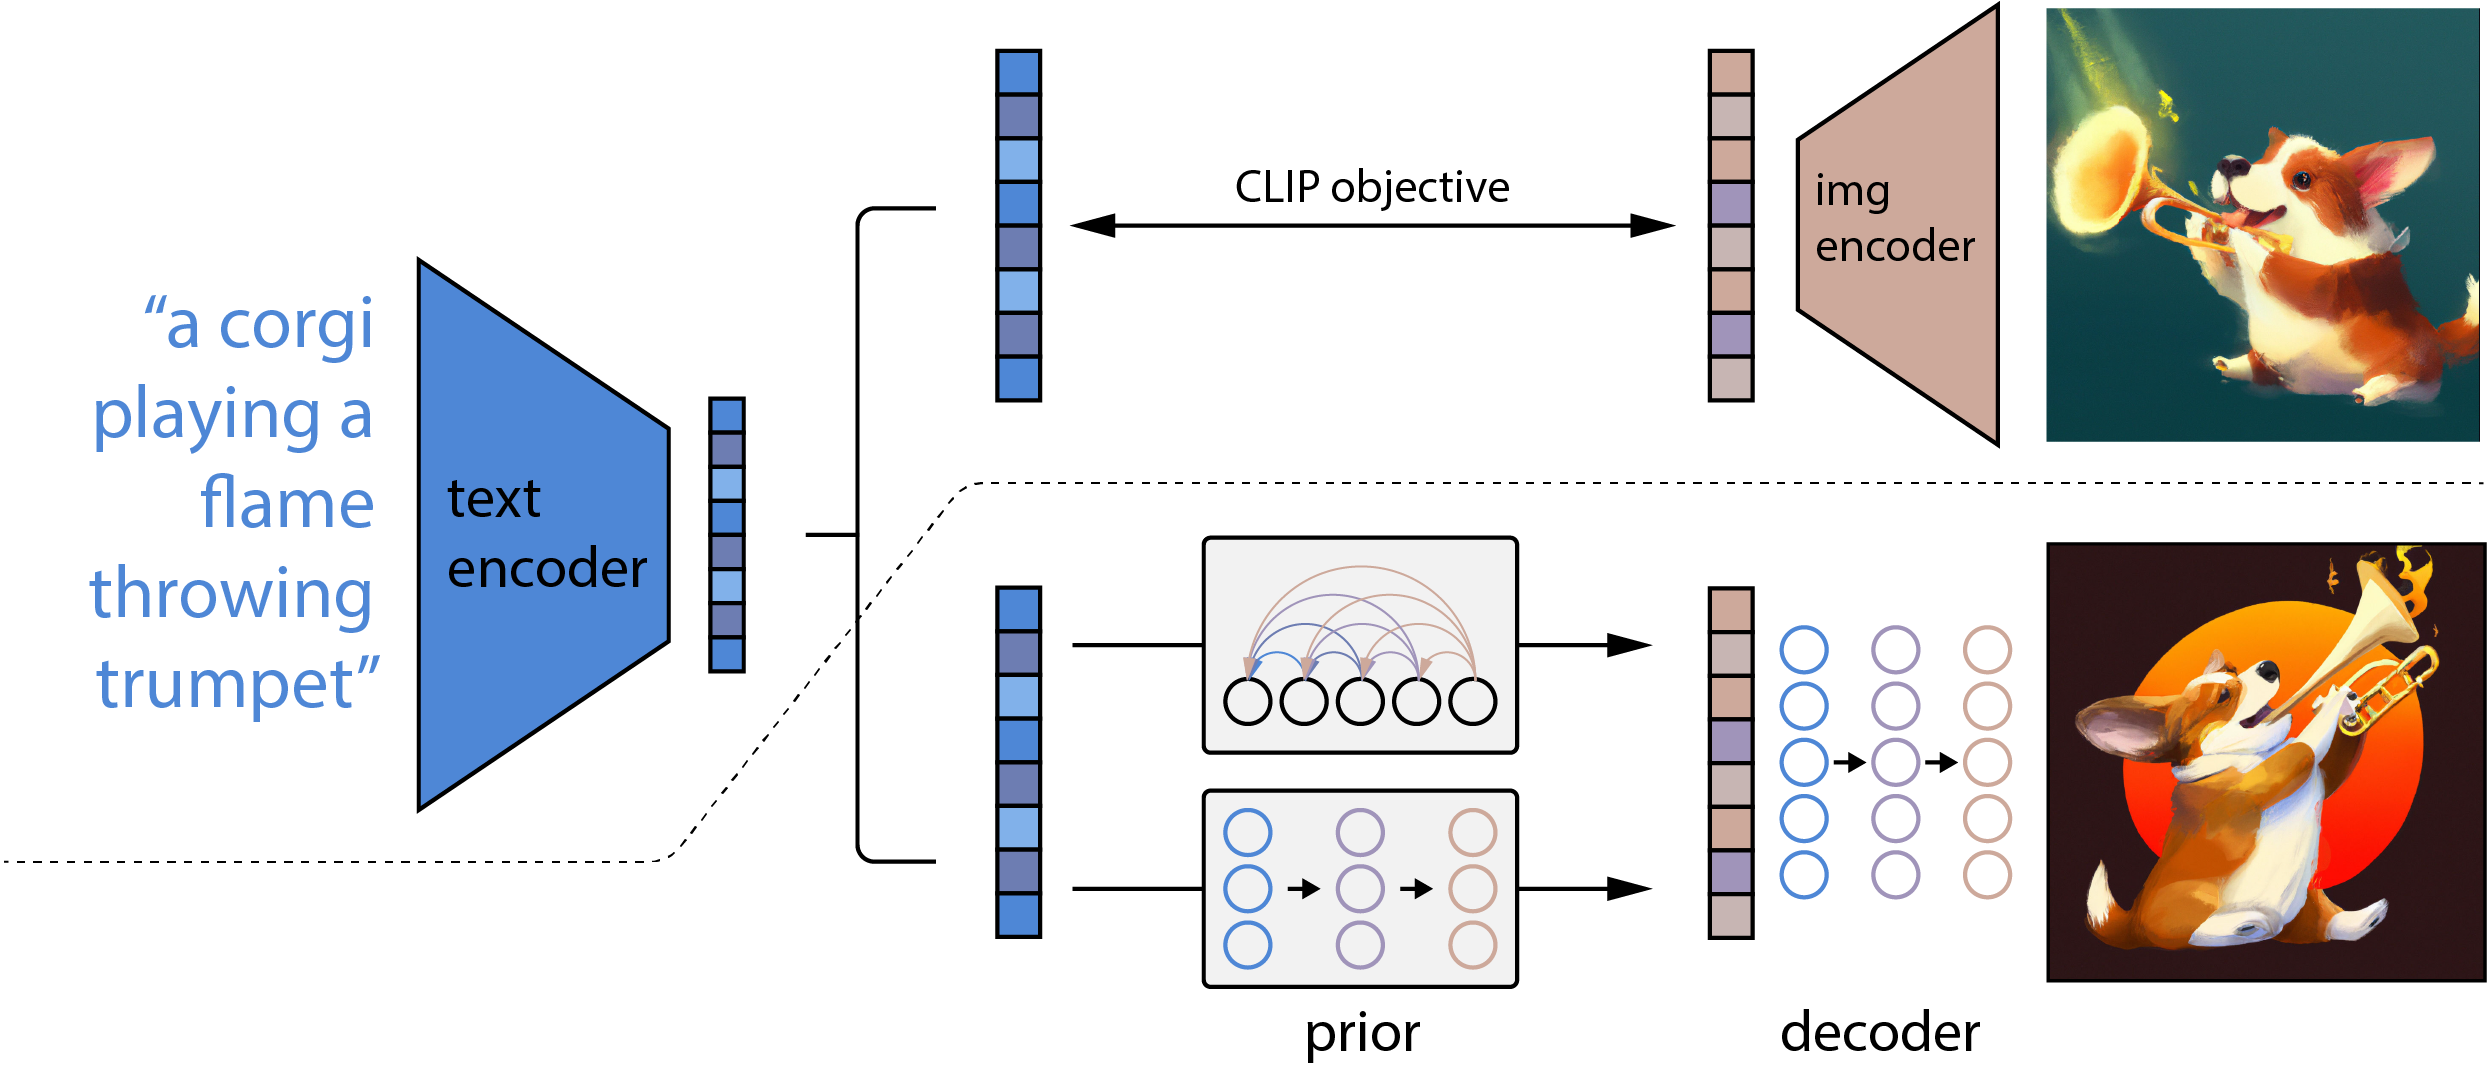
图源:Ramesh et al., “Hierarchical Text-Conditional Image Generation with CLIP Latents” (arXiv:2204.06125) Figure 2 — A high-level overview of unCLIP
整套生成栈 = CLIP(冻结)+ Prior + Decoder + 两级上采样器,全部为扩散/Transformer,无 GAN、无 VAE 隐空间(像素域扩散)。
- CLIP(冻结,作表征 backbone):图像编码器为 ViT-H/16,输入 256×256,width 1280、32 个 Transformer block;文本编码器为带因果 mask 的 Transformer,width 1024、24 block。训练时用 SAM(Sharpness-Aware Minimization,ρ=0.1)——论文发现用 SAM 训练的 CLIP 其表征空间的「秩」大幅下降(1024 维实际只需 319 个主成分即可保留 >99% 信息),这是后面 AR prior 能 token 化的前提。CLIP 在 prior/decoder 训练期间全程冻结。
- Decoder(CLIP 图像 embedding → 64×64 图):在 GLIDE(3.5B 参数) 的 U-Net/ADMNet 架构上改造——把 CLIP embedding 投影后加到 timestep embedding 上,并投影成 4 个额外 token 拼接到 GLIDE 文本编码器输出序列里作为上下文。保留了 GLIDE 原有的文本条件通路(猜想能补 CLIP 抓不到的变量绑定,实测帮助有限)。用 classifier-free guidance:训练时 10% 概率把 CLIP embedding 置零、50% 概率丢掉文本 caption(论文 §2.1 给 10%;§5.1/Fig 8 又写 5%,属原文自相矛盾,此处采 §2.1)。
- Prior(文本 → CLIP 图像 embedding):两种实现对比,
- AR prior:先对 z_i 做 PCA 降到 319 维、按特征值排序、每维量化成 1024 个 bucket,再用带因果 mask 的 Transformer 自回归预测这串离散码(约 1B)。token 数因 PCA 降到 1/3,训练更稳。条件 = 文本 + CLIP 文本 embedding(作前缀),并额外 prepend 一个量化后的 z_i·z_t 点积 token(点积越高说明 caption 越贴合图像,采样时取分布上半部)。
- Diffusion prior:decoder-only Transformer(width 2048、24 block,约 1B),在「编码后的文本 + CLIP 文本 embedding + 时间步 embedding + 加噪的 CLIP 图像 embedding + 一个用于输出预测的 embedding」序列上做高斯扩散。关键 trick:不用 ε-prediction,而是直接预测干净的 z_i,用 MSE 损失;采样时生成 2 个 z_i 候选、取与 z_t 点积更高的那个。
- 论文结论:diffusion prior 在同等模型规模、更少训练算力下全面优于 AR prior。
- 两级扩散上采样器(ADMNet,无 attention):64→256(700M)和 256→1024(300M),均为无条件(不吃 caption,guidance 也不用)。为提升鲁棒性,对条件图做退化增广——第一级用高斯模糊,第二级用更激进的 BSR degradation(来自 LDM)。为省算力在目标尺寸 1/4 的随机裁剪上训练、推理时直接套到目标分辨率(只用空间卷积,可泛化到高分辨率)。
整体是像素域、级联式(cascaded)扩散,64×64 基础分辨率 → 逐级上采样到 1024×1024。
数据
- 来源:图文对,来自「公开可得来源 + OpenAI 自行许可(licensed)的来源」的组合(system card 原文)。论文未给出爬取细节,但属内部数据集,非公开数据集。
- 规模(论文 Appendix C 明确给出):
- 训练 CLIP 编码器时,从 CLIP 数据集与 DALL·E(DALL·E 1)数据集等概率采样,合计约 6.5 亿(650M)张图。
- 训练 decoder / 上采样器 / prior 时,只用 DALL·E 数据集(约 2.5 亿 / 250M 图)——论文实测:把更「噪」的 CLIP 数据集混进生成栈训练会损害样本质量。
- 过滤/清洗:论文版未细述;system card + DALL·E 2 pre-training mitigations 博客披露了产品/部署相关的过滤——从训练数据中移除最露骨的性/暴力内容与部分仇恨符号(比 GLIDE 时「移除所有含人图像」的激进过滤温和,因 GLIDE 小模型要开源、风险更高)。内部审计发现:早期性内容过滤意外减少了女性图像的生成量,遂调整过滤策略(一个典型的「过滤引入偏差」案例)。
- 生产版数据:论文注明产品版 unCLIP 在更大、且按美学质量与安全过滤后的数据集上训练更久,并改了架构以支持 inpainting、防止非预期记忆(memorization)。具体规模/配比未披露。
- 合成数据/re-caption:本作未使用(re-captioning 是后来 DALL·E 3 的核心,DALL·E 2 阶段尚无)。
训练方法
- 训练目标:全栈基于高斯扩散 / DDPM(ddpm)。decoder 与两级上采样器为标准像素域扩散(decoder 用 learned-sigma);diffusion prior 用「直接预测干净 z_i 的 MSE 损失」而非预测噪声。AR prior 为离散 token 的自回归交叉熵。
- 多阶段:CLIP 预训练(冻结)→ 分别独立训练 decoder、两级上采样器、prior。无 SFT / RLHF / DPO / reward model——这是 2022 年纯生成式方法,偏好对齐与 RL 不在本作范畴。
- guidance:decoder 与两个 prior 都启用 classifier-free guidance(训练期随机丢条件:decoder 丢 CLIP embedding 10%、丢文本 50%;prior 丢文本条件 10%)。论文核心实验结论之一:guidance 对 unCLIP 的多样性/FID 损害远小于 GLIDE,因为语义被冻结在 z_i 里,decoder 加 guidance 只改画质不改语义。
- 关键超参(Appendix C,Adam + 修正权重衰减,β1=0.9):
- decoder 3.5B:扩散步 1000、cosine schedule、batch 2048、80 万步、lr 1.2e-4、采样 250 步(strided)。
- diffusion prior 1B:batch 4096、60 万步、lr 1.1e-4、采样用 Analytic-DPM 仅 64 步;为复用 Dhariwal&Nichol 的图像噪声调度,把 CLIP embedding 输入乘以 17.2 以匹配 ImageNet RGB 像素的经验方差。
- AR prior 1B:batch 4096、100 万步、lr 1.6e-4。
- 上采样器:64→256(700M,batch 1024,100 万步,DDIM 27 步);256→1024(300M,batch 512,100 万步,DDIM 15 步)。
- 加速:推理侧靠 DDIM + Analytic-DPM 把采样步数压低(prior 64 步、64→256 仅 27 步、256→1024 仅 15 步)。本作未做 consistency/LCM/ADD/步数蒸馏(那些是后续工作)。
Infra(训练 / 推理工程)
- 论文致谢明确感谢 OpenAI 的 Acceleration 与 Supercomputing 团队提供软硬件基础设施,但未披露 GPU 型号、卡数、GPU·时、并行策略、混合精度、吞吐等任何具体算力数字。
- 可从超参间接读出训练规模量级:prior/decoder 用 batch 2048–4096、60万–100万步,属当时大规模训练;具体集群配置未公开。
- 部署形态:先以 DALL·E 2 Preview(受限可信用户、非商用)形式上线,2022 年 7 月转 beta,9 月取消 waitlist,11 月开放 API(产品迭代信息来自官方博客)。推理通过受控 API/网页提供,叠加 prompt/上传图像过滤与人工+自动监控。
评测 benchmark(把效果讲清楚)
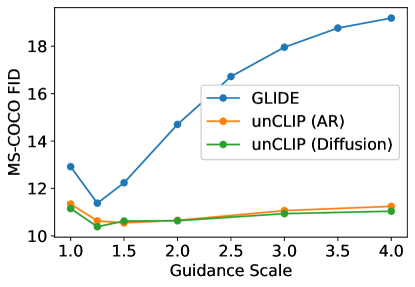
图源:Ramesh et al., arXiv:2204.06125 Figure 11 — FID versus guidance scale for unCLIP and GLIDE(unCLIP 在低 FID 区间显著优于 GLIDE)
(数字均来自已抓取的一手源:论文 ar5iv 全文 + OpenAI 产品博客)
- MS-COCO 256×256 零样本 FID(论文 Table 2,decoder guidance scale 1.25):
- unCLIP(diffusion prior)= 10.39(filtered 10.87),unCLIP(AR prior)= 10.63(filtered 11.08)。
- 对比:GLIDE 12.24、Make-A-Scene 11.84(filt)、LAFITE 26.94、DALL-E 1 ≈ 28。unCLIP diffusion prior 为当时零样本 SOTA。
- 人评 vs GLIDE(论文 Table 1,报告 unCLIP 胜过 GLIDE 的概率,95% CI):
- diffusion prior:逼真度 48.9%±3.1%、文本匹配 45.3%±3.0%、多样性 70.5%±2.8%。
- AR prior:逼真度 47.1%、文本匹配 41.1%、多样性 62.6%。
- 解读:逼真度与 GLIDE 基本持平(略低、差距很小),文本匹配略逊,但多样性碾压——这正是 unCLIP 的卖点。
- diversity-fidelity 权衡(论文 Fig 10/11):扫 guidance scale 时,guidance 对 unCLIP 的 FID 损害远小于 GLIDE;GLIDE 需把 guidance 降到 2.0 才接近 unCLIP 的逼真度+文本匹配,但仍不及其多样性。
- prior 必要性消融(§5.1):小模型对比,「CLIP 文本-embedding decoder / 完整 unCLIP / 把文本 embedding 零样本喂给 unCLIP decoder」FID 分别 9.16 / 7.99 / 16.55——完整 unCLIP 最佳;人评中完整栈在逼真度 57.0%±3.1%、文本匹配 53.1%±3.1% 上胜过只用文本 embedding 的 decoder。
- 美学质量(§5.5):用 GPT-3 生成 512 条「艺术化」prompt + 在 AVA 数据集上训的 CLIP 线性探针打分;guidance 对 GLIDE、unCLIP 的美学分都有提升,但只有 unCLIP 在提升美学的同时不掉 Recall(不牺牲多样性)。
- 产品版 vs DALL·E 1(OpenAI 产品博客):评估者偏好——71.7% 认为 DALL·E 2 文本匹配更好、88.8% 认为更逼真;分辨率较 DALL·E 1 提升 4 倍。
创新点与影响
核心贡献
- unCLIP / prior-decoder 两段式范式:首次把 CLIP 图像 embedding 作为文生图的显式中间表征,并系统比较 AR 与 diffusion 两类 prior,证明 diffusion prior 更优更省。
- 解耦语义与画质:把语义冻结进 CLIP embedding,使 decoder 端 guidance 只升画质不坍缩语义,给出比 GLIDE 更好的「多样性-保真度」权衡。
- 零样本图像操纵套件:基于 CLIP 同空间 + DDIM 反演的 bipartite 表征 (z_i, x_T),免训练实现图像变体、球面插值、文本引导编辑(text diffs),并能反向「可视化 CLIP 看到了什么」(如对 typographic attack 仍能还原苹果)。
- 级联像素扩散 + Analytic-DPM 少步采样的工程组合,把 1024×1024 高分辨率生成做到可部署。
影响:DALL·E 2 是 2022 年 AIGC 出圈的引爆点,直接推动了 Stable Diffusion(latent-diffusion-ldm)开源浪潮与整个文生图生态;其「prior+decoder」思想、CLIP 条件、级联扩散被后续大量工作借鉴或对照。但 unCLIP 这条「先生成 CLIP embedding」的具体路线后来并非主流——LDM/SDXL/SD3 等转向潜空间扩散 + T5/CLIP 直接条件,OpenAI 自家 DALL·E 3 也改走「合成 caption + 直接文本条件」。
已知局限(论文 §7):
- 属性绑定差:unCLIP 比 GLIDE 更难把多个属性绑到多个物体(如「红方块叠在蓝方块上」常串色),因为 CLIP embedding 本身不显式绑定属性-物体。
- 难以渲染连贯文字(拼写信息未被 CLIP embedding 精确编码,BPE 又掩盖了拼写)。
- 复杂场景细节不足——源于 64×64 基础分辨率再上采样的级联设计,提高基础分辨率可缓解但增算力。
- 逼真度提升也抬高了滥用/伪造风险,故采取受限预览 + 多层过滤的分阶段部署。
原始链接
- arxiv_abs: https://arxiv.org/abs/2204.06125
- arxiv_pdf: https://arxiv.org/pdf/2204.06125
- paper_html(ar5iv 全文): https://ar5iv.labs.arxiv.org/html/2204.06125
- blog(产品页): https://openai.com/index/dall-e-2/
- blog(研究发布页): https://openai.com/index/hierarchical-text-conditional-image-generation-with-clip-latents/
- system-card: https://github.com/openai/dalle-2-preview/blob/main/system-card.md
- 相关博客(pre-training mitigations): https://openai.com/index/dall-e-2-pre-training-mitigations/
一手源存档(sources/)
- paper-html.md (ar5iv 论文全文,含 Appendix C 训练细节与超参表;arXiv PDF 因沙箱网络对 arxiv.org:443 的 SSL 阻断未能下载,正文已由此 HTML 全量替代)
- blog.md (OpenAI DALL·E 2 产品页快照)
- research-blog.md (OpenAI 研究发布页 / 摘要)
- system-card.md (DALL·E 2 Preview system card 全文)