一句话定位
LDM 把扩散过程从像素空间搬进一个预训练 VAE/VQGAN 的低维潜空间(典型下采样因子 f=4/8),并用 cross-attention 把文本/语义图/布局等条件注入 U-Net,从而在保持质量的前提下把训练算力降一个量级、推理也显著加速——它是 stable-diffusion-1 的直接前身,奠定了”潜空间扩散 + 交叉注意力条件”这一统治至今的范式;其 ImageNet 类条件 LDM-4-G 取得 FID 3.60(参数仅 400M),文生图 LDM-KL-8-G 在 MS-COCO 上 FID 12.63(1.45B,远小于同期 GLIDE 6B / DALL·E 12B 量级)。
背景与定位
扩散模型(ddpm、diffusion-models-beat-gans 的 ADM)此前直接在 RGB 像素空间做去噪,质量 SOTA 但代价惊人:论文引用 ADM 训练耗 150–1000 V100 天、单 A100 上采 5 万张样本约需 5 天。其根因在于扩散是 likelihood-based、mode-covering 模型,会把大量容量花在建模”感知上无关紧要”的高频细节上(图 2 的 rate-distortion 分析)。
LDM 的核心洞察是把图像生成显式拆成两个阶段:
- 感知压缩(perceptual compression)——用一个对抗+感知损失训练的自编码器去掉不可感知的高频细节,得到一个”感知上等价但维度低得多”的潜空间;
- 语义压缩(semantic compression)——真正的生成模型(扩散 U-Net)只在这个低维潜空间里学习数据的语义与构图。
相对前置工作的改进:
- 对比两阶段自回归路线(VQVAE-2、dall-e-1/DALL·E、VQGAN+Transformer/taming-transformers-vqgan):那些方法为了让 AR Transformer 可训练,必须把图像压到很高的离散压缩率(f=16,1D 序列),牺牲重建细节;LDM 的卷积 U-Net backbone 对空间维度有更好的 inductive bias,可用更温和的压缩率(f=4/8、二维潜空间)兼顾重建保真与生成效率。
- 对比联合训练 encoder/decoder + score prior 的 LSGM:LDM 把自编码器与扩散先验解耦,自编码器只训一次即可复用于多个下游任务,且无需在重建与生成能力间做精细加权。
模型架构
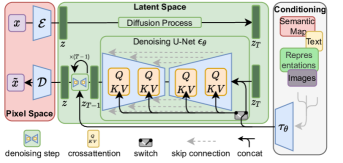
图源:Rombach et al., “High-Resolution Image Synthesis with Latent Diffusion Models” (arXiv:2112.10752) Figure 3 — 条件注入(concat / cross-attention)
两阶段结构。
第一阶段 — 感知压缩自编码器(E, D):
- 基于 VQGAN(taming-transformers-vqgan)的自编码器,编码器 E 把
x ∈ R^{H×W×3}压成z = E(x) ∈ R^{h×w×c},下采样因子f = H/h = 2^m,文中系统扫了 f ∈ {1,2,4,8,16,32}。 - 训练目标 = 感知损失(LPIPS)+ patch-based 对抗损失(patch discriminator),避免纯 L2/L1 造成的模糊(公式 25)。
- 两种潜空间正则:KL-reg(对潜变量施加极弱 KL 惩罚趋向标准正态,权重 ~1e-6,即一个低权重 VAE)或 VQ-reg(在解码器内放一个向量量化层,码本 |Z|,可看作”量化层被吸收进解码器的 VQGAN”)。两者都只用极小正则以保证高保真重建。
- 关键设计:潜空间是二维的(保留空间结构),不像 VQGAN+AR 那样把 z 拉成 1D 序列,因此能保留更多结构、重建更好(附录 Tab 8 的 autoencoder zoo,均在 OpenImages 训、ImageNet-val 评 R-FID↓:f=4 KL R-FID 0.27、f=4 VQ R-FID 0.58,远优于 DALL·E f=8 的 R-FID 32.01、VQGAN f=16 的 4.98)。
- 此 VAE 训完即冻结,后续多个扩散模型共享,无需重训。
第二阶段 — 潜空间扩散 U-Net(ε_θ):
- backbone 是时间条件 U-Net(基于 ADM 的 “ablated UNet”),主要由 2D 卷积层构成,因此可在卷积方式下泛化到比训练分辨率更大的图(如 256² 训练 → 512×1024 语义合成,megapixel 级 inpainting/SR)。
- 训练目标即标准的 ε-prediction 重加权下界
L_LDM = E[‖ε − ε_θ(z_t, t)‖²](公式 2/3),噪声前向过程在潜空间进行;z_t可由冻结的 E 高效得到,采样后用 D 一次前向解回像素。
条件注入(本文核心创新之一):
- 引入 cross-attention:把”ablated UNet”中的 self-attention 层换成一个浅层 Transformer 块(self-attn → MLP → cross-attn 交替,Tab 16),U-Net 中间特征做 Query,条件经一个领域特定编码器
τ_θ(y)产生 Key/Value。 - 对文生图:
τ_θ是一个 unmasked Transformer(深 32 层、dim 1280、序列长 77),输入用公开的 BERT-tokenizer 分词(注意:是 BERT tokenizer + 从头训的 Transformer,不是 后来 Stable Diffusion 用的冻结 CLIP text encoder)。 - 对类条件:
τ_θ退化为单个可学习 embedding(dim 512)经 cross-attention 注入。 - 对布局/语义图/超分/inpainting 等”密集条件”任务:直接把空间对齐的条件下采样后与潜变量 concat 进 U-Net 输入(τ_θ 为 identity)。
参数量与分辨率策略:
- 文生图 LAION 模型 1.45B 参数(f=8,潜形状 32×32×4,channels 320,batch 680,390K 步)。
- ImageNet 类条件最佳模型 LDM-4 约 400M 参数;无条件 CelebA/FFHQ/LSUN 模型 ~270–294M。
- 所有 256² 实验在单张 A100 上训练(inpainting 例外,用 8×V100)。
- 大图通过卷积式采样 + classifier-free guidance 直接合成 >256²。
数据
- 第一阶段自编码器:在 OpenImages 上训练(附录 Tab 8 的全套 autoencoder zoo 均在 OpenImages 训、ImageNet-val 评估),训完冻结复用。
- 文生图扩散模型:在 LAION-400M(4 亿 CLIP-filtered 图文对)上训练 1.45B 模型。
- 类条件 / 无条件:ImageNet、CelebA-HQ、FFHQ、LSUN-Churches、LSUN-Bedrooms(各 256²)。
- 布局到图像:COCO、OpenImages(先 OpenImages 训、再 COCO 微调)。
- 语义图到图像:Flickr-Landscapes / 景观图配语义图(256² 训练,512² 微调)。
- 超分:ImageNet,按 SR3 的处理流水线做 ×4 bicubic 下采样;另训一个 LDM-BSR,把固定 bicubic 退化换成更多样的退化流水线(JPEG 压缩噪声、相机传感器噪声、多种插值、高斯模糊核与高斯噪声随机组合),以泛化到真实世界图像。
- Inpainting:Places(256² 随机裁剪训练、512² 评估,按 LaMa 协议生成合成 mask)。
- 数据清洗/配比/美学过滤/安全过滤:论文未披露专门的美学打分或安全过滤流程(这部分要到后续 stable-diffusion-1 的 LAION-aesthetics 才系统化);本文用的是 LAION-400M 原生的 CLIP 过滤。无 re-captioning。
训练方法
- 训练目标:标准 DDPM 风格的 ε-prediction(去噪重加权变分下界,公式 1/2/3),T=1000 步,linear 噪声调度(附录 Tab 12–15 全部模型均为 linear schedule)。不是 flow matching、不是 next-token——这是经典离散时间扩散。
- 两阶段、解耦训练:先训自编码器(对抗+感知+弱正则,公式 25),冻结后再训扩散 U-Net。文生图等条件任务里
τ_θ与ε_θ联合优化(公式 3)。 - 采样/引导:推理用 DDIM 采样器(典型 50–250 步),并用 classifier-free guidance(CFG)大幅提质——这是质量飞跃的关键 trick(如 ImageNet LDM-4 无引导 FID 10.56 → CFG s=1.5 后 FID 3.60;文生图 LDM-KL-8 FID 23.31 → CFG 后 12.63)。也支持 classifier guidance(在潜空间训一个极廉价的噪声分类器)。
- 潜空间 rescaling trick:KL-reg 潜空间方差不为 1,会导致卷积大图采样时 SNR 偏高、细节分配过早;论文用第一批数据估计逐分量标准差对潜变量做 rescale 使其单位方差(附录 G、D.1),对 >256² 卷积采样至关重要;VQ-reg 潜空间方差天然接近 1 无需 rescale。
- post-hoc 图像引导:把 ADM 的 classifier guidance 推广为通用 image-to-image 引导(用 L2 或 LPIPS 作为引导目标,公式 16/17),无需重训即可在测试时引导无条件模型(如把 256² 无条件模型卷积上采到 512²)。
- 蒸馏/步数蒸馏:本文未做(无 consistency/LCM/ADD;那是后续工作)。加速主要来自”潜空间维度降低”本身 + DDIM 减步。
- 关键超参(Tab 12–15 摘选):扩散 1000 步 linear;学习率约 4.5e-5 ~ 1.3e-4;ImageNet LDM-4 batch 1200 训 178K 步;LAION 文生图 batch 680 训 390K 步;多数无条件模型 batch 24–112、训 0.5M–1.9M 步。
Infra(训练 / 推理工程)
- 算力规模:核心卖点。论文在单张 NVIDIA A100 上完成几乎全部 256² 实验(inpainting 用 8×V100)。附录 Tab 18 用 V100-days 量化对比(A100→V100 按 ×2.2 折算):
- ImageNet 类条件:LDM-4 训练约 271 V100-days(400M 参),对比 ADM-G 的 916+46 V100-days、ADM 的 916,且 FID 更优(3.60 vs 4.59)。
- LSUN-Churches LDM-8 仅 18 V100-days(vs StyleGAN2 的 64);CelebA-HQ LDM-4 14.4 V100-days。
- 论文摘要口径:“相比像素扩散显著降低训练与推理成本”。
- 吞吐(附录 Tab 6 inpainting 效率):潜空间相比像素扩散训练吞吐提升约 3×(LDM-1 像素 0.11 samples/s → LDM-4 0.32–0.35),且像素→潜空间至少 2.7× 加速、FID 至少改善 1.6×。
- 推理加速:(1) 在低维潜空间采样本身省算力;(2) DDIM 减步(50–250 步);(3) U-Net 卷积特性支持一次前向卷积式生成大图。Tab 18 推理吞吐(单 A100 samples/s,均 250 步 DDIM,含 VAE 解码):ImageNet LDM-4(-G) 约 0.4 samples/s,与 ADM(250 步) 的 0.7 同量级——256² 这一档推理吞吐 LDM 并不显著占优(autoencoder 解码 + 256² 像素 U-Net 体量相近);LDM 的真正成本优势在训练算力(271 vs 916 V100-days,见上)与大分辨率卷积式生成。FFHQ / LSUN-Bedrooms 等较简单数据集上 LDM-4 吞吐可达 1.07 samples/s。
- 并行/混合精度/具体 GPU·时总账:论文未给完整集群规模或分布式策略细节(重点强调”单卡可训”这一可达性论点)。
- 部署形态:开源 PyTorch 代码 + 预训练权重(conda 环境
ldm),后被集成进 HuggingFace Spaces(Gradio web demo)。
评测 benchmark(把效果讲清楚)
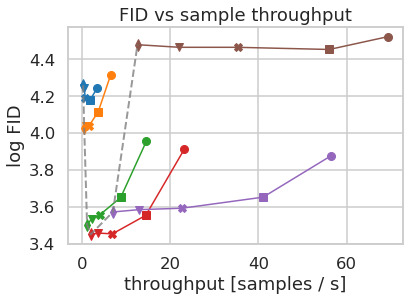
图源:Rombach et al., “High-Resolution Image Synthesis with Latent Diffusion Models” (arXiv:2112.10752) Figure 7 — ImageNet 上不同下采样因子 LDM 的采样吞吐 vs FID 权衡(LDM-4/8 为效率-质量甜区)
(数字均来自已抓取的 PDF 正文与附录表)
无条件生成(Tab 1,256²,FID↓):
- CelebA-HQ:LDM-4 FID 5.11(新 SOTA,超 LSGM 7.22、PGGAN 8.0)。
- FFHQ:LDM-4 FID 4.98(Prec 0.73/Recall 0.50;StyleGAN 4.16)。
- LSUN-Churches:LDM-8 FID 4.02(StyleGAN2 3.86)。
- LSUN-Bedrooms:LDM-4 FID 2.95(接近 ADM 1.90,但参数减半、算力 4× 更少)。
类条件 ImageNet(Tab 3 / Tab 10,256²):
- LDM-4 无引导:FID 10.56 / IS 103.5(400M 参)。
- LDM-4-G(CFG s=1.5):FID 3.60 / IS 247.67,超过 ADM 的 ADM-G FID 4.59(608M 参),参数与算力均显著更少。
- LDM-8-G(CFG):FID 8.11。
文生图 MS-COCO(Tab 2,256²,30k 验证样本):
- LDM-KL-8(250 DDIM 步):FID 23.31 / IS 20.03(1.45B 参)。
- LDM-KL-8-G(CFG s=1.5):FID 12.63 / IS 30.29——与同期 GLIDE(FID 12.24,6B 参)、Make-A-Scene(FID 11.84,4B 参)“on par”,但参数量小数倍(1.45B vs 4–6B),明显优于 CogView FID 27.10、LAFITE 26.94。
超分 ×4(ImageNet-Val 256²,Tab 5/11):
- LDM-4(100 步)FID 2.8/4.8(val/train 特征),优于 SR3 的 FID 5.2;SR3 在 IS 上更高。简单回归基线 PSNR/SSIM 最高但感知质量差。用户研究中 LDM-SR 偏好率高于像素基线。
Inpainting(Places 512² 30k crops,Tab 7):
- LDM-4(big, w/ ft, w/o attn)FID 9.39(全样本)/ 1.50(40-50% mask 难例),优于 LaMa 的 12.0/2.21;用户研究人评也更偏好 LDM。FFC 专用架构 LaMa 被通用 LDM 超过。
布局到图像(Tab 9,COCO 256²):
- LDM-4(OpenImages 预训 + COCO 微调)FID 40.91,超 OC-GAN/SPADE/LostGAN-V2;OpenImages 上 FID 32.02,比 Jahn et al 的 VQGAN+T 改善近 11。
关键消融结论:
- 压缩率甜区:扫 f∈{1,2,4,8,16,32}(图 6/7)。f 太小(LDM-1/2,即接近像素扩散)训练极慢;f 太大(LDM-32)信息损失致质量饱和;LDM-4 与 LDM-8 是效率-质量最佳平衡。固定 2M 步后,像素扩散 LDM-1 与 LDM-8 的 FID 差距高达 38。
- VQ-reg 潜空间的扩散有时比 KL-reg 采样质量更好,尽管其重建略逊。
- inpainting 大模型在 512² 出现 attention 模块导致的质量退化,半个 epoch 的 512² 微调即可校正并刷新 SOTA。
创新点与影响
核心贡献:
- 潜空间扩散范式:首次系统论证”在感知压缩潜空间做扩散”能在复杂度降低与细节保留间逼近最优点,把高分辨率扩散的训练/推理成本降一个量级,让单卡 A100 也能训出 SOTA 生成模型——“民主化高分辨率图像合成”。
- cross-attention 通用条件机制:把扩散 U-Net 变成支持文本/语义图/布局/类别等任意 token 化条件的通用条件生成器,统一了类条件、文生图、布局到图、超分、inpainting、语义合成多任务,无需任务特定架构。
- 可复用的解耦自编码器:自编码器训一次、多任务复用,且无需在重建与生成间精细加权。
影响:
- 直接催生 stable-diffusion-1(同作者 Rombach/Blattmann/Esser,Stability AI/Runway/CompVis)——SD 即在 LDM 框架上换用冻结 CLIP text encoder + 更大 LAION-aesthetics 数据,成为开源文生图的事实标准与整个开放生态(ControlNet、LoRA、各类微调)的底座。
- “潜空间 + 交叉注意力条件”成为后续几乎所有主流文生图/视频/3D 扩散(含 SDXL、视频扩散、众多 DiT 派生)的默认起点。
- VAE 潜空间 + diffusion backbone 的解耦设计也影响了后来 DiT/MMDiT(把 U-Net 换 Transformer,但潜空间扩散的两阶段骨架不变)。
已知局限(作者自述):
- 顺序采样仍慢于 GAN(虽快于像素扩散)。
- 对需要像素级高精度的任务,f=4 自编码器的重建能力会成为瓶颈(超分尤甚)。
- 生成模型可能复现训练数据、放大数据偏见、被滥用于 deepfake/虚假信息——作者明确讨论了双刃剑性质。
- 文生图用的是从头训的 BERT-tokenizer Transformer 而非 CLIP(这一改进留给了后续 Stable Diffusion)。
原始链接
- arxiv_abs: https://arxiv.org/abs/2112.10752
- arxiv_pdf: https://arxiv.org/pdf/2112.10752
- github: https://github.com/CompVis/latent-diffusion
- hf_demo: https://huggingface.co/spaces/multimodalart/latentdiffusion
一手源存档(sources/)
- arxiv-2112.10752.pdf (论文全文 v2,2022-04-13;PDF 不入 git,本地精读)
- readme.md (CompVis 官方仓库 README,含 model zoo / LAION 1.45B 权重 / 检索增强 RDM / colab)