一句话定位
Hunyuan-DiT 是腾讯混元 2024 年 5 月开源的中英双语文生图 Diffusion Transformer,靠”双文本编码器(双语 CLIP + 多语 mT5)+ 2D RoPE 多分辨率 + cross-attention 注入 + MLLM 改写 caption + 多轮对话”实现细粒度中文理解;1.5B 参数在 ≥50 人专业人评下成为当时开源模型里中文文生图 SOTA(综合通过率 59.0%,超 SDXL/PixArt-α/Playground 2.5,并在主体清晰度/美学上接近 DALL·E 3、MidJourney v6)。
背景与定位
DALL·E、Stable Diffusion、PixArt-α 等主流文生图模型缺乏对中文 prompt 的直接理解;当时的中文方案(AltDiffusion、PAI-Diffusion、Taiyi)生成质量仍不足。Hunyuan-DiT 的定位是补上”既懂中文又达到强生成质量”的开源空白:它把 pixart-alpha 开创的 DiT-as-T2I 路线(用 transformer 替换 U-Net 做扩散 backbone,见 dit-scalable-diffusion-transformers、latent-diffusion-ldm)与双语理解、工业级数据流水线、多轮交互式生成结合,构成腾讯首个完整开源的 DiT 文生图全栈(模型 + 训练码 + 蒸馏/加速 + ControlNet/LoRA/IP-Adapter + captioner + 对话增强)。它是国产开源 T2I 的标志性工作,发布时已对标闭源 dall-e-3、MidJourney v6 与 stable-diffusion-3。
模型架构
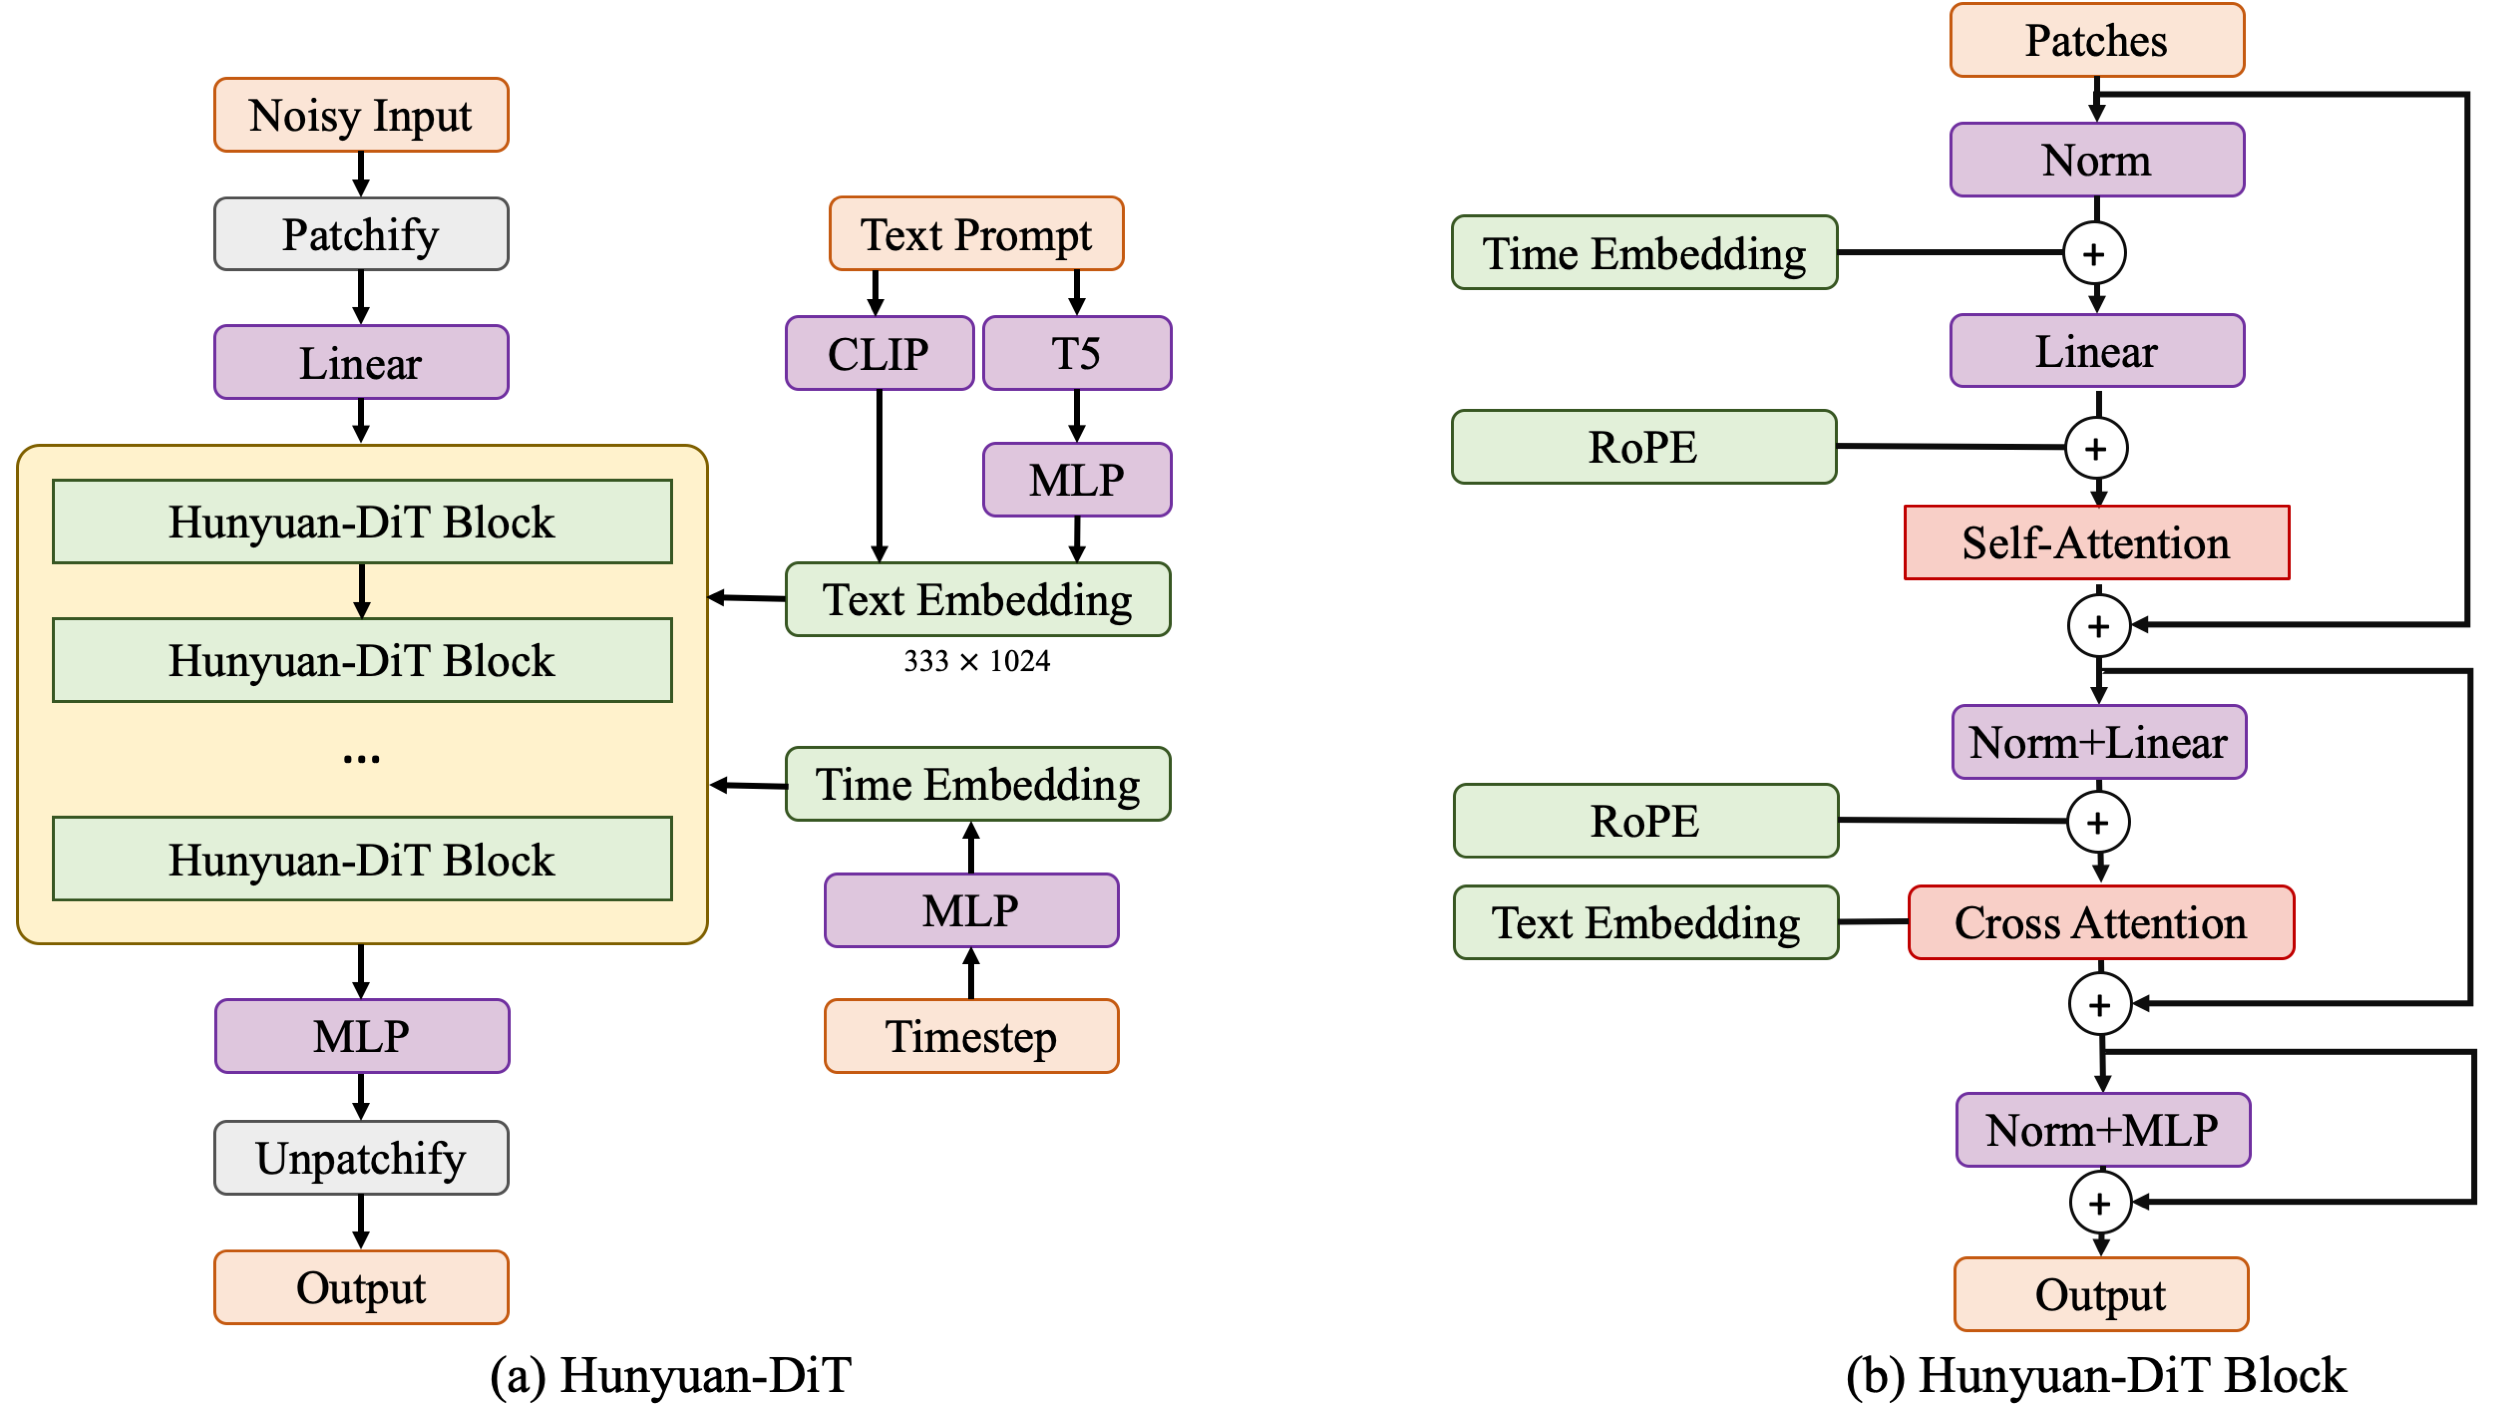
图源:Hunyuan-DiT 官方 README / 论文 Fig.7(https://github.com/Tencent/HunyuanDiT,arXiv:2405.08748)
总体:latent-space 扩散模型。先用预训练 VAE 把图像压到低维 latent,再用 transformer 参数化的扩散模型学分布。
- VAE:直接用 sdxl 的 VAE(由 SD 1.5 的 VAE 在 512×512 上微调而来)。下采样因子 8,latent 通道数 4(config:
in_channels=4)。作者发现高分辨率 SDXL VAE 相比 SD 1.5 VAE 提升清晰度、缓解过饱和、减少畸变。 - Diffusion Transformer(核心改进,相对原始 DiT):
- 条件注入用 cross-attention 而非 AdaLN。作者发现 class-conditional DiT 里的 Adaptive LayerNorm 不足以承载细粒度文本条件,于是改成类似 Stable Diffusion 的 cross-attention 注入文本。
- patchify:输入 latent
x∈R^{c×h×w}切成p=2的 patch,线性投影后得hw/4个 token。 - Encoder block + Decoder block 两类:各含 self-attention、cross-attention、FFN 三模块,文本信息在 cross-attention 融合。Decoder block 额外含 skip module,把 encoder 对称层特征加进来(类比 U-Net 的 long skip-connection,但无上/下采样);并在 skip module 后加 LayerNorm 防 loss 爆炸。
- 官方 diffusers config 实测超参(v1.0/v1.2 一致):
hidden_size=1408,num_layers=40,num_attention_heads=16,attention_head_dim=88,mlp_ratio≈4.36,patch_size=2,activation=gelu-approximate,learn_sigma=true,sample_size=128(即 1024px 对应 128×128 latent)。
- 文本编码器(双塔):双语(中英)CLIP(350M,
cross_attention_dim=1024,text_len=77)+ 多语 mT5(1.6B,cross_attention_dim_t5=2048,text_len_t5=256)。消融表明:单用双语 CLIP 优于单用 mT5;两者拼接(沿文本长度维而非通道维)显著优于任一单独使用——CLIP 高效抓全局语义,T5 提供细粒度理解。长文本支持到 256 token。 - 位置编码与多分辨率:用 2D RoPE(旋转位置编码,同时编码绝对+相对位置)。多分辨率训练对位置编码提出对齐要求,作者比较两种方案:① Extended PE(朴素按坐标编码,不同分辨率 PE 差异大,次优);② Centralized Interpolative PE(中心化插值,把不同 h/w 的 PE 对齐到统一 [0,S] 范围)——后者收敛更快、能泛化到新分辨率,为采用方案。
- 训练稳定性三招:① QK-Norm(Q/K/V 计算前在所有 attention 加 LayerNorm);② skip module 后加 LayerNorm;③ LayerNorm 等易在 FP16 溢出的算子切到 FP32。
- 参数量:主模型 1.5B(论文/HF 一致);消融实验用更小的 0.7B DiT。配套组件:DialogGen/对话增强 MLLM 7.0B,Hunyuan-Captioner(LLaVA-1.6 结构)。
数据
完全自建的数据流水线(论文 Sec 2.2),分四步:
- 数据获取:外部采购、开放数据下载、授权合作方数据。
- 数据解读(打标):>10 种打标能力——清晰度、美学、低俗/暴力/色情、水印、图像分类、图像描述等。
- 数据分层:① 铜级(copper)——数十亿(billions)图文对训练基础 CLIP;② 银级(silver)——从大库筛出的较高质量集,训生成模型提质与理解;③ 金级(gold)——经机器筛选 + 人工标注的最高质量数据,做精修与优化。
- 数据应用:筛专项数据做人物/风格等专项优化;新处理数据持续加入基础模型迭代。
- 类目体系:主体(subject)覆盖人/景/植物/动物/商品/交通/游戏等,>1 万子类;风格(style)覆盖动漫/3D/绘画/写实/传统等 >100 种。
- Data Convoy(数据护航机制):按类目体系给数据分类→调整类目间分布→用类目均衡数据微调→对比微调前后模型的逐类目优劣,据此决定数据更新方向。需配套完整评测协议(见下)。
- Caption 改写(细粒度中文理解关键):用自训 MLLM 对原始图文对 re-caption,产出结构化 caption(含世界知识)。
- MLLM 结构类似 LLaVA-1.6:ViT 视觉 + decoder-only LLM 语言 + Adapter 桥接,训练目标为自回归分类 loss。
- 三阶段 AI 辅助构建标注集:Stage1 多个基础 captioner 集成 + 人工标注得初始集;Stage2 训 MLLM 再生成新 caption,人工标注效率提升约 4 倍。
- 世界知识注入两法:① Tag Injection——用人工/专家模型(物体检测、地标分类、动作识别)打 tag,再让 MLLM 把 tag 融进 caption,可用极稀疏人标数据训练;② Raw Caption Fusion——借鉴 CapsFusion,让 MLLM 同时输入图像+原始 caption,用图像信息纠正原始 caption 的错误。
- 未披露:训练用图文对总规模的精确数字、各 tier 的具体配比、最终训练集大小、安全过滤的量化阈值。
训练方法
- 扩散参数化:采用 v-prediction(论文称经验上更好),而非 ε-prediction。
learn_sigma=true(同时预测方差)。 - 迭代优化范式:模型不是一次训成,而是通过 Data Convoy 机制持续”加数据→类目均衡微调→人评对比→更新数据”的闭环迭代;版本上从 v1.0 → v1.1(缓解过饱和与水印)→ v1.2 持续提升。
- 多轮对话能力(Prompt Enhancement / DialogGen):
- 用户自然语言指令与训练用的精修 caption 分布差异大,需一个模型把指令转成详细连贯 prompt。借 GPT-4 的 in-context learning:人工标注少量 (instruction, prompt) 对做 ICL 示例,再让 GPT-4 批量生成,构成单轮 instruction→prompt 数据集
Dp。 - 训 MLLM 理解多轮对话并输出新 prompt;加特殊 token
<draw>(命中即生成详细 prompt 送给 Hunyuan-DiT)。设计三轮多模态对话数据集Dtt:覆盖 text→text、text→image、text+image→text、text+image→image 四类组合,遍历 13 个主题 × 7 种图像编辑方法,用 GPT-4 配”dialogue prompts”生成 约 15,000 样本。 - 混入开源单/多模态对话集
Do,与Dp拼成伪多轮Dpm,并训练<switch>token 适应话题切换。最终训练集D = Do + Dp + Dpm + Dtt。 - 主体一致性保证:dialogue prompt 约束”在满足新需求前提下尽量少改 prompt”,且推理时固定随机种子,显著提升多轮间主体一致性。
- 用户自然语言指令与训练用的精修 caption 分布差异大,需一个模型把指令转成详细连贯 prompt。借 GPT-4 的 in-context learning:人工标注少量 (instruction, prompt) 对做 ICL 示例,再让 GPT-4 批量生成,构成单轮 instruction→prompt 数据集
- 加速 / 蒸馏:作者试过对抗蒸馏(ADD)、LCM、InstaFlow 等,遇到训练崩溃/不能复用 LoRA 插件/LCM 仅适合低步/对抗训练显存大等问题;最终选 Progressive Distillation(渐进式蒸馏)——训练稳定、可平滑权衡加速比与质量、成本最低。蒸馏版(Distillation)实现约 50% 推理加速。
- 未披露:优化器/学习率/batch size/总训练步数、各阶段训练 token/图像数、预训练分辨率课程的具体调度。
Infra(训练 / 推理工程)
- 训练优化:因参数量大、数据海量,采用 ZeRO(DeepSpeed)、FlashAttention、多流异步执行、activation checkpointing、kernel fusion 提速。训练码开源,支持单机/多机分布式(
--hostfile/--master_addr),全参训练最低单卡 ~20GB、推荐 ~30GB;个人用户可用 Kohya 在 ~16GB 微调。 - 推理优化:ONNX 图优化、kernel 优化、算子融合、预计算、GPU 显存复用。提供 TensorRT 版(约 47% 加速) 与 Distillation 版(约 50% 加速)。
- 部署显存(batch=1,A100):Hunyuan-DiT 单独 11GB;+ DialogGen 32GB(4bit 量化后 22GB);RTX3090/4090 上 14GB;基于 diffusers + bitsandbytes 可做到 <6GB 显存推理。
- 算力规模未披露:论文/README 均未给出训练 GPU 数量、GPU·小时、吞吐等具体数字。
评测 benchmark(把效果讲清楚)
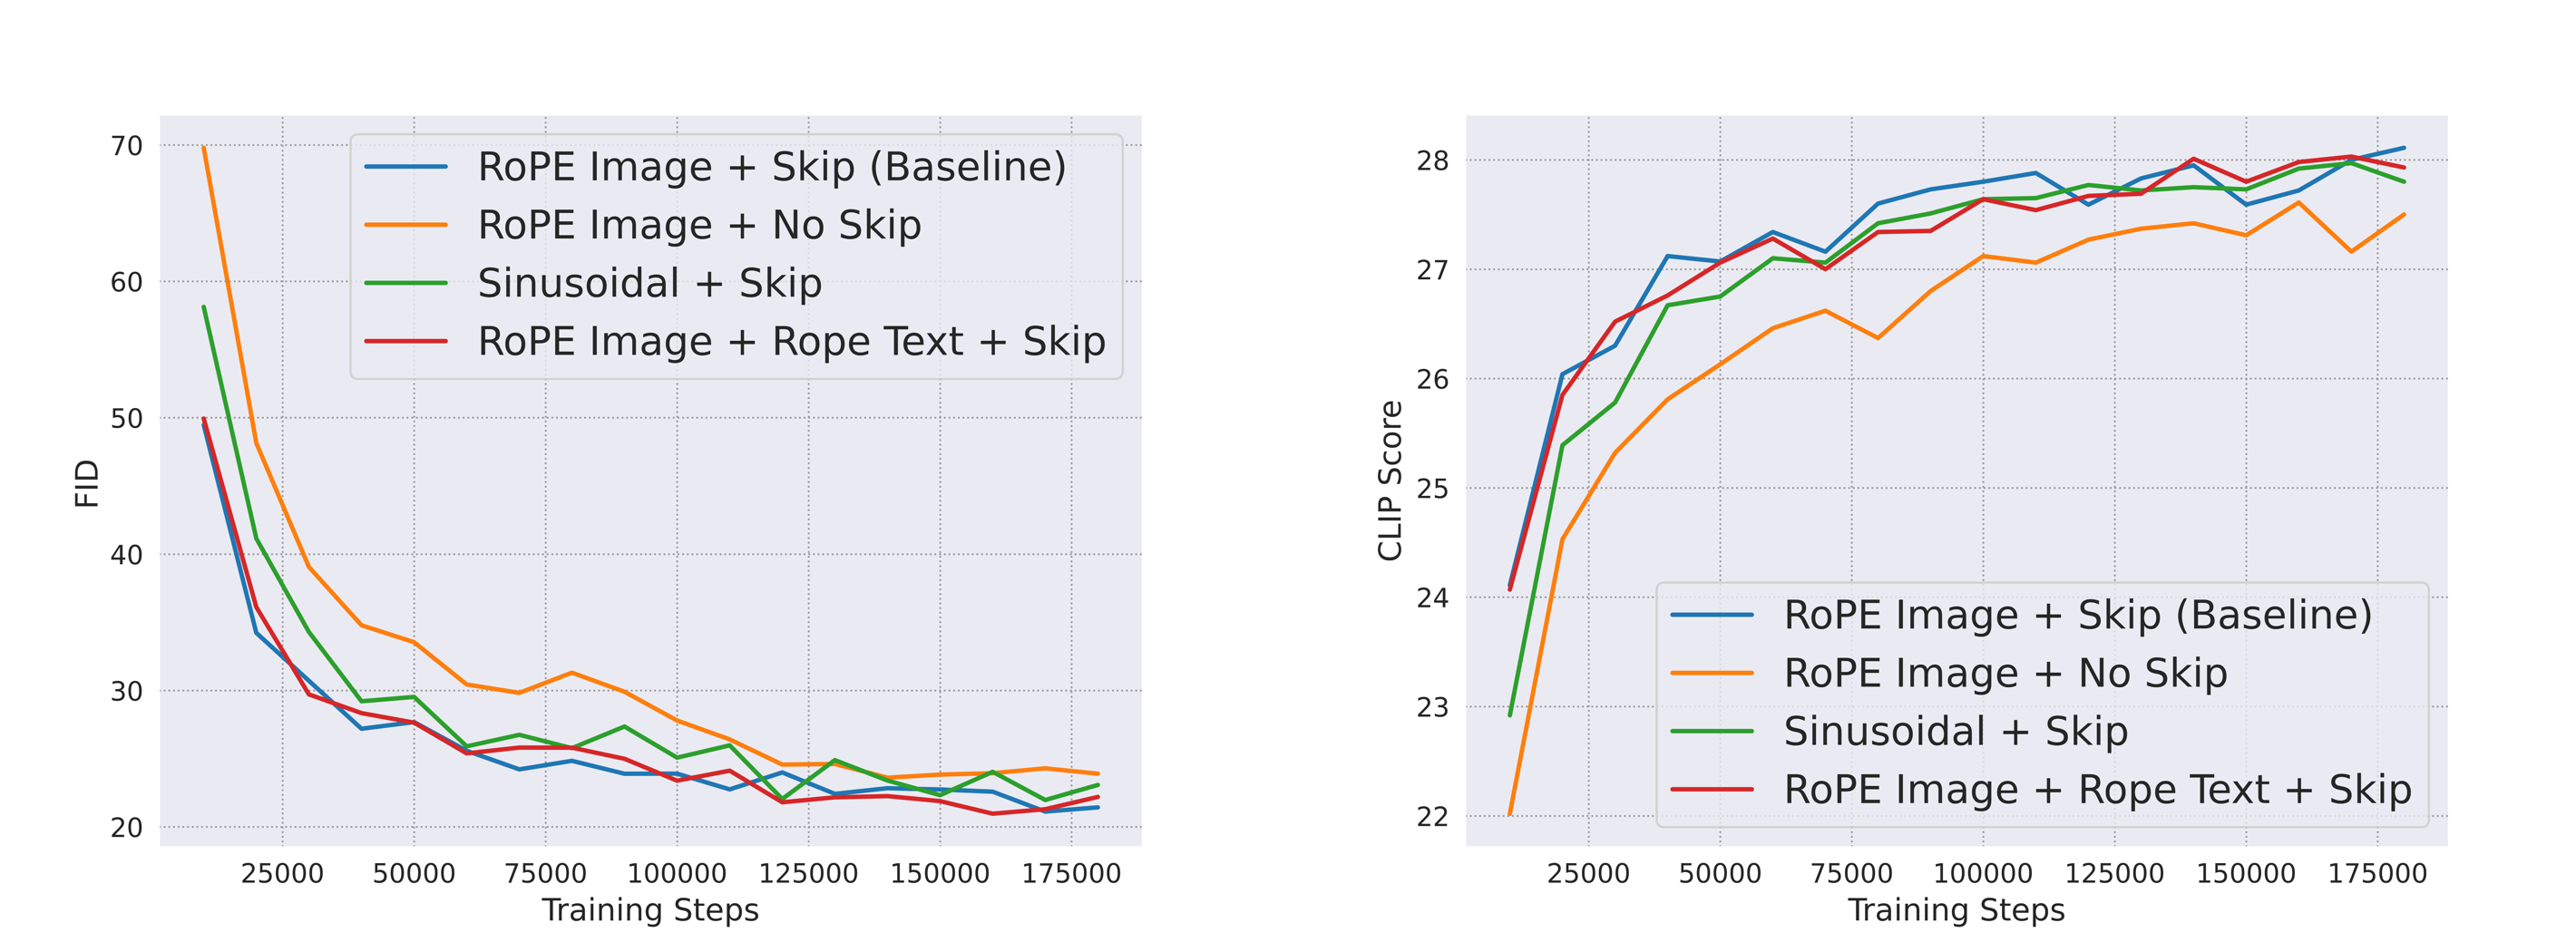
图源:Hunyuan-DiT 论文 Fig.15(位置编码与模型结构消融:FID / CLIP-Score vs 训练步,arXiv:2405.08748)
专业人评(≥50 名评估员,4 维度:文图一致性 / 排除 AI 瑕疵 / 主体清晰度 / 美学;评测集 3 级层级、8 个一级类 + >70 个二级类、>3000 prompt;通过率逐级聚合)。论文 Table 1:
| 类型 | 模型 | 文图一致性% | 排除AI瑕疵% | 主体清晰度% | 美学% | 综合% |
|---|---|---|---|---|---|---|
| 开源 | Hunyuan-DiT | 74.2 | 74.3 | 95.4 | 86.6 | 59.0 |
| 开源 | Playground 2.5 | 71.9 | 70.8 | 94.9 | 83.3 | 54.3 |
| 开源 | PixArt-α | 68.3 | 60.9 | 93.2 | 77.5 | 45.5 |
| 开源 | SDXL | 64.3 | 60.6 | 91.1 | 76.3 | 42.7 |
| 闭源 | DALL·E 3 | 83.9 | 80.3 | 96.5 | 89.4 | 71.0 |
| 闭源 | SD 3 | 77.1 | 69.3 | 94.6 | 82.5 | 56.7 |
| 闭源 | MidJourney v6 | 73.5 | 80.2 | 93.5 | 87.2 | 63.3 |
- Hunyuan-DiT 在四个维度全部超过所有开源对比模型(含 SDXL、PixArt-α、Playground 2.5);综合通过率 59.0% 在全部模型中排第三(仅次于闭源 DALL·E 3、MidJourney v6),并超过闭源 SD 3 的 56.7%。在主体清晰度(95.4%)和美学(86.6%)上接近 DALL·E 3 / MidJourney v6。
- 消融(用 0.7B DiT,COCO 256×256 zero-shot FID + CLIPScore,生成 30,000 图):
- Skip Module:移除 long skip-connection 会升高 FID、降低 CLIPScore(有效)。
- RoPE vs 正弦 PE:RoPE 在训练大部分阶段优于正弦 PE,且加速收敛(同时编码绝对+相对位置);但给文本 embedding 加 1D RoPE 无显著增益。
- 文本编码器:CLIP 单独 > mT5 单独;CLIP + mT5 拼接显著提升 FID 与 CLIPScore;沿文本长度维拼接 > 沿通道维拼接。
- Prompt Enhancement:对简单/抽象概念 prompt,MLLM 改写能有效提升图文一致性。
- 未报告:论文未给出主模型(1.5B)的绝对 FID/CLIPScore 数值,也未报告 GenEval、T2I-CompBench、DPG-Bench、HPSv2、ImageReward、PickScore 等自动指标;消融的 FID/CLIP 仅以曲线图(Fig.15–17)呈现,无表格数字。
创新点与影响
- 核心贡献:① 首个达到强生成质量的开源中英双语 DiT 文生图,把细粒度中文理解做到 SOTA;② 双文本编码器(双语 CLIP + 多语 mT5)沿长度维拼接的有效配方;③ 2D RoPE + Centralized Interpolative PE 的多分辨率训练方案;④ cross-attention 注入 + skip module + QK-Norm 等一组让 DiT 文生图稳定收敛的工程改进;⑤ MLLM 结构化 re-captioning + tag/raw-caption 世界知识注入 的数据提质流水线;⑥
<draw>/<switch>token + GPT-4 合成对话数据 的多轮交互式生成(DialogGen)。 - 影响:作为腾讯混元开源生态的 T2I 基座,配套 ControlNet(canny/depth/pose)、LoRA、IP-Adapter、Captioner、TensorRT/蒸馏加速、ComfyUI/Diffusers/Kohya 集成,被社区广泛二创;其”双编码器 + 2D RoPE + cross-attn DiT”的思路与同期 stable-diffusion-3、pixart-alpha 一道推动 DiT 取代 U-Net 成为文生图主流 backbone;也为后续腾讯混元系列(hunyuan-video、hunyuan3d-1)的多模态生成打下框架与数据流水线基础。
- 已知局限:① 论文承认 VAE latent 空间显著影响质量,未来需更好的 VAE 训练范式;② v1.0 存在过饱和/水印问题(v1.1 才缓解),说明数据清洗仍有残留;③ 缺自动指标全量对标(无 GenEval/CompBench 等),效果主要靠自建人评协议,跨工作可比性弱;④ 训练算力/数据规模等关键工程数字未公开。
原始链接
- arxiv_abs: https://arxiv.org/abs/2405.08748
- arxiv_pdf: https://arxiv.org/pdf/2405.08748
- github: https://github.com/Tencent/HunyuanDiT
- hf: https://huggingface.co/Tencent-Hunyuan/HunyuanDiT (v1.2: https://huggingface.co/Tencent-Hunyuan/HunyuanDiT-v1.2 ; Diffusers: https://huggingface.co/Tencent-Hunyuan/HunyuanDiT-v1.2-Diffusers)
- project_page: https://dit.hunyuan.tencent.com
- companion_paper (DialogGen): https://arxiv.org/abs/2403.08857
一手源存档(sources/)
- arxiv-2405.08748.pdf (arXiv 原文 PDF,不入 git)
- readme.md
- hf-modelcard.md
- diffusers-transformer-config.json