一句话定位
SD3 是 Stability AI 的旗舰文生图模型,核心创新是把 rectified flow(修正流 / 直线轨迹)的改进训练目标 与全新的 MMDiT(Multimodal Diffusion Transformer,文本/图像各持一套权重、在注意力处拼接共享) 结合,并做到 8B 参数的可预测 scaling。最大的 depth=38(8B)模型在 GenEval 上 overall 0.74(w/DPO@1024²),超过 DALL·E 3(0.67),并在人评的 prompt following / typography / visual aesthetics 上等于或胜过 DALL·E 3、Midjourney v6、Ideogram v1。
背景与定位
SD3 要同时回答两个问题:
- 用什么生成式公式? 标准扩散(DDPM/EDM/latent-diffusion-ldm 的 ε-/v-预测)在数据与噪声间走弯曲轨迹;rectified flow(Liu 2022、Lipman 2023 flow matching)把数据-噪声连成直线,理论更简洁、推理路径更直、少步采样更省。但 RF 在大规模 T2I 上还未被证明是 SOTA 实践。SD3 通过一个控制变量的大规模对比(61 种公式、2 个数据集、多采样器)证明 RF + 中间步加权确实更优。
- 怎么把文本条件注入? 既有 DiT 用 cross-attention 把文本「单向」喂进图像分支(Pixart-α 路线),作者认为这并非最优。SD3 提出让文本与图像各持独立 transformer 权重、仅在 attention 处拼接序列,实现双向信息流。
它是 SD 系列从 UNet(SDXL/Stable Cascade)转向 DiT 系 + flow matching 的转折点,直接奠定了后续 flux-1(BFL,同一批作者)与 SD3.5 的范式。论文承诺开放实验数据、代码、权重(后续以 SD3 Medium 2B 等多规格 800M–8B 发布)。
模型架构
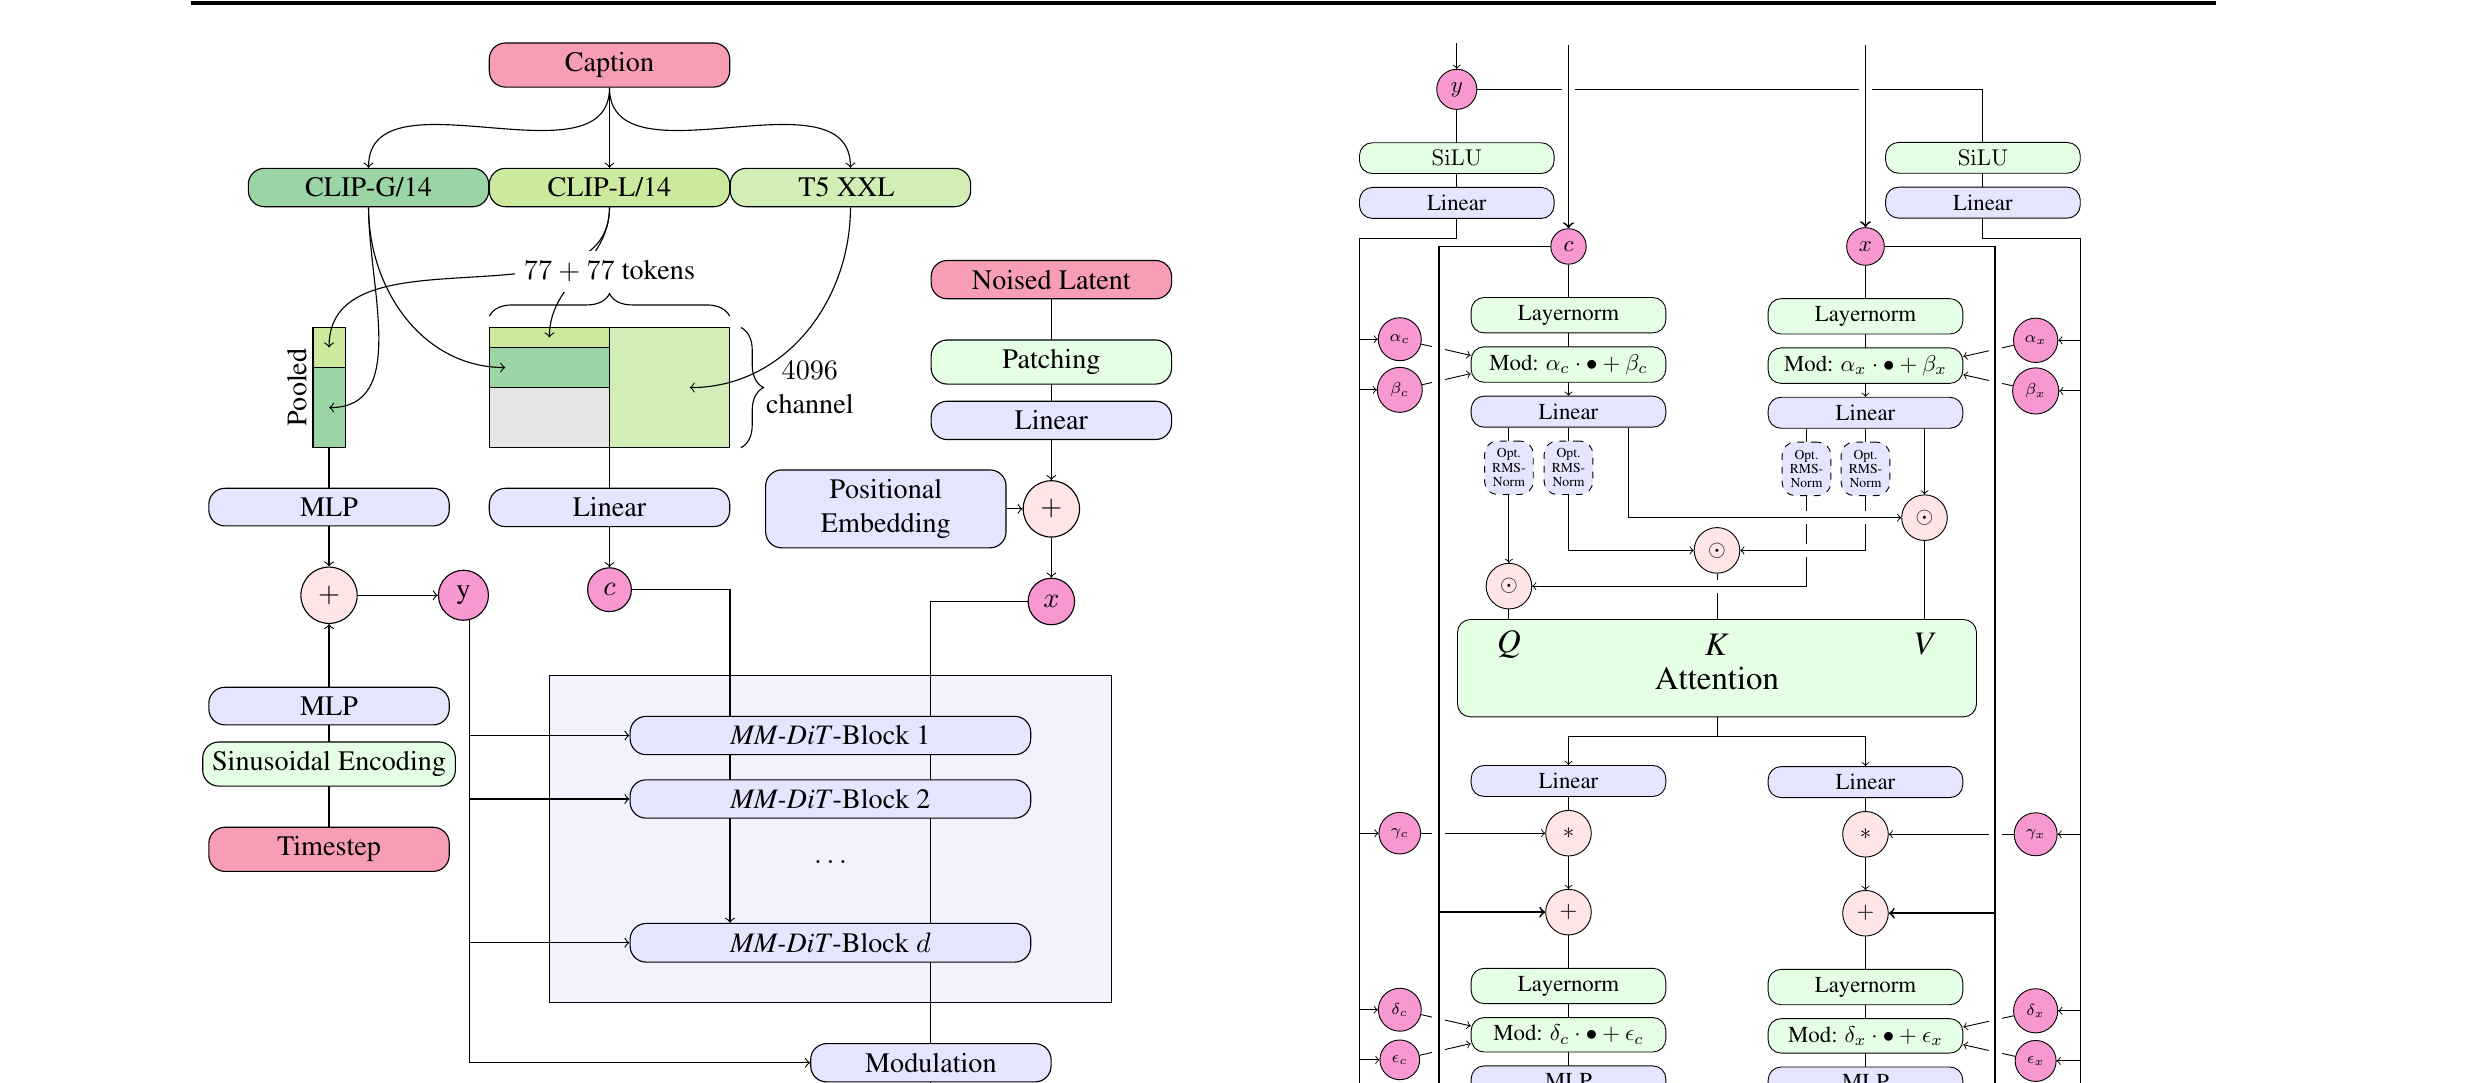
图源:Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (SD3), Figure 2 — Our model architecture((a) Overview of all components / (b) One MM-DiT block),https://arxiv.org/abs/2403.03206
整体(latent diffusion):沿用 LDM 框架,在预训练自编码器的隐空间中训练;下采样因子 f=8。
Autoencoder(VAE):把 RGB X∈R^{H×W×3} 编码到 x∈R^{h×w×d}。SD3 把隐通道数从常用的 d=4 提升到 d=16——重建质量显著上升(见数据节 Table 3),且 16 通道在 sample FID 上 scaling 更好,故全程采用 d=16。
Text encoders(三个,冻结):
- CLIP-G/14(OpenCLIP bigG)+ CLIP-L/14 → 提供 token 序列表示
c_ctxt和池化表示c_vec; - T5-XXL(4.7B 参数)→ 提供更细粒度的长文本/拼写表示;
- 两路 CLIP 文本 token 各 77,与 T5 token 一起拼成文本序列;池化向量
c_vec与时间步 embedding 一起进入 modulation(AdaLN 风格)。三个 encoder 各自 inference 时可 drop(见「Flexible Text Encoders」)。
MMDiT backbone(核心创新):建立在 DiT(Peebles & Xie 2023)之上,但:
- 图像 latent 先做 2×2 patch,展平成长度
½h·½w的 patch 序列,加 2D 位置编码;文本序列与图像序列拼接后做注意力。 - 文本与图像各用一套独立权重(独立的 LayerNorm、Linear、MLP、modulation),等价于「两台独立 transformer 在 attention 处共享序列」——既各自在自己空间工作,又能看见对方。论文也试了「三套权重」(CLIP 与 T5 各一套),收益很小但参数/显存涨,故选两套权重。
- QK-RMSNorm:在 Q、K 进注意力前加可学习 scale 的 RMSNorm,抑制高分辨率微调时(尤其网络最后几个 block)的 attention-logit 爆炸/熵坍缩,使 bf16-mixed 精度稳定训练(配合 AdamW
ε=1e-15)。 - scaling 参数化:模型规模由深度 d(注意力块数)决定,hidden size = 64·d,MLP 扩 4×,注意力头数 = d。从 d=15(450M,15 blocks)到 d=38(8B,38 blocks)。
- 多分辨率/多宽高比:256² 预训练后微调到混合宽高比;用「扩展+插值的 2D 位置网格再做频率编码 + bucketed sampling(每 batch 同尺寸 H·W≈S²)+ center-crop」处理任意宽高比。
- 论文指出该架构「易扩展到视频」,并做了 16 帧 256² 的初步视频 scaling(2× 时间 patch + 空间注意力后加一层全时空注意力)。
数据
- 规模/来源:内部「大规模图文数据集」(具体规模、来源域未披露)。对照实验另用公开 ImageNet 与 CC12M、评测用 COCO-2014 val、GenEval、T2I-CompBench。
- Re-captioning(合成标注):沿 DALL·E 3 思路,用 CogVLM 给大规模数据集生成合成 caption。为防止模型遗忘 VLM 知识库外的概念,采用 50% 原始 + 50% 合成 的混合比例。消融(d=15、250k 步、GenEval):原始 caption overall 43.27 → 50/50 混合 49.78;其中 Color Attribution 11.75→24.75、Position 6.50→18.00、Two Objects 41.41→52.53 提升最大。
- 过滤/清洗(预训练前):(i) 性内容——NSFW 检测模型过滤露骨内容;(ii) 美学——用评分系统去掉低美学分图;(iii) Regurgitation——基于聚类的去重(autofaiss)去除感知/语义重复,降低训练数据被「复读」记忆的风险。
- 预编码:autoencoder latent 与三路 text encoder 表示在训练前一次性预计算并落盘(因冻结、训练中恒定),省去训练时前向。
训练方法
生成式目标:rectified flow + 改进时间步加权
- RF 把数据
p0与噪声p1用直线连接z_t=(1−t)x0+tε,网络回归速度场v_θ。 - 关键改进是时间步采样分布偏向中段(中间步预测最难、信息量最大):用 logit-normal 采样
π_ln(t;m,s)(位置 m、尺度 s)。大规模对比 61 种公式后,最佳设置是 rf/lognorm(m=0.00, s=1.00)——在 5/10/20/25+ 步采样下都稳定优于 eps/linear 等扩散公式与原始 RF;论文还给了重尾的f_mode(u;s)(s=0 退化为均匀)作为对照。结论:原始 RF 只在极少步占优、步数一多就退化,而重加权 RF 在各步数区间一致更优。
多阶段流程
- 预训练:256² 低分辨率,batch size 4096,2×2 patch,预编码数据上训 500k 步(scaling 实验);最大模型 depth=38 在 3×10⁵ 步处调 lr 防发散。
- 高分辨率微调:混合宽高比、加 QK-RMSNorm 稳定,目标分辨率上调到 512²、1024²。
- 分辨率相关的 timestep shift:高分辨率像素更多、需更多噪声破坏信号——把低分辨率 schedule 按
t_m = (√(m/n)·t_n)/(1+(√(m/n)−1)t_n)平移(对应 log-SNR 偏移log(n/m))。人评偏好 shift>1.5;1024² 训练/采样均用 α=3.0。 - 偏好对齐:1024² shift 训练后用 DPO(Direct Preference Optimization) 对齐——按 Wallace et al. (2023) 的 diffusion-DPO 方法,只给所有线性层加 LoRA(rank=128),8B 模型微调 2k 步(2B 微调 4k 步),仅做 128 个 Parti-prompt 的人评(附录 C);论文对 DPO 只报告人评偏好,未单列 DPO 的 GenEval 分。Table 5 中同分辨率对比可见 DPO 增益:depth=38 在 512² 从 base 的 0.68 提到 w/DPO 0.71;最终 1024² w/DPO 行为 0.74(该提升同时含分辨率上调与 DPO,非 DPO 单独贡献)。
文本编码器 dropout(灵活推理的来源):训练时三个 text encoder 各以 46.3% 的概率独立 drop,因而推理时可任取子集。去掉 T5(省 4.7B 显存)对美学无影响(win rate 50%)、对 prompt adherence 小降(46%),但对复杂排版/长文本拼写影响明显(38%)——故复杂文字场景建议保留 T5。
优化器/精度:AdamW;对照实验 global batch 1024、lr 1e-4、1000 步线性 warmup、mixed-precision;大模型高分辨率用 bf16-mixed + QK-RMSNorm + ε=1e-15。
Infra(训练 / 推理工程)
- 算力:最大 8B 模型总训练 5×10²² FLOPs(论文给出的总量;未披露 GPU 型号/卡数/GPU·时)。
- 可预测 scaling:验证损失随模型规模与训练步数平滑下降,且与 GenEval / 人评 ELO / T2I-CompBench 强相关——验证损失被当作「便宜的总体性能预测量」;趋势未见饱和。
- 训练稳定性:QK-RMSNorm 让高分辨率训练能停在 bf16-mixed(否则要全精度,慢约 2×)。
- 数据预编码:latent + 文本表示离线预算,省训练时前向。
- 推理(官方博客):8B 模型可装进 RTX 4090 的 24GB 显存;早期未优化下 50 步生成 1024² 图约 34 秒。发布提供 800M–8B 多规格以降低硬件门槛。更大模型反而更省步数:depth=38 在 5/50 步时相对 50 步的 CLIP 分仅降 2.71%(depth=15 为 4.30%)、20/50 步仅 0.08%(depth=15 为 0.21%),且 path length 更短(185.96 vs 191.13)——大模型更贴合 RF 的直线目标,能少步采样。
- T5 可选:推理去 T5 显著降显存,代价仅在复杂排版。
评测 benchmark(把效果讲清楚)
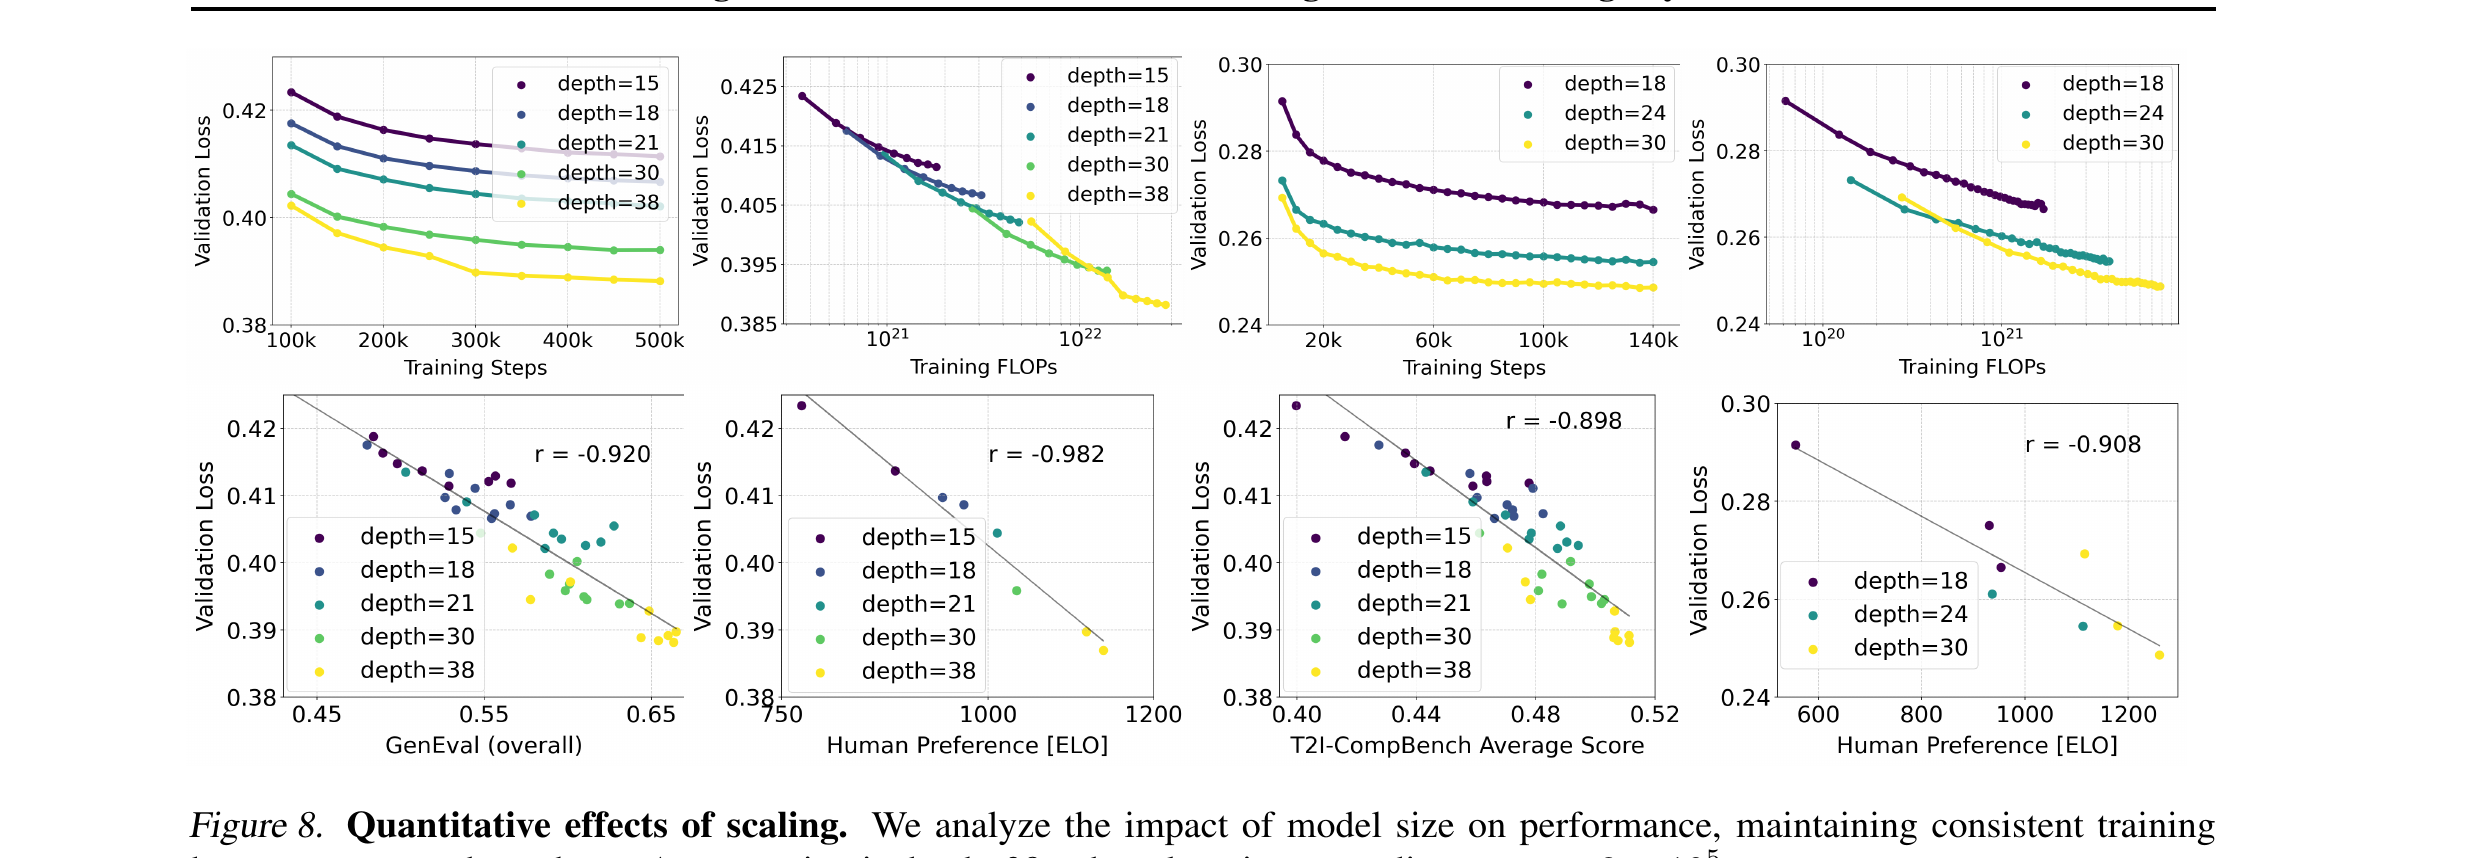
图源:SD3 论文 Figure 8 — Quantitative effects of scaling(上排:validation loss vs 训练步数/FLOPs;下排:validation loss 与 GenEval / Human-Pref ELO / T2I-CompBench 的强相关,r≈−0.92~−0.98),https://arxiv.org/abs/2403.03206
GenEval(Table 5,越高越好;Ours 为各深度)
| 模型 | Overall | Single | Two | Counting | Colors | Position | Color Attr. |
|---|---|---|---|---|---|---|---|
| SDXL | 0.55 | 0.98 | 0.74 | 0.39 | 0.85 | 0.15 | 0.23 |
| SDXL Turbo | 0.55 | 1.00 | 0.72 | 0.49 | 0.80 | 0.10 | 0.18 |
| IF-XL | 0.61 | 0.97 | 0.74 | 0.66 | 0.81 | 0.13 | 0.35 |
| DALL·E 3 | 0.67 | 0.96 | 0.87 | 0.47 | 0.83 | 0.43 | 0.45 |
| Ours depth=18 (512²) | 0.58 | 0.97 | 0.72 | 0.52 | 0.78 | 0.16 | 0.34 |
| Ours depth=24 (512²) | 0.62 | 0.98 | 0.74 | 0.63 | 0.67 | 0.34 | 0.36 |
| Ours depth=30 (512²) | 0.64 | 0.96 | 0.80 | 0.65 | 0.73 | 0.33 | 0.37 |
| Ours depth=38 (512²) | 0.68 | 0.98 | 0.84 | 0.66 | 0.74 | 0.40 | 0.43 |
| Ours depth=38 (512² w/DPO) | 0.71 | 0.98 | 0.89 | 0.73 | 0.83 | 0.34 | 0.47 |
| Ours depth=38 (1024² w/DPO) | 0.74 | 0.99 | 0.94 | 0.72 | 0.89 | 0.33 | 0.60 |
→ 8B 最终模型 overall 0.74,超过 DALL·E 3(0.67,此前 prompt comprehension 的 SOTA);Two Objects 0.94、Color Attribution 0.60 尤为突出。
人评(Parti-prompts pairwise,Figure 7):depth=38(8B)在 visual aesthetics / prompt following / typography 三维上,对专有模型(DALL·E 3、Midjourney v6、Ideogram v1.0)与开源模型(SDXL Turbo、Playground v2.5、Pixart-α、Stable Cascade)均等于或胜出。官方博客明确:SD3 在 typography 与 prompt adherence 上「equal to or outperforms」当时所有 SOTA T2I 系统。
Autoencoder 重建(Table 3,f=8):通道数 4→8→16:FID 2.41→1.56→1.06;LPIPS 0.85→0.68→0.45;SSIM 0.75→0.79→0.86;PSNR 25.12→26.40→28.62。故选 d=16。
Caption 混合消融(Table 4,GenEval overall):原始 43.27 → 50/50 合成混合 49.78。
架构对比(Figure 4,CC12M):MMDiT 在 validation loss / CLIP / FID 三项上均优于 vanilla DiT、CrossDiT(cross-attention DiT)、UViT;vanilla DiT 弱于 UViT,CrossDiT 优于 UViT,MMDiT 显著最优;三套权重相对两套仅微增。
采样效率(Table 6):见 Infra——大模型少步采样退化更小、path length 更短。
RF 公式对比(Table 1/2、Figure 3):61 种公式全局排名中 rf/lognorm(0.00,1.00) 稳居前列;25 步以上仅它能与 eps/linear 抗衡,少步区间 RF 系完胜。
消融总结:① 隐通道 d=16 优于 4/8;② 50/50 合成 caption 显著优于纯原始;③ MMDiT 两套权重为性价比最优点;④ lognorm(0,1) 时间步加权是最佳 RF 训练目标;⑤ 1024² + shift α=3.0 + DPO 是最终配方。
创新点与影响
核心贡献
- 改进的 rectified flow 训练目标:logit-normal 时间步加权(最优 m=0,s=1),用大规模控制实验证明重加权 RF 在全步数区间一致优于标准扩散与原始 RF。
- MMDiT 架构:文本/图像双流(各持权重)+ attention 处拼接共享的双向信息流,显著改善 prompt 遵从、排版与人评偏好;并被证明可扩展到视频。
- 系统的可预测 scaling:到 8B / 5×10²² FLOPs 无饱和,validation loss 与 GenEval/人评/CompBench 强相关,可作为低成本性能代理。
- 若干工程要点:d=16 VAE、CogVLM 50/50 re-caption、QK-RMSNorm 稳定 bf16 训练、分辨率相关 timestep shift(α=3.0)、三 text-encoder 灵活 drop(T5 可选省显存)、DPO 对齐。
影响:奠定了「DiT/MMDiT + flow matching/rectified flow」成为 2024 后文生图主流范式;同一批核心作者随后创立 BFL 推出 flux-1(MMDiT 升级 + guidance/step 蒸馏)。SD3.5、众多开源 T2I(如对位置编码、shift、re-caption 的复用)均受其影响。开放权重(800M–8B)降低了社区门槛。
已知局限:Counting/Position/Color Attribution 等组合泛化仍未满分(如 Position 1024² 仅 0.33);复杂排版强依赖 4.7B 的 T5(显存大);内部训练数据来源/规模、确切 GPU 算力未披露;早期 SD3 Medium(2B)实际发布版在解剖结构(手/人体)上有口碑问题(论文未涉及该发布版本)。
原始链接
- arxiv_abs: https://arxiv.org/abs/2403.03206
- arxiv_pdf: https://arxiv.org/pdf/2403.03206
- blog: https://stability.ai/news/stable-diffusion-3-research-paper
一手源存档(sources/)
- arxiv-2403.03206.pdf (arXiv 原文 PDF,不入 git)
- arxiv-2403.03206.txt
- blog.md