一句话定位
CogVideoX 是智谱 AI / 清华开源的大规模文生视频扩散 Transformer(DiT),用 3D 因果 VAE(8×8×4 压缩)+ Expert Transformer(Expert AdaLN + 3D 全注意力) 生成 10 秒、16 fps、最高 768×1360 分辨率的连贯长视频;CogVideoX-5B 在 VBench 多项指标取得开源 SOTA,人评全维度胜过闭源 Kling(总分 2.74 vs 2.17),是首个商用级开源文生视频模型。
背景与定位
解决的核心问题:此前的视频生成模型普遍运动幅度有限、时长短(2–3 秒)、难以根据复杂文本生成连贯叙事。论文给出的标志性难例是”一道闪电劈开石头,一个人从石头里跳出来”这类带动态情节的 prompt。
技术脉络上,CogVideoX 是 cogvideo(2022,智谱自家自回归文生视频)的扩散版后继,把 backbone 从自回归 Transformer 换成 ddpm/latent-diffusion-ldm 路线的扩散 Transformer(DiT,Peebles & Xie 2023),对标 Sora(OpenAI 2024)所展示的 DiT 文生视频范式。相对前置工作的关键改进:
- 相比 stable-video-diffusion(SVD)等”微调 2D VAE”方案,改用从零训练的 3D 因果 VAE,同时在时空两个维度压缩,显著降低序列长度、训练算力并抑制帧间闪烁。
- 相比 make-a-video / imagen-video / phenaki 等”低分辨率短视频 + 级联超分/插帧”的多模型拼接路线,CogVideoX 用单一 DiT 端到端直接生成长视频。
- 相比分离时空注意力(spatial + temporal)的常见做法,提出 3D 全注意力,解决大幅运动物体的跨帧一致性问题。
模型规模上完成了 5B 与 2B 两档,并配套开源了文生视频(T2V)、图生视频(I2V)版本、3D VAE 和视频字幕模型(CogVLM2-Caption)。
模型架构
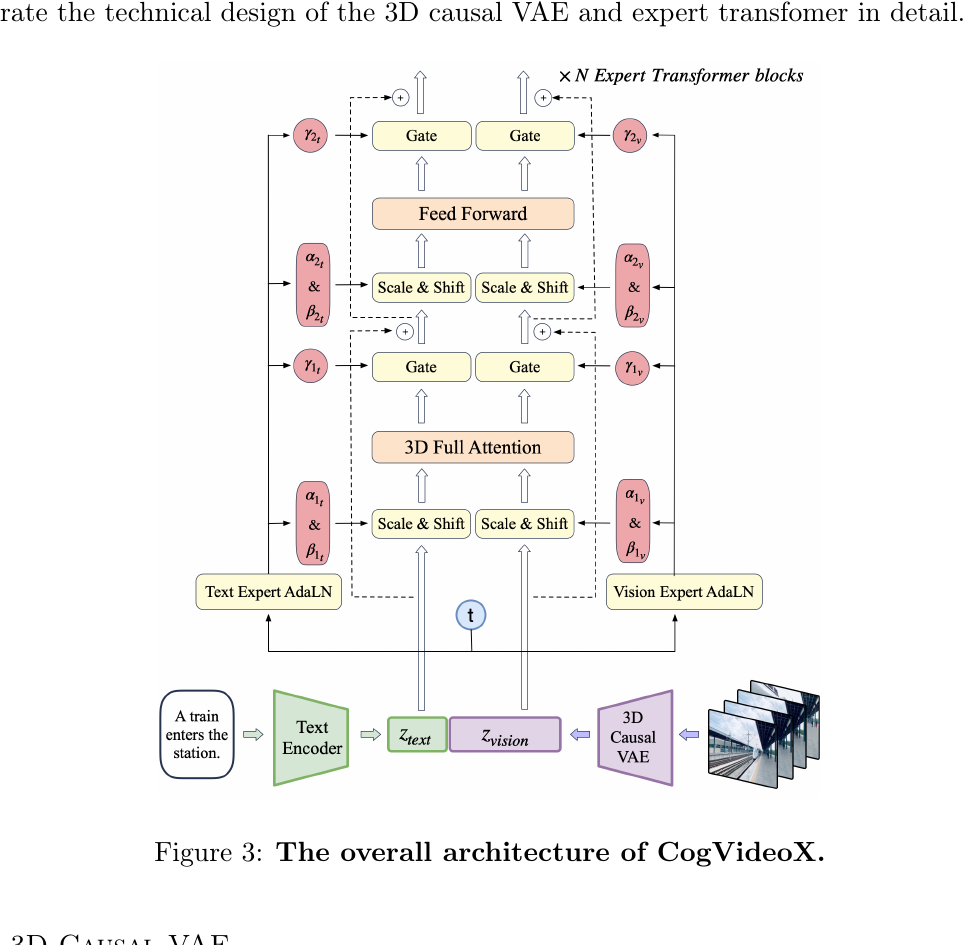
图源:CogVideoX 论文 Figure 3 “The overall architecture of CogVideoX”(arXiv:2408.06072)
整体流程(论文 Figure 3):视频经 3D 因果 VAE 压缩为 latent → patchify 展平为视觉序列 z_vision;文本经 T5(Raffel 2020;论文正文只写”T5”,未点明具体规格,diffusers 实现用 T5-v1.1-XXL) 编码为 z_text;两者沿序列维拼接,送入一叠 Expert Transformer block;输出 unpatchify 还原 latent 后由 3D VAE 解码器重建视频。
3D 因果 VAE(visual tokenizer)
- 结构:encoder + decoder + KL 正则器,编解码对称、由 ResNet block 堆叠的阶段交错完成 2× 下/上采样;部分 block 做 3D 下采样、部分只做 2D 下采样。最终从像素到 latent 实现 8×8×4 压缩(空间 8×8、时间 4×)。
- 时间因果卷积(temporally causal conv):所有 padding 放在卷积起始端,保证未来信息不泄漏到当前/过去。
- 消融(Table 1,baseline 为 SDXL 2D VAE,8×8×1,4 通道):选用变体 B(8×8×4,latent 通道 16,Flickering 86.3,PSNR 28.7)做预训练。压缩过激(16×16×8)即使加大通道也难收敛。
Expert Transformer
- Patchify:3D VAE 输出 latent 形状
T×H×W×C,patch 后序列长度T/q · H/p · W/p;当 q>1 时在序列开头重复视频/图像首帧,以支持图像-视频联合训练。 - 3D-RoPE:把 1D 旋转位置编码独立施加到 (x, y, t) 三个坐标维,分别占 hidden 通道的 3/8、3/8、2/8,再沿通道拼接。消融显示 3D-RoPE 收敛明显快于正弦绝对位置编码。
- Expert Adaptive LayerNorm(Expert AdaLN,核心创新):文本与视频在输入端拼接,但两模态特征空间尺度差异大。沿用 DiT 思路用扩散 timestep t 作调制输入,分设 Vision Expert AdaLN 与 Text Expert AdaLN 各自调制视觉/文本隐状态。相比 MMDiT(两套独立 Transformer),Expert AdaLN 用极少额外参数即可对齐两模态特征空间,更接近现代 LLM、更易 scale up。消融(Figure 8):同参数量下 Expert AdaLN 的 FVD/CLIP4Clip 显著优于无 Expert AdaLN 及同参数 MMDiT。
- 3D 全注意力:放弃分离时空注意力,用 3D 文本-视频混合全注意力。论文指出分离注意力需大量隐式跨 patch 传递视觉信息,大幅运动时一致性差;2D+1D 在模型放大(如 5B)时训练易崩溃。借助 FlashAttention,序列变长带来的推理开销可接受(Table 8:768×1360×5s 单步 3D 9.60s vs 2D+1D 4.17s)。
参数与分辨率策略(Table 6)
- CogVideoX-2B:30 层、32 头、hidden 1920、正弦位置编码、FP16 训练。
- CogVideoX-5B:42 层、48 头、hidden 3072、RoPE、BF16 训练;time embedding 256;文本长度 226;最大序列长度 82k。
- 输出:10 秒、16 fps、最高 768×1360,支持多种宽高比。(注:HF 开源的 base CogVideoX-5B 实际为 720×480 / 6 秒 / 8 fps;10s·768×1360 对应论文最终阶段与后续 CogVideoX1.5-5B。)
数据
- 规模与配比:过滤后约 35M 单镜头视频片段(平均约 6 秒),并额外用约 2B 张图像(从 LAION-5B 与 COYO-700M 按美学分过滤)辅助训练;图像被当作单帧视频与视频混合训练。
- 视频过滤:先人工标注 2 万条视频正/负样本,据此训练 6 个基于 Video-LLaMA 的过滤器,剔除负标签视频——剪辑/特效(Editing)、运动连贯性缺失、低质量(抖动/模糊)、讲课型(人持续说话少动作)、文字主导、噪声截屏。另外计算全量视频的光流分与美学分,训练中动态调阈值以保证动态性与美感。
- 重标注(re-captioning,核心数据工程):原始视频普遍缺乏高质量文本描述,且现有字幕数据集(Panda70M、COCO Caption、WebVid)字幕过短。构建 Dense Video Caption 生成管线:① Panda70M 模型生成短视频字幕;② 用 CogView3 中的 CogVLM 重标注模型对抽帧做密集图像字幕;③ GPT-4 汇总所有图像字幕生成最终视频字幕;④ 用 5 万条 GPT-4 汇总数据微调 LLaMA2 加速”图像字幕→视频字幕”。进一步微调端到端视频理解模型 CogVLM2-Caption(基于 CogVLM2-Video + Llama3)做大规模视频重标注。所有训练视频均被该管线重新打标,论文称这显著提升了生成质量与语义对齐。
- 高质量微调子集:最终阶段选取约 20% 更高质量子集做 FT,有效去除生成的字幕/水印、略升画质(但观察到语义能力轻微下降)。
- 推理端 prompt 上采样:训练/推理分布对齐,用微调过的 LLM(I2V 用 GPT-4V/CogVLM 等 VLM)把用户短 prompt 改写得更详细。
训练方法
- 扩散设定:采用 v-prediction(Salimans & Ho 2022)+ zero SNR(Lin et al. 2024),噪声调度沿用 LDM。
- 多分辨率 Frame Pack(混合时长训练):受 Patch’n’Pack(NaViT)启发,把不同时长/分辨率视频放进同一 batch 保证 batch 内形状一致,避免”图像单帧 vs 视频多帧”导致的双模式分化与短视频丢弃/长视频截断的数据浪费。RoPE 适配不同分辨率用**外推(extrapolation)**而非插值(保留局部细节与相对位置)。
- 渐进式训练(progressive training):先在 256px 学语义与低频信息,再逐级升到 512px、768px 学高频细节;保持宽高比、缩放短边。最后做高质量 FT。
- Explicit Uniform Sampling(显式均匀采样,创新 trick):扩散 loss 量级随 timestep 变化,常规各 data-parallel rank 各自在 [1, T] 随机采样不够均匀、loss 波动大。改为把 [1, T] 划成 n 个区间(n=rank 数),每 rank 只在自己区间内均匀采样。消融(Table 9,40k 步)显示所有 timestep 上 loss 都更低且更稳,加速收敛。
- 图生视频(I2V):从 T2V 模型微调;图像过 3D VAE 后在通道维与噪声输入拼接(参考 SVD);为缩小训练/推理分布差距(视频首帧 vs 真实图像),训练时对图像条件加大噪声以增强鲁棒性。
- 关键超参(Table 6):weight decay 1e-4,Adam ε 1e-8、β1 0.9、β2 0.95,cosine 学习率衰减,梯度裁剪 1.0,最低美学分阈值 4.5。
- 训练四阶段(Table 5):stage1 256×384/6s,batch 2000,序列 25k,400k 步 → stage2 480×720/6s,batch 1000,序列 75k,220k 步 → stage3 768×1360/10s,batch 250,序列 700k,120k 步 → stage4(FT) 768×1360/10s,batch 100,序列 700k,10k 步。
Infra(训练 / 推理工程)
- 3D VAE 训练:先在 256×256 / 17 帧训练省算力(随机选 8 或 16 fps 增鲁棒);因无注意力模块,可零样本编码更大分辨率,但更多帧不行——故两阶段:先 17 帧、再用 context parallel 在 161 帧上微调。损失为 L1 重建 + LPIPS 感知 + KL 的加权组合,数千步后加入 3D 判别器的 GAN loss。
- 时间维 context parallel:为降低长视频的显存占用,对 3D 卷积在时间维做 context parallel;因卷积因果性,每个 rank 只需把长度 k−1(k 为时间核大小)的片段传给下一 rank,通信开销低。
- 并行/精度:2B 用 FP16、5B 用 BF16 训练;3D 全注意力借 FlashAttention 加速,并易适配各种并行加速。
- 推理耗时与显存(Table 7,H800,50 步):5B-480×720-6s 113s/26GB,5B-768×1360-5s 500s/76GB;2B-480×720-6s 49s/18GB,2B-768×1360-5s 220s/53GB。
- 部署/量化(HF model card):5B base 为 720×480/6s/8fps;SAT BF16 单卡 26GB,diffusers BF16 最低 5GB、INT8(torchao) 最低 4.4GB(2B 可低至 3.6GB,能跑免费 T4 Colab);推理精度支持 FP16/BF16/FP32/FP8/INT8(不支持 INT4);FP8 需 H100 及以上;INT8(torchao) 量化兼容 torch.compile。A100 推理 5B 约 180s、H100 约 90s(含显存优化)。
- 商用形态:智谱”清影 QingYing”产品与 bigmodel API 平台提供闭源商用视频生成模型,开源版为研究/二创基座。
评测 benchmark(把效果讲清楚)
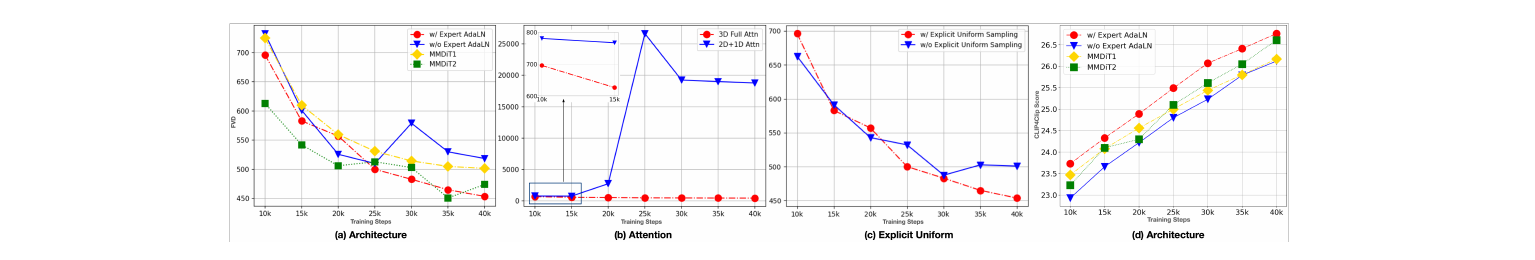
图源:CogVideoX 论文 Figure 8 “Ablation studies on WebVid test dataset”(arXiv:2408.06072)——(a)/(d) Expert AdaLN vs MMDiT 的 FVD/CLIP4Clip、(b) 3D 全注意力 vs 2D+1D、(c) Explicit Uniform Sampling
VAE 重建(Table 2,WebVid 验证集,256×256 17 帧):CogVideoX VAE Flickering 85.5 / PSNR 29.1,优于 Open-Sora(92.4 / 28.5)与 Open-Sora-Plan(90.2 / 27.6),抖动最少且 latent 通道更多。
自动指标 VBench 等(Table 3,节选关键列;指标含 Human Action、Scene、Dynamic Degree、Multiple Objects、Appearance Style 及 Dynamic Quality、GPT4o-MTScore):
- CogVideoX-5B:Human Action 96.8、Scene 55.44、Dynamic Degree 62.22、Multiple Objects 70.95、Appearance Style 24.44、Dynamic Quality 69.5、GPT4o-MTScore 3.36。
- CogVideoX-2B:Human Action 96.6、Scene 55.35、Dynamic Degree 66.39、Multiple Objects 57.68、Appearance Style 24.37、Dynamic Quality 57.7、GPT4o-MTScore 3.09。
- 对比同期开源/闭源:T2V-Turbo、AnimateDiff、VideoCrafter-2.0、OpenSora V1.2、Show-1、Gen-2、Pika、LaVie-2。CogVideoX-5B 在 7 项中 5 项最佳,其余两项有竞争力;GPT4o-MTScore(3.36)远超第二(VideoCrafter-2.0 的 2.68),说明时序变化幅度强。
人评对比闭源 Kling 2024.7(Table 4,0/0.5/1 三档;维度 Sensory Quality、Instruction Following、Physics Simulation、Cover Quality):CogVideoX-5B 全维度胜出——0.722 / 0.495 / 0.667 / 0.712,总分 2.74 vs Kling 2.17。
关键消融结论:① 3D-RoPE 收敛快于绝对位置编码;② Expert AdaLN 优于无 Expert AdaLN 及同参数/同层 MMDiT(FVD、CLIP4Clip 全面更好),且参数更省、更易 scale;③ 3D 全注意力优于 2D+1D(2D+1D 早期 FVD 高且易崩溃,5B 规模更明显);④ Explicit Uniform Sampling 在全部 timestep 上 loss 更低、曲线更稳。
创新点与影响
核心贡献:① 从零训练的 3D 因果 VAE(8×8×4,时间因果卷积 + context parallel),同时压缩时空、抑制闪烁;② Expert Transformer = Expert AdaLN + 3D 全注意力 + 3D-RoPE,以远少于 MMDiT 的参数对齐文本-视频两模态、保证大运动一致性;③ 多分辨率 Frame Pack + 渐进式训练 + Explicit Uniform Sampling 的工程化训练配方;④ 完整的视频过滤 + Dense Video Caption 重标注数据管线,并开源 CogVLM2-Caption 字幕模型;⑤ 首个商用级开源文生视频系列(2B/5B、T2V/I2V、VAE、字幕模型全开源),2B 转 Apache 2.0 许可。
影响:作为国产开源文生视频代表,CogVideoX 成为社区广泛微调/二创/LoRA/ControlNet 化的基座(diffusers 一等公民),低显存量化(2B INT8(torchao) 最低 3.6GB、5B 最低 4.4GB,HF card)大幅降低使用门槛;其 3D VAE + Expert AdaLN + 3D 全注意力的设计被后续开源视频模型大量参考。后续迭代 CogVideoX1.5-5B(2024-11)支持 10 秒更高分辨率、I2V 支持任意分辨率。
已知局限:① 论文承认更激进的 VAE 压缩(16×16×8)难收敛,留作未来工作;② 高质量 FT 去水印/字幕的同时语义能力轻微下降;③ 仍在探索视频生成 scaling law,未给出明确缩放规律;④ 训练总算力/GPU·时未在论文中披露(未报告);⑤ I2V 存在训练(视频首帧)与推理(真实图像)分布差距,靠加噪缓解。
原始链接
- arxiv_abs: https://arxiv.org/abs/2408.06072
- arxiv_pdf: https://arxiv.org/pdf/2408.06072
- github: https://github.com/THUDM/CogVideo
- hf_model: https://huggingface.co/THUDM/CogVideoX-5b
- demo_site: https://yzy-thu.github.io/CogVideoX-demo/
- product: https://chatglm.cn/video (清影 QingYing)
一手源存档(sources/)
- arxiv-2408.06072.pdf (论文 PDF,gitignore 不入 git,本地已精读)
- readme.md (GitHub THUDM/CogVideo README)
- hf-5b-card.md (HF THUDM/CogVideoX-5b model card)