一句话定位
Stable Diffusion v1 是把 latent-diffusion-ldm(CVPR’22 的 LDM)产品化的开源文生图模型:用 下采样因子 8 的 KL-VAE 把 512×512 图像压到 64×64×4 潜空间,在其中训练一个 860M 参数 U-Net,并用 冻结的 CLIP ViT-L/14 文本编码器 通过交叉注意力做条件。它是首个权重完全开源、能在 ≥10 GB(发布时实测 6.9 GB)消费级显存上跑出高质量出图的潜扩散模型,直接引爆了开源 AIGC 生态(ControlNet / LoRA / DreamBooth / WebUI 几乎全建立其上)。
背景与定位
2022 年的高质量文生图(dall-e-2、Google imagen、glide)都在像素空间直接跑扩散,训练动辄数百 GPU·天、推理昂贵,且权重闭源。LDM 论文的核心洞察是把图像生成拆成两段:先用自编码器做感知压缩(去掉人眼不敏感的高频细节),再在低维潜空间里训练扩散模型做语义压缩——这样既保留细节保真度,又把扩散主干的计算量降一个量级(论文称相比像素扩散显著降低训练与采样成本)。SD v1 就是这套方法在 Stability AI 捐赠算力 + LAION 数据 + Runway/CompVis 工程下的规模化落地版本。
与 LDM 原论文的文生图模型有两点关键差异(来自 GitHub README 与 HF model card 一手源):
- 原论文文生图用的是 1.45B 参数 KL-LDM + BERT-tokenizer + 自训练 transformer 文本编码器,在 LAION-400M 上训练;
- SD v1 改用 冻结的 CLIP ViT-L/14(“as suggested in the Imagen paper”),并把训练数据换成更大的 LAION-2B(en) 及其美学子集,U-Net 为 860M。
定位:它不是方法上的全新突破(方法来自 LDM/Imagen),而是首个把”开源权重 + 消费级可跑 + 高质量”三者凑齐的工程里程碑,significance 在于”民主化”。
模型架构
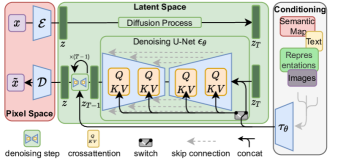
图源:High-Resolution Image Synthesis with Latent Diffusion Models (LDM, arXiv:2112.10752) Fig.3 — LDM 条件机制(concatenation / cross-attention),https://arxiv.org/abs/2112.10752
来自 GitHub README、HF v1-4 model card、LDM 论文 Sec.3:
- Backbone:U-Net(diffusion model),约 860M 参数,OpenAI ADM(guided-diffusion)代码库改造而来,含交叉注意力层。
- First-stage autoencoder(VAE):KL 正则化的 VAE,下采样因子 f=8,把 H×W×3 图像编码为 H/8 × W/8 × 4 通道潜表示(即 512×512 → 64×64×4)。论文对比了 f∈{1,2,4,8,16,32},发现 f=4/8 是”复杂度压缩 vs 细节保留”的近最优点;SD v1 取 f=8。该自编码器是”通用编码阶段,只训一次即可复用于多个扩散训练”。
- Text encoder:冻结、预训练的 CLIP ViT-L/14(约 123M 参数),取其 non-pooled(逐 token)输出,经交叉注意力注入 U-Net(Q 来自 U-Net 特征,K/V 来自文本嵌入)。文本编码器在扩散训练中不更新。
- 条件注入:cross-attention,Q=W_Q·φ(z_t),K=W_K·τ(y),V=W_V·τ(y)(τ 即文本编码器)。
- 分辨率策略:先在 256×256 预训练,再在 512×512 微调(详见数据/训练)。借助卷积式采样,模型可在更大分辨率上泛化生成。
- 轻量化:README 明确”860M U-Net + 123M text encoder,相对轻量,≥10 GB 显存可跑”;Stability 发布博客称发布版显存占用 6.9 GB。
数据
来自 HF model card(v1-1/v1-4/v1-5)、GitHub README、LDM 论文:
- 基础数据集:LAION-2B(en) 及其子集(LAION-5B 的英文部分)。
- 分阶段数据配比(checkpoint 演进,按 model card 原文):
v1-1:256×256 在 laion2B-en 训 237k 步;再 512×512 在 laion-high-resolution(LAION-5B 中分辨率 ≥1024×1024 的约 170M 例)训 194k 步。v1-2:从 v1-1 续训,512×512 在 laion-improved-aesthetics(laion2B-en 子集,过滤条件:原始尺寸 ≥512×512、美学分 >5.0、水印概率 <0.5)训 515k 步。v1-3/v1-4/v1-5:均从 v1-2 续训(注意三者皆 resume 自 v1-2,非链式),512×512 上分别训 195k / 225k / 595k 步,并 10% 概率丢弃文本条件以增强 CFG。数据集名一手源不一致:HF v1-4/v1-5 card 写 v1-3 用 “laion-improved-aesthetics”、v1-4/v1-5 用 “laion-aesthetics v2 5+“;GitHub README 则把 v1-3/v1-4 都写成 “laion-aesthetics v2 5+“(两者应为同一美学子集的不同命名,原文未澄清差异)。inpainting:从 v1-5 续训 440k 步,U-Net 加 5 个输入通道(4 编码遮挡图 + 1 mask),合成随机 mask,25% 概率全图 mask。
- 清洗/过滤:美学打分用 LAION-Aesthetics Predictor V2(improved-aesthetic-predictor);水印概率来自 LAION-5B 元数据。
- 标注:直接用 LAION 的 alt-text 图文对,未做 re-captioning(这点弱于后来的 DALL·E 3 / SDXL)。
- 已知问题(model card 自述):未做去重,存在记忆化(duplicated 图像);含成人内容,未经额外安全处理不宜直接产品化;以英文为主,非英文与西方以外文化表现差。
训练方法
来自 HF v1-4/v1-5 model card 与 LDM 论文:
- 训练目标:标准 DDPM 去噪目标(在潜空间),损失为 U-Net 预测噪声 ε_θ(z_t, t, τ(y)) 与真实噪声的 MSE 重构(LDM 论文式(3))。非 flow matching(rectified flow 是后来 SD3 才用)。
- 多阶段训练:256×256 预训练 → 512×512 续训 → 在美学子集上续训;checkpoint 树为 v1-1 → v1-2,再由 v1-2 并行分叉出 v1-3 / v1-4 / v1-5(model card 原文:三者均 “Resumed from v1-2”,非 v1-2→v1-3→v1-4 链式),每一版都是 resume 续训而非从头。
- Classifier-free guidance:v1-3 起在续训中 10% 丢弃文本条件,使模型同时学到有条件/无条件分布;推理默认 guidance scale 7.5。
- 采样器:参考脚本默认 PLMS(50 步),diffusers 默认 PNDM;亦支持 DDIM、Euler 等。
- EMA:发布的推理 checkpoint 为 EMA-only。
- 关键超参(v1-4/v1-5 一致,model card 原文):
- Hardware:32 × 8 × A100 = 256 张 A100
- Optimizer:AdamW
- Gradient accumulation:2
- Batch:32×8×2×4 = 2048
- LR:warmup 到 1e-4(10k 步)后保持恒定
- 加速/蒸馏:SD v1 本身未做步数蒸馏(LCM/ADD/Turbo 都是后续社区/Stability 工作);img2img 借鉴 SDEdit(加噪再去噪做编辑/上采样)。
Infra(训练 / 推理工程)
- 算力:256 张 A100(PCIe 40GB);model card 估算累计 150,000 A100·小时,碳排约 11,250 kg CO2 eq(AWS US-east,按 ML CO2 calculator 估)。
- 训练基础设施伙伴:算力由 Stability AI 捐赠;发布工程由 Stability AI + Runway + CompVis 合作,CoreWeave(GPU 云)提供工程支持,HuggingFace 提供法务/伦理/发布支持(Stability 博客一手源)。
- 代码栈:扩散主干 fork 自 OpenAI ADM(guided-diffusion) 与 lucidrains 的 denoising-diffusion-pytorch;transformer 编码来自 x-transformers;推理参考脚本含 Safety Checker 与 invisible-watermark 不可见水印。
- 公开发布默认权重:Stability 博客原文 “the recommended model weights are v1.4 470k, and a few extra training steps from the v1.3 440k model”——即 2022-08 公开发布主推 v1-4 检查点(v1-5 后续由 Runway 放出)。
- 推理部署:发布版 6.9 GB VRAM(博客一手数字);支持 fp16/bf16(diffusers 提供
enable_attention_slicing,v1-4 card 称 fp16 可在 <4 GB GPU 上跑);可走 PyTorch 与 JAX/Flax(TPU)。博客承诺后续优化 AMD / Mac M1/M2。
评测 benchmark(把效果讲清楚)
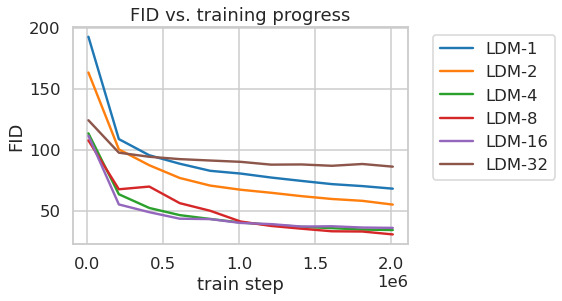
图源:LDM 论文 (arXiv:2112.10752) Fig.6 — 不同下采样因子 f 的 class-conditional LDM 在 ImageNet 上 2M 步训练的 FID/IS 曲线,显示 LDM-4/8 收敛最快、像素扩散 LDM-1 最慢(即 SD v1 选 f=8 的依据),https://arxiv.org/abs/2112.10752
SD v1 的 model card 本身只给了一张”不同 CFG scale(1.5/2/3/4/5/6/7/8)下各 checkpoint 相对改进”的曲线图(v1-1→v1-4/v1-5),并明确声明”未针对 FID 优化”;评测设置为 COCO2017 验证集 10000 随机 prompt、512×512、50 PLMS 步,但未在文字中给出任何 FID/CLIP 绝对值数字(card 原文只有图,且未注明纵轴指标)。因此绝对数字只能以底层 LDM 论文为准:
- LDM 论文 MS-COCO 256×256 文生图(Table 2)(这是 1.45B LDM-KL-8 版本,非 SD v1 本体,但同方法):
- LDM-KL-8(无引导):FID 23.31,IS 20.03,1.45B 参数,250 DDIM 步;
- LDM-KL-8-G(CFG s=1.5):FID 12.63,IS 30.29,1.45B 参数 —— 与同期 SOTA GLIDE(FID 12.24,6B 参数)、Make-A-Scene(FID 11.84,4B 参数)基本持平,但参数量显著更小。
- LDM 在 class-conditional ImageNet 上优于 ADM(参数减半、训练资源约 1/4);在 inpainting / super-resolution / LSUN 等多任务上达到或接近 SOTA。
- 消融关键结论(LDM 论文):f=1/2(下采样太小)训练慢;f 太大(16/32)保真度早早饱和;f=4/8 为最优区间——这是 SD v1 选 f=8 的依据。
- SD v1 自身:model card 只给相对帕累托改进,未报告 SD v1 在 COCO 上的绝对 FID/CLIPScore 数字,也未报告 GenEval / T2I-CompBench / HPSv2 等(这些 benchmark 当时尚未流行或 SD 团队未跑)。
注:GenEval、DPG-Bench、PickScore、ImageReward 等现代评测体系晚于 SD v1,一手源中未报告,此处不臆造。
创新点与影响
核心贡献
- 把 LDM 方法规模化并完全开源:权重 + 代码 + model card 一次性 OpenRAIL-M 许可放出,允许商用——这是与 DALL·E 2 / Imagen(闭源)的根本分野。
- 消费级可跑:6.9 GB VRAM 出 512×512 高质量图,把文生图从”几家大厂特权”变成”任何有显卡的人都能玩”。
- 冻结 CLIP + 潜空间交叉注意力的工程组合成为后续 T2I 事实标准。
影响
- 直接催生开源 AIGC 生态:WebUI(AUTOMATIC1111)、ComfyUI、DreamBooth 微调、LoRA、Textual Inversion、ControlNet 几乎全部以 SD v1/v1.5 为底座;v1.5(Runway 595k 步版)至今仍是社区微调基线。
- 商业上推动 Stability AI 估值与 $101M 融资(博客 next 文链接),并引出后续 stable-diffusion-2 / sdxl / stable-diffusion-3 谱系。
已知局限(model card 自述)
- 非真正照片级、无法渲染清晰文字、组合推理弱(“红方块在蓝球上”易错)、人脸常崩;
- VAE 是有损的;英文偏置、西方文化默认;
- 数据含成人内容且未去重,有记忆化与版权争议(LAION alt-text 直接训练)。
原始链接
- github: https://github.com/CompVis/stable-diffusion
- hf (v1-4): https://huggingface.co/CompVis/stable-diffusion-v1-4
- hf (v1-1, 全训练日程): https://huggingface.co/CompVis/stable-diffusion-v1-1
- hf (v1-5, Runway / sd-legacy): https://huggingface.co/sd-legacy/stable-diffusion-v1-5
- blog (Stability 公开发布): https://stability.ai/news/stable-diffusion-public-release
- paper (LDM, CVPR’22 Oral): https://arxiv.org/abs/2112.10752
- project page: https://ommer-lab.com/research/latent-diffusion-models/
一手源存档(sources/)
- github-readme.md
- hf-v1-4-card.md
- hf-v1-1-card.md
- hf-v1-5-card.md
- stability-blog.md
- arxiv-2112.10752.pdf (LDM 论文,~39MB,.gitignore 排除,仅本地) (arXiv 原文 PDF,不入 git)