一句话定位
Classifier-Free Guidance(CFG,Ho & Salimans)提出无需任何分类器即可对条件扩散模型做”低温/截断式”引导:训练时以概率 puncond 随机丢弃条件、用同一网络联合学有条件 θ(z,c) 与无条件 θ(z) 两个分数;采样时把二者外推线性组合 ˜θ = (1+w)·θ(z,c) − w·θ(z)。仅一行代码即可在保真度与多样性间平滑权衡——在 128×128 ImageNet 上即取得当时文献 SOTA(w=0.3 时 FID 优于带分类器的 ADM-G,w=4 时 FID/IS 同时超过最佳截断的 BigGAN-deep)。该机制此后成为几乎所有文生图/视频扩散模型的标配。
背景与定位
- 要解决的问题:扩散模型早期无法像 GAN 截断(BigGAN truncation)或 Glow 低温采样那样在”质量↔多样性”之间做权衡——直接缩放分数向量或减小反向过程噪声方差只会产出模糊低质样本(Dhariwal & Nichol 2021 已指出)。
- 前置工作:Dhariwal & Nichol(2021,guided-diffusion-adm / classifier guidance)提出 classifier guidance——把扩散分数与一个在带噪数据上训练的额外图像分类器 pθ(c|zλ) 的输入梯度混合:
˜θ = θ(z,c) − w·σλ·∇z log pθ(c|z),等价于从p̃(z|c) ∝ p(z|c)·pθ(c|z)^w采样。该法能换取 IS/FID 的权衡,但有三大代价:① 训练管线复杂化、必须额外训一个带噪分类器(不能直接套预训练分类器);② 采样步骤变成对分类器的梯度对抗攻击,引出”是否只是因为对抗才刷高了基于分类器的 IS/FID 指标”的质疑;③ 沿分类器梯度走也类似 GAN 训练,让人怀疑其得分高是因为在”变成 GAN”。 - CFG 的定位:用纯生成模型回答”能否在没有分类器的情况下做引导”。它把引导信号从”外部判别器梯度”换成”条件分数 − 无条件分数”的外推,彻底剔除分类器,从而证明 IS/FID 的提升并非来自对分类器的对抗。技术脉络上承 ddpm / 连续时间扩散(score-sde、vdm)的 ε-预测与去噪分数匹配框架,下启 glide、dall-e-2、imagen、stable-diffusion-1 等几乎全部文生图工作的默认引导手段。
模型架构
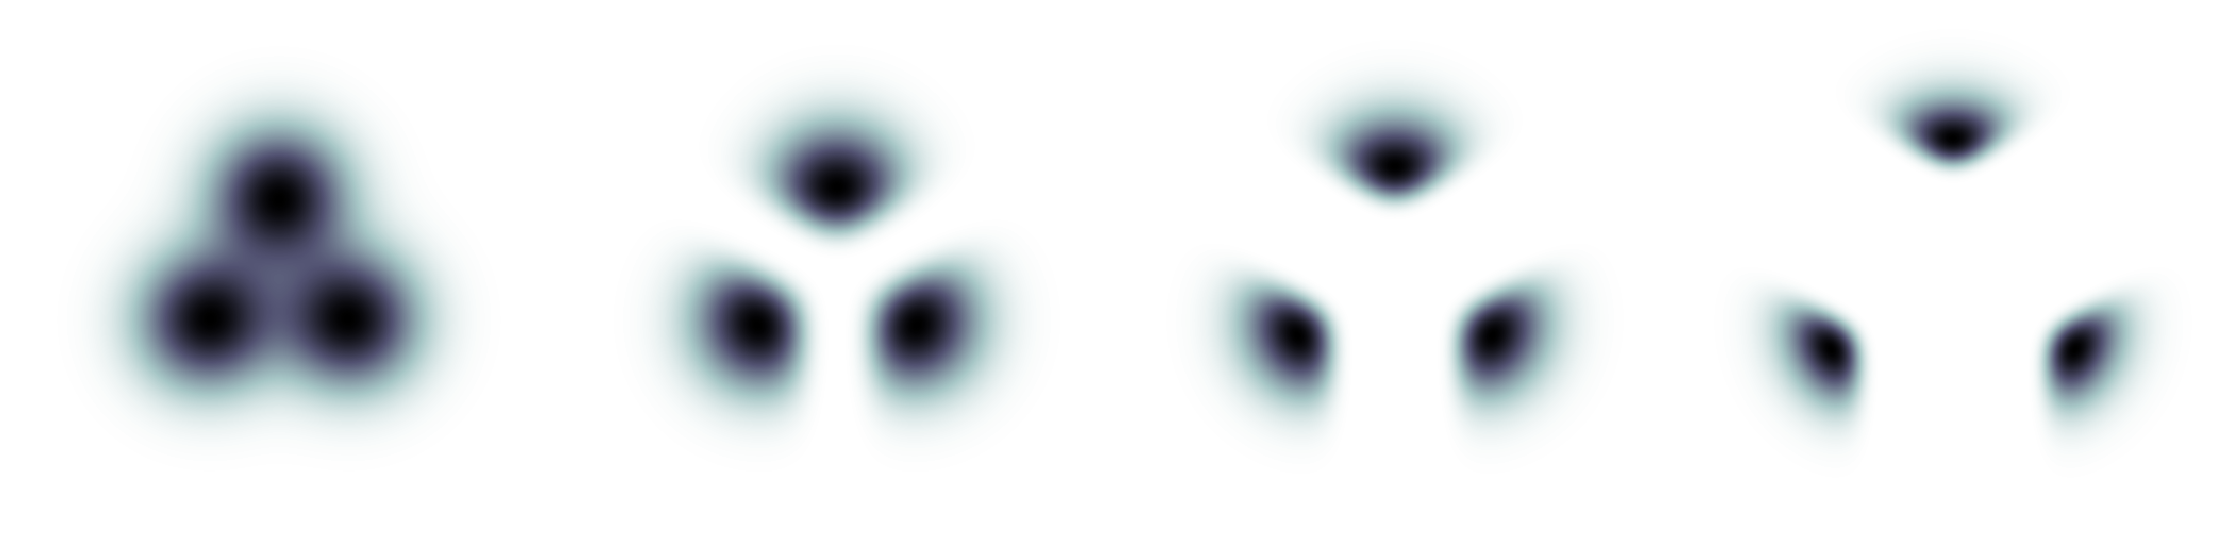
图源:Ho & Salimans, “Classifier-Free Diffusion Guidance” (arXiv:2207.12598) Figure 2 —— 三高斯混合上引导强度递增对条件密度的重塑示意(最左为非引导边缘密度),是 CFG 方法的核心直觉图。
- 不引入新架构:CFG 是一种训练+采样协议,复用 Dhariwal & Nichol(2021)guided-diffusion 的 ADM U-Net backbone 与超参(仅把离散时间换成连续时间训练)。无新增 visual tokenizer / VAE / text encoder——实验是类别条件 ImageNet 生成,条件 c 是类别标签,不是文本。
- 关键设计:单网络参数化两套分数。同一个去噪网络 θ(zλ, c) 既学有条件分数也学无条件分数——无条件时把条件 c 喂入一个空标记 ∅(null token),即
θ(zλ) = θ(zλ, c=∅)。因此不增加任何参数量,相比 classifier guidance(diffusion + 额外分类器两套网络)反而用了更少的总容量。 - 参数化:ε-prediction,
xθ(zλ) = (zλ − σλ·θ(zλ))/αλ;方差用 σ̃²(λ’|λ) 与 σ²(λ|λ’) 的对数空间插值,系数 v 为常数超参(非学习量),仅在有限步采样时起作用。 - 前向/反向过程:variance-preserving 连续时间 Markov 过程,
q(zλ|x)=N(αλ x, σλ²I),αλ²=1/(1+e^{−λ}),λ 即 log-SNR;反向从pθ(zλmin)=N(0,I)出发,沿递增 log-SNR 序列做祖先采样(ancestral sampler,可替换为 DDIM 等其他采样器)。
数据
- 数据集:面积下采样的类别条件 ImageNet(Russakovsky et al. 2015),分辨率 64×64 与 128×128——这是自 BigGAN 起研究 FID/IS 权衡的标准设定。
- 配比/清洗/合成数据:本文不涉及大规模图文数据、re-captioning、美学/安全过滤等(那是后续文生图工作的范畴)。唯一与”数据使用”相关的训练侧设计是 条件丢弃概率 puncond:训练时以 puncond 把标签替换为 ∅,等价于把一部分”数据-条件对”当作无条件样本喂入。
- 未涉及:数据规模细节、采集来源等均不适用于本方法论文(纯 ImageNet 标准基准)。
训练方法
- 训练目标:标准去噪分数匹配
E[‖θ(zλ,c) − ‖²],ε ~ N(0,I),zλ = αλx + σλε;λ 从 p(λ) 采样。p(λ) 取受 Nichol & Dhariwal 余弦噪声调度启发的分布:λ = −2·log tan(au+b)(u~U[0,1],b=arctan(e^{−λmax/2}),a=arctan(e^{−λmin/2})−b),即支撑在有界区间上的双曲正割分布。 - 核心 trick——联合训练(Algorithm 1):对每个样本 (x,c),以概率 puncond 把 c 置为 ∅(无条件),其余照常带条件;其它步骤与普通扩散训练完全一致。这是”一行代码”的全部内容。作者强调可以训两个独立模型,但选择联合训练因为实现极简、不复杂化管线、不增加参数。
- 采样——分数外推(Algorithm 2):每步用
˜t = (1+w)·θ(zt,c) − w·θ(zt),再x̃t=(zt−σλt·˜t)/αλt,按反向过程方差采下一步。w 是引导强度(注意本文记法:w=0 即非引导;与后续工作常用的 “CFG scale s=w+1” 记法相差 1)。 - 隐式分类器解释:CFG 受”隐式分类器”
pi(c|z) ∝ p(z|c)/p(z)的梯度启发——若有精确分数,则∇z log pi(c|z) = −(1/σλ)[*(z,c) − *(z)],对其做 classifier guidance 恰好给出形如 Eq.(6) 的外推。但作者明确指出:由于用的是无约束神经网络的分数估计 θ(z,c)−θ(z),它一般并非任何分类器的(缩放)梯度(非保守向量场,不存在对应标量势),因此 CFG 不是对分类器的对抗攻击。 - 训练量:64×64 模型训 40 万步;128×128 模型训 270 万步。log-SNR 端点 λmin=−20、λmax=20;64×64 用 v=0.3、128×128 用 v=0.2。
- 无蒸馏/RL/偏好对齐:本文是 2021/2022 年的纯方法论文,不含 consistency/LCM/ADD 等步数蒸馏,也无 RLHF/DPO(这些都是后续工作)。
Infra(训练 / 推理工程)
- 训练算力:论文未报告 GPU 数量 / GPU·时 / 并行策略 / 吞吐等工程指标(沿用 Dhariwal & Nichol 的架构与超参,未单独披露)。
- 推理代价(重点权衡):CFG 的主要工程缺点是采样速度——每个采样步需要两次去噪网络前向(一次 θ(z,c)、一次 θ(z))。因此与同架构的 ADM-G(论文称 T=256 与其采样步数大致相当)公平对比时,应看 CFG 的 T=128(≈相同总算力),此时 FID 略逊于 ADM-G(T=128 最佳 FID 约 3.02@w=0.4 vs ADM-G 2.97);而 T=256 时 CFG(2.43@w=0.3)已超过 ADM-G。
- 缓解思路:作者提出可通过”把条件晚注入网络”的架构改造,让两条前向共享大部分计算以降本,但留作 future work(这一思路后来被诸多工作采用)。
- 采样步数:128×128 实验扫 T∈{128,256,1024},T=256 在质量与速度间取得好平衡(再增到 1024 收益很小)。
评测 benchmark(把效果讲清楚)
全部数字来自 arxiv-2207.12598.pdf(Table 1 / Table 2,50000 样本,按 Heusel 2017 / Salimans 2016 流程计算 FID/IS)。记法 w=0 为非引导。
ImageNet 64×64(Table 1,扫 puncond∈{0.1,0.2,0.5})
- 基线:ADM(Dhariwal & Nichol)FID 2.07;CDM(Ho et al. 2021)FID 1.48 / IS 67.95。
- CFG(puncond=0.1):
- w=0.0(非引导):FID 1.80,IS 53.71
- w=0.1:FID 1.55(该模型最佳 FID),IS 66.11
- w=0.3:FID 3.03,IS 92.8
- w=1.0:FID 12.6,IS 170.1
- w=4.0:FID 26.22,IS 260.2(强引导最佳 IS)
- puncond 结论:puncond=0.5 在整条 IS/FID 前沿上一致劣于 0.1/0.2;0.1 与 0.2 表现相当。⇒ 只需把”很小一部分模型容量”分给无条件任务即可。
- FID 随 w 单调下降到极小值后回升、IS 随 w 单调上升,构成清晰的质量↔多样性权衡曲线。
ImageNet 128×128(Table 2,扫 T∈{128,256,1024})
- 基线:BigGAN-deep FID 5.7 / IS 124.5(max-IS 截断时 FID 25 / IS 253);CDM FID 3.52 / IS 128.8;LOGAN FID 3.36 / IS 148.2;ADM-G(classifier-guided)FID 2.97。
- CFG(T=256):
- w=0.0:FID 7.27,IS 82.45
- w=0.3:FID 2.43,IS 158.47 ⇒ 优于带分类器的 ADM-G(2.97),且无需分类器
- w=0.4:FID 2.49,IS 183.41
- w=4.0:FID 21.53,IS 421.03
- 关键对比结论:w=0.3 时 128×128 FID 是当时文献 SOTA、超过 classifier-guided ADM-G;w=4.0 时在最佳-IS 截断下 FID 与 IS 双双超过 BigGAN-deep。证明纯生成扩散模型不靠分类器即可逼至(甚至超过)其它生成模型族的最高保真度。
- 采样步数消融:T 越大质量越好,但 T=256≈ADM-G 步数;若按”每步两次前向”折算,公平对应 T=128,此时不及 ADM-G——这是 CFG 的速度代价所在。
定性:随 w 增大样本多样性下降、单样本保真度上升;强引导(如 w=3)会出现颜色过饱和现象(Fig.3/Fig.8)。
创新点与影响
- 核心贡献:① 提出”条件分数 − 无条件分数”外推这一无分类器引导机制,把 classifier guidance 的功能用纯生成模型实现,仅训练时一行 dropout + 采样时一行混合即可;② 用同一网络 + null token 联合学有/无条件分数,零额外参数、零管线复杂度;③ 给出”隐式分类器/Bayes 反演”的直觉解释,并澄清 CFG 因非保守向量场而不是对分类器的对抗攻击,从而消解”扩散模型刷 IS/FID 是否靠对抗/像 GAN”的质疑;④ 提出引导的统一直觉——抬高条件似然、压低无条件似然(无条件分数前的负号是关键,作者指出此前未被探索)。
- 影响:CFG 成为此后几乎所有文生图/文生视频/音频扩散模型的默认引导机制——glide、dall-e-2、imagen、stable-diffusion-1、SDXL、DiT/stable-diffusion-3 乃至视频扩散均内置 CFG scale;“晚注入条件以省一次前向""负向提示词(negative prompt)即把无条件分支替换为负条件”等工程实践都直接源自本文。后续的引导蒸馏(guidance distillation)、CFG++、动态/区间 CFG 等都建立在此之上。
- 已知局限:① 采样需两次前向,推理成本约翻倍;② 提高保真度以牺牲多样性为代价,在欠表示数据上可能放大偏差(作者明确提示部署风险);③ 强引导导致颜色过饱和等伪影;④ 隐式分类器在模型 misspecified 时无性能保证(理论上 Bayes 反演分类器可能不一致),有效性是经验性结论。
原始链接
- arxiv_abs: https://arxiv.org/abs/2207.12598
- arxiv_pdf: https://arxiv.org/pdf/2207.12598
- workshop(NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications,短版原文): https://openreview.net/forum?id=qw8AKxfYbI (PDF: https://openreview.net/pdf?id=qw8AKxfYbI)
- 说明:本工作为纯方法论文,作者未发布官方代码仓库 / HF / ModelScope / 官方博客;openreview 为其短版(workshop)正式版,无独立产品页。
一手源存档(sources/)
- arxiv-2207.12598.pdf (arXiv v1 完整版,含 Table 1/2 全部数字与附录样本图) (arXiv 原文 PDF,不入 git)
- cfg-neurips2021ws.pdf (NeurIPS 2021 Workshop 短版原文,方法部分与 arXiv 版一致) (PDF 不入 git,走 HF bucket)