一句话定位
ControlNet 是给”冻结的”大规模文生图扩散模型(实现于 Stable Diffusion)外挂空间条件控制的网络结构:把底模编码器克隆一份可训练副本,再用零初始化 1×1 卷积(zero convolution)把副本接回冻结底模,从而用边缘/深度/姿态/分割/涂鸦等条件精确控制构图,而不破坏底模、不灾难性遗忘。最亮眼的工程结果:深度条件 ControlNet 仅用 20 万样本 + 单张 RTX 3090Ti + 5 天,在用户研究中与”千 GPU-时、1200 万图”训练的工业级 SD2 Depth-to-Image 几乎无法区分(用户辨别精度 0.52±0.17,约等于瞎猜)。ICCV 2023 Marr Prize(最佳论文)。
背景与定位
要解决的问题:文本提示难以精确表达空间构图——姿态、轮廓、形状、布局靠文字很难说清,常需反复试错改 prompt。把额外的条件图(边缘图、深度图、姿态骨架、分割图等)直接喂给生成过程是自然解法,但端到端学习”条件→图像”映射很难:特定条件的配对数据通常只有 ~10 万量级,比训练 SD 用的 LAION-5B 小约 5 万倍。直接 finetune 或继续训练大模型,在小数据上会过拟合 + 灾难性遗忘。
技术脉络中的位置:
- 上承 SD 这一在隐空间做扩散的底模,以及 CFG 这一采样技术;
- 与参数高效微调(PEFT)一脉相承——LoRA 限制可训练参数的秩、HyperNetwork 用小网调大网权重、Adapter 插入新模块、Side-Tuning 用旁路分支;ControlNet 属”加性学习(additive learning)“,冻原模型 + 新增参数,但新增的不是小适配器而是整个编码器的可训练拷贝(强 backbone)。
- 与并发工作 T2I-Adapter(腾讯 ARC,更轻量的适配器)、Composer(达摩院,更大的可组合条件模型)、GLIGEN(在注意力层学新参数做 grounded 生成)形成同期”可控扩散”竞品集群;
- 相对前作改进:传统 image-to-image translation(pix2pix/CycleGAN/Palette/Taming Transformer/PITI/LDM-from-scratch)多是从头训练专用模型,质量/泛化受限于小数据;ControlNet 复用大底模的”亿级图像预训练编码器”作为强 backbone,因此小数据也能学出带语义识别能力的控制。
核心贡献:(1) 提出 ControlNet 这一可给预训练文生图扩散模型加空间局部条件的高效微调结构;(2) 放出对 SD 的多种预训练 ControlNet(Canny/Hough 线/涂鸦/人体关键点/分割/法线/深度/卡通线稿);(3) 用消融实验对比多种替代结构,并跨任务做用户研究验证。
模型架构
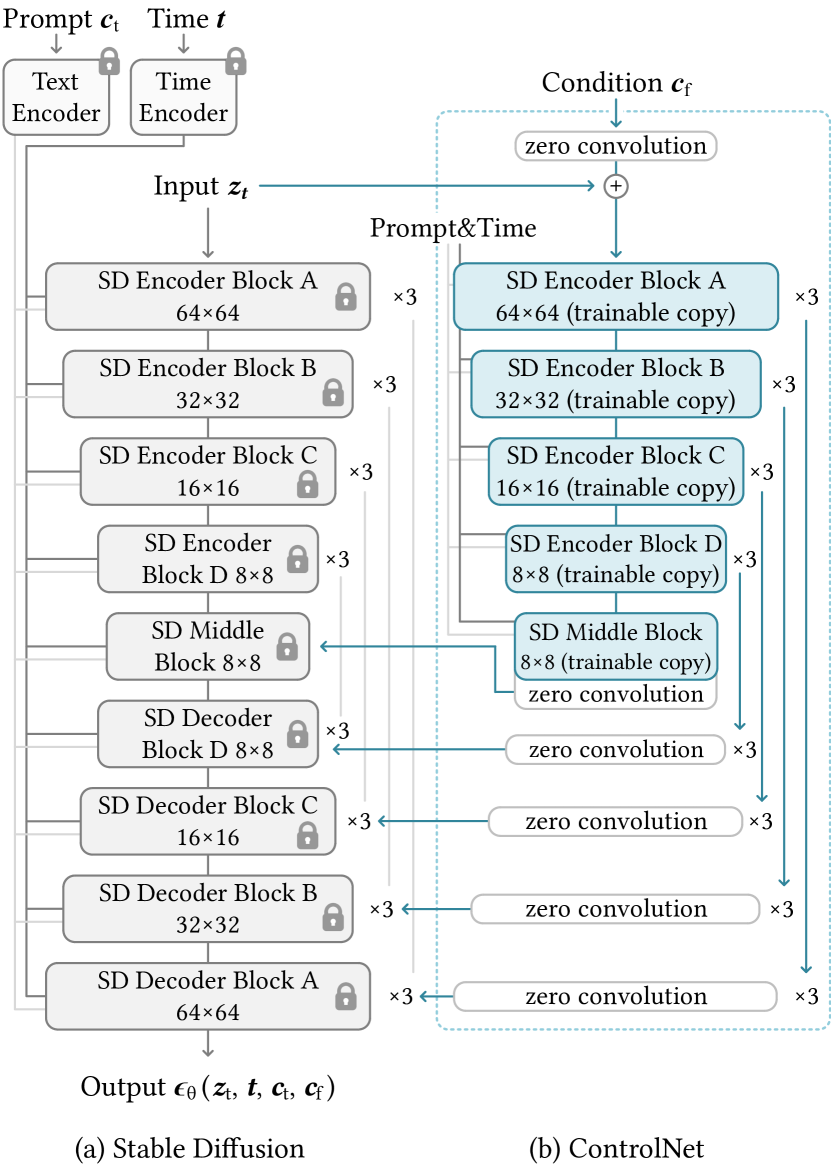
图源:ControlNet 论文 Figure 3(Stable Diffusion U-Net connected with a ControlNet),https://arxiv.org/abs/2302.05543
Backbone:U-Net(LDM/SD 1.5 与 2.1 共用同一 U-Net)。SD 的 U-Net 由编码器、中间块、带跳连的解码器组成,共 25 个块:其中 8 个是上/下采样卷积层,另外 17 个”主块”各含 4 个 ResNet 层 + 2 个 ViT(每个 ViT 含若干 cross-/self-attention)。编码器/解码器各 12 个块,4 个分辨率(64×64、32×32、16×16、8×8),每分辨率重复 3 次。文本经 CLIP text encoder 编码,时间步用位置编码的 time encoder。
ControlNet 基本单元(图 2):对一个”网络块” y = F(x; Θ),
- 锁定(freeze)原块参数 Θ;
- 克隆一份可训练副本,参数 Θc,副本额外接收条件向量 c;
- 副本的输入端和输出端各接一个零卷积
Z(·;·)(1×1 卷积,weight 和 bias 都初始化为 0)。
完整计算:y_c = F(x; Θ) + Z( F( x + Z(c; Θz1); Θc ); Θz2 )。训练第一步两个 Z 项都为 0,故 y_c = y——底模行为完全不变,有害噪声进不到副本的深层特征,从而保护”亿级图像预训练”的 backbone 不被随机梯度毁掉(详见”训练方法”里的零卷积梯度论证)。
接到 SD U-Net 上(图 3):只对编码器侧做手脚——为 SD 的 12 个编码块 + 1 个中间块各建可训练副本(README 称”重复这个简单结构 14 次”),副本输出经零卷积加到底模 U-Net 的 12 条跳连 + 1 个中间块上。解码器完全不动、不加副本。因为锁定部分不需要反传,原编码器无需存梯度——省显存、提速(实测见 Infra)。由于不改 SD 拓扑,训练好的 ControlNet 可直接迁移到社区微调底模(Comic Diffusion、Protogen 等)而无需重训。
条件注入:输入条件图(边缘/姿态/深度等,512×512)先经一个微型编码网络 E(·)(4 层 4×4 卷积、stride 2×2、ReLU、通道数 16→32→64→128,Gaussian 初始化,与全模型联合训练)压成 64×64 隐空间特征 c_f = E(c_i),对齐 SD 隐图尺寸后送入 ControlNet。注意 ControlNet 在 512×512 全分辨率拿条件再编码到 64×64,而 Stability 官方 SD2 Depth 模型只吃 64×64 深度图——ControlNet 保留更多条件细节(README 强调的差异点)。
参数量:未给精确数字,但量级=SD U-Net 编码器 + 中间块的一份拷贝(约半个 U-Net),远大于 LoRA/T2I-Adapter 这类轻量适配器——这是”深 encoder”刻意为之(见消融)。
数据
论文与补充材料逐条件给出了配对数据来源/规模/采集方式(补充材料 Table 1,A100 80GB 为主):
| 条件 | 训练样本 | 来源/构造 | Caption | 底模 |
|---|---|---|---|---|
| Canny 边缘 | 3M | 互联网图(用 LAION 工具但图源自建以避版权/去重),随机阈值 Canny | 网页自带 caption | SD 1.5 |
| Hough 直线 | 600K | Places2 + 深度 Hough 变换检测直线 | BLIP 生成 | 从 Canny 模型续训 |
| HED 软边缘 | 3M | 同 Canny 图源,HED 检测 | 网页 caption | SD 1.5 |
| 用户涂鸦 | 500K | 由 HED + 强数据增强(随机阈值/随机遮挡部分笔画/随机形态学变换/随机 NMS)合成涂鸦 | 网页 caption | 从 Canny 模型续训(基于 SD 1.5) |
| 人体姿态(Openpifpaf) | 80K(论文表写 200K) | 互联网图,规则”全身关键点检出≥30% 才算有人”,直接用可视化骨架图作条件 | 网页 caption | SD 2.1 |
| 人体姿态(Openpose) | 200K | 同上规则,Openpose 检测 | 网页 caption | SD 1.5 |
| 语义分割(COCO) | 164K | COCO-Stuff | BLIP | SD 1.5 |
| 语义分割(ADE20K) | 20K | ADE20K | BLIP | SD 1.5 |
| 深度 | 3M | 互联网图 + Midas 估深度 | BLIP/网页 | SD 1.5 |
| 法线图 | 25,452 | DIODE 数据集 RGB+法线 | BLIP(对 RGB 生成) | SD 1.5 |
| 卡通线稿 | 1M | 互联网卡通插画 + 线稿提取方法,按热度排序取 Top 1M | Danbooru Tags 拼接 | Waifu Diffusion |
配比/清洗要点:scale 实验对 Canny/Depth 数据按”分辨率最高”采样出 1K/10K/50K/200K/500K 子集(用图像分辨率排序当质量代理)。多用合成标注/伪标注(Midas 深度、HED 边、BLIP caption、Hough 线检测)——典型的”用现成检测器/估计器把无标注图变成配对数据”。未披露统一的美学/安全过滤管线;卡通线稿模型因”需评估潜在风险”未公开发布。
训练方法
训练目标:沿用扩散模型的标准去噪目标,仅把任务条件 c_f 加进网络输入:
L = E[ ‖ ε − ε_θ(z_t, t, c_t, c_f) ‖² ](z_t 为加噪隐图、t 时间步、c_t 文本、c_f 任务条件)。直接拿这个目标 finetune SD + ControlNet,无需新增辅助损失。属 ε-prediction 的 DDPM 范式(非 flow matching、非自回归)。
关键 trick:
- 50% 概率把文本 prompt 替换为空串——逼模型直接从条件图(边/姿态/深度)里识别语义来”替代”文字,这是后面”无 prompt 也能控(Guess Mode)“能力的来源。
- 零卷积保证”突变收敛(sudden convergence)“:因零卷积不往网络注噪,训练全程都能出高质量图;模型不是渐进学会跟随条件,而是在某一步(如 6133 步)突然学会跟随,通常 <1 万步。
- 零卷积为什么能学(FAQ/补充材料 §5 的梯度证明):对 1×1 卷积
y=Wx+b,初始 W=0、b=0 时,∂y/∂x=W=0(特征侧梯度被掐断,保护 backbone),但∂y/∂W=x≠0、∂y/∂b=1≠0——只要输入特征 x(即条件/数据)非零,第一步梯度下降就把 W 推离 0,随后∂y/∂x≠0,网络开始学;于是零卷积”从 0 逐步生长”成普通卷积。 - 不用 EMA 权重(所有实验)。
- 超参:batch size 多为 32(部分用梯度累积,如 ADE20K bs=256/4× 累积、姿态 bs=18=3×6×),学习率统一 1e-5。
多阶段/续训:基本是单阶段 finetune;但 Hough/涂鸦模型从 Canny checkpoint 续训(迁移已学到的边缘控制能力);法线模型有”扩展版”从基础法线 checkpoint 续训 200 GPU-时。未用 SFT→RLHF/DPO/reward model 这类偏好对齐,也未做步数蒸馏/一致性蒸馏(CM/LCM/ADD),属纯监督微调。
Infra(训练 / 推理工程)
训练算力(补充材料 Table 1):每个条件模型大致 100~600 GPU-时,主力 A100 80GB;姿态(Openpifpaf)/COCO 分割用单张 RTX 3090Ti(400 GPU-时)。
- 省显存机制:因冻结底模编码器无需反传/存梯度,加 ControlNet 后 GPU 显存只比裸 SD 多 ~23%、每次迭代耗时多 ~34%(单张 A100 PCIE 40GB 实测)。
- 低显存模式(low_vram):config 里
save_memory=True,8GB 卡也能跑,作者称能 batch size=12。 - 最小算力里程碑:深度 ControlNet 用 200K 样本 + 单张 RTX 3090Ti + 5 天即可(对标工业级 SD2-Depth 的”千 GPU-时 + 12M 图 + A100 集群”)。
- 可在个人设备/小规模训练,这是 zero-conv “无破坏微调”带来的工程红利。
推理工程:
- 采样器 DDIM,默认 20 步,默认 CFG scale=7.0。
- CFG 分辨率加权(CFG-RW):无 prompt 时条件若同时加到 CFG 的 uc 和 c 两侧会抵消引导、只加 c 侧又过强;解法是只把条件加到 c 侧,再按各块分辨率给 SD↔ControlNet 连接乘权重
w_i = 64/h_i(h 从 8 到 64),弱化引导强度,平衡可控性与质量。 - 多 ControlNet 组合:把多个 ControlNet 的输出直接相加到同一个 SD 上即可(如深度+姿态),无需额外加权或插值。
- 社区生态加速:作者提到”Precomputed ControlNet 可提速 45%“的讨论;A1111 WebUI 插件(Mikubill)支持 Guess Mode 与多控件组合。
- 部署形态:开源权重在 HF
lllyasviel/ControlNet,9 个 Gradio 演示 app,已被 diffusers 等主流框架集成。
评测 benchmark(把效果讲清楚)
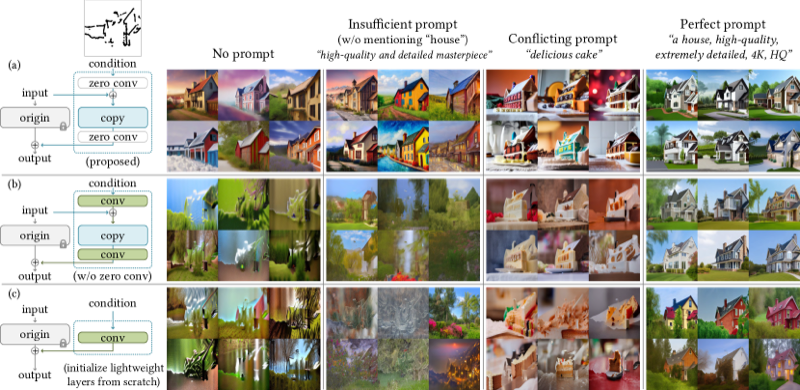
图源:ControlNet 论文 Figure 8(Ablative study of different architectures on a sketch condition;充分/冲突/不足 prompt 下 ControlNet vs Lite vs MLP),https://arxiv.org/abs/2302.05543
所有数字均来自论文/补充材料(一手源)。
1) 用户研究——涂鸦草图(AHR,1=最差 5=最好;12 名用户、20 张未见草图、5 方法)
| 方法 | 结果质量↑ | 条件保真度↑ |
|---|---|---|
| PITI (sketch) | 1.10±0.05 | 1.02±0.01 |
| Sketch-Guided (β=1.6) | 3.21±0.62 | 2.31±0.57 |
| Sketch-Guided (β=3.2) | 2.52±0.44 | 3.28±0.72 |
| ControlNet-lite | 3.93±0.59 | 4.09±0.46 |
| ControlNet | 4.22±0.43 | 4.28±0.45 |
2) 对标工业模型(SD2 Depth-to-Image):用户在 200 张图上辨别 ControlNet(200K 样本/单 3090Ti/5 天)与 SDv2-D2I(千 GPU-时/12M 图)谁生成的,平均辨别精度仅 0.52±0.17——基本等于随机猜,两者结果几乎无法区分。
3) 分割条件生成质量(ADE20K,FID / CLIP-score / CLIP-aesthetic)
| 方法 | FID↓ | CLIP-score↑ | CLIP-aes↑ |
|---|---|---|---|
| Stable Diffusion(无条件对照) | 6.09 | 0.26 | 6.32 |
| VQGAN(seg)* | 26.28 | 0.17 | 5.14 |
| LDM(seg)* | 25.35 | 0.18 | 5.15 |
| PITI(seg) | 19.74 | 0.20 | 5.77 |
| ControlNet-lite | 17.92 | 0.26 | 6.30 |
| ControlNet | 15.27 | 0.26 | 6.31 |
(*=从头训练。ControlNet 在 SD 系方法里 FID 最优。作者特别说明:FID 不应单独用于评价”控制效果”——完全不影响 SD 的”零控制”反而 FID 最好;故需配合”条件保真度”等指标。)
4) 分割重建保真度(用 OneFormer 重新分割生成图,算 IoU↑;GT 上限 0.58):VQGAN 0.21 / LDM 0.31 / PITI 0.26 / ControlNet-lite 0.32 / ControlNet 0.35。
关键消融结论(论文 §4.2 + 补充材料 + 官方博客 #188):
- 去掉零卷积(换成 Gaussian 初始化的普通卷积)→ 性能跌到与 ControlNet-lite 相当,说明可训练副本的预训练 backbone 在微调中被随机噪声梯度毁掉。
- ControlNet-lite(不要可训练副本,每层只用单卷积层)在”充分 prompt”下尚可,但在无 prompt/不足 prompt下失败——它不具备从条件图识别内容的能力。
- 官方博客 #188 的”非提示测试(NPT / Guess Mode)“是最关键的方法洞察:在精心写的强 prompt 下,ControlNet-Self / ControlNet-Lite / ControlNet-MLP 看起来都不错——因为强 prompt 本身就让裸 SD 生成了与条件”形状语义重叠”的图,控件只需微调形状。一旦去掉 prompt,差异立现:只有用深 SD 编码器的 ControlNet-Self 能”猜”出条件图里的内容(房子/物体)并生成有意义的图,Lite 和 MLP 都崩。结论:深 encoder 的价值在于”内容识别能力”,这对生产环境(用户 prompt 不可控、常不覆盖条件图全部内容)至关重要;同时也解释了为何必须给可训练副本也喂 prompt——让 prompt 在与条件语义冲突时仍占主导(如用”房子”涂鸦图配 prompt “delicious cakes” 能生成蛋糕)。
- 数据规模鲁棒性:1K 图就能学出可辨识的控制(不崩),50K、3M 逐步更好——训练对数据量从 <5 万到 >100 万都稳健。
创新点与影响
核心贡献:
- “冻结底模 + 可训练编码器副本 + 零卷积”三件套——把”小数据微调大生成模型而不灾难性遗忘”这个难题,用一个简洁、可证明(零卷积梯度论证)、可复现的结构解决;
- 零初始化卷积(zero convolution) 作为通用”无破坏接入”原语,保证训练初期底模行为不变、backbone 不被毁;
- 把大文生图模型的预训练编码器当作强 backbone 复用(而非另训小适配器),换来”无 prompt 也能识别条件语义”的控制能力。
影响:
- 成为扩散模型可控生成的事实标准,深度集成进 diffusers / A1111 WebUI / ComfyUI 生态;ControlNet 1.1 起放出更多/更稳的条件模型;
- 催生大量后续:T2I-Adapter(轻量替代)、IP-Adapter(图像 prompt)、ControlLoRA(用 LoRA 实现)、ControlNeXt、以及 SDXL/FLUX/视频扩散上的各种 ControlNet 变体;零卷积”渐进生长”思想被广泛借鉴;
- 工程意义:证明单张消费级 GPU + 十万级数据就能产出与工业级模型难分伯仲的可控生成器,极大降低了可控生成的门槛。
已知局限:
- 仍是在隐空间扩散,输出会轻微改动条件图的细节(卡通线稿 README 明确承认);
- 每种条件需单独训练一个 ControlNet(虽可组合,但非单一统一模型,对比 Composer 的”可组合条件”思路);
- FID 不能反映控制质量(作者自陈),评测需多指标并用;
- 未做偏好对齐/蒸馏加速,推理仍需 20 步 DDIM;
- 卡通线稿模型因风险评估未公开。
原始链接
- arxiv_abs: https://arxiv.org/abs/2302.05543
- arxiv_pdf: https://arxiv.org/pdf/2302.05543 (v3, 2023-11-26, ICCV 2023 camera-ready)
- supplementary: https://lllyasviel.github.io/misc/202309/cnet_supp.pdf
- github: https://github.com/lllyasviel/ControlNet
- github_readme/docs: docs/faq.md, docs/train.md, docs/low_vram.md
- official_blog (ablation #188): https://github.com/lllyasviel/ControlNet/discussions/188
- hf_weights: https://huggingface.co/lllyasviel/ControlNet
- controlnet_v1.1: https://github.com/lllyasviel/ControlNet-v1-1-nightly
一手源存档(sources/)
- arxiv-2302.05543.pdf (主论文 v3,PDF 不入 git)
- controlnet-supplementary.pdf (补充材料 33 页,PDF 不入 git)
- readme.md
- faq.md
- train.md
- low-vram.md
- ablation-blog.md (官方消融博客 #188 快照)