一句话定位
U-ViT 是一个纯 ViT(无卷积下/上采样)的扩散模型骨干:把时间 t、条件 c、加噪图像 patch 全部当作 token送进标准 Transformer,并在浅层与深层之间加 U-Net 式 long skip connection。它与 DiT 同期(2022-09)独立提出”用 Transformer 替换扩散 U-Net”,在 ImageNet 256×256 类条件生成上取得 FID 2.29、在 MS-COCO 文生图上取得 FID 5.48(均为”未使用大规模外部数据训练”一类方法中的当时 SOTA)。它是 UniDiffuser 的架构底座,也是 ViT-扩散骨干故事的中国侧起点。
背景与定位
扩散模型(DDPM、score-based)长期以 CNN-based U-Net(LDM / Guided-Diffusion/ADM)为骨干——其特征是一组下采样块、一组上采样块、以及两组之间的 long skip connection。与此同时 ViT 在判别式视觉任务上已可与 CNN 比肩。论文提出的核心问题就是:扩散模型对 CNN-based U-Net 的依赖是否必要?
U-ViT 的回答是:long skip connection 才是关键,CNN 的下/上采样算子并非必需。它沿用 ViT 的”图像即 token 序列”范式,但额外引入 U-Net 式长跳连——直觉是扩散的噪声预测目标是像素级、低层任务,对低层特征敏感,长跳连为低层特征提供捷径、显著加速并改善训练收敛。
与同期/相关工作的差异:
- vs DiT(同期、Meta/Berkeley):DiT 用 adaLN-zero 注入时间/类别条件、没有长跳连、走纯 in-context/adaLN 路线;U-ViT 反其道——把条件也当 token、核心是长跳连,并实测”time 作为 token 优于 adaLN”。两者得出”Transformer 可作扩散骨干”的相同结论但设计取向相反。
- vs GenViT:更小的 ViT(11M)、无长跳连、无 3×3 卷积、时间在归一化前注入——U-ViT 通过精心设计实现细节大幅超越它(Table 1 CIFAR10:GenViT 20.20 vs U-ViT-S/2 3.11)。
- vs VQ-Diffusion:后者先 VQ-GAN 离散化再用 Transformer 跑离散扩散、条件经 cross-attention/adaLN 注入;U-ViT 直接把一切当 token,论文称在 ImageNet 256 上 FID 更优于 VQ-Diffusion(U-ViT-H/2 2.29)。
会议归属:arXiv 2022-09 首发(v1),最终发表于 CVPR 2023。
模型架构
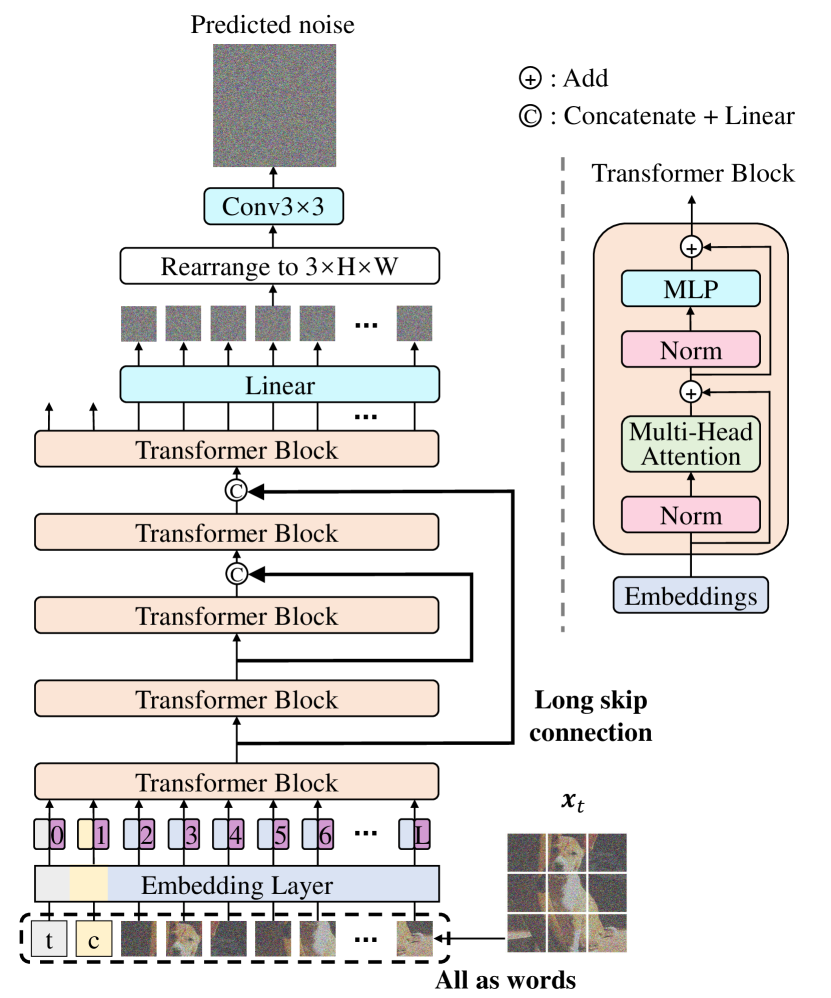
图源:All are Worth Words: A ViT Backbone for Diffusion Models (arXiv:2209.12152) Figure 1
Backbone:纯 Transformer encoder(ViT 风格),无任何卷积下/上采样。 参数化噪声预测网络 ε_θ(x_t, t, c)。
关键设计(均经系统消融确定):
- All-as-tokens(一切皆 token):加噪图像被切成 patch 经线性投影成 patch token;时间 t 经 embedding 成 1 个 token;条件 c(类别 embedding 或文本 CLIP 序列)也作 token。三类 token 拼成一条序列送入 Transformer。
- Long skip connection(核心):在 (#Blocks−1)/2 对浅层↔深层之间加长跳连。合并方式经消融选定为
Linear(Concat(h_main, h_skip))(拼接后线性投影),优于直接相加 / 仅投影 skip / 无跳连。CKA 分析证明 concat 方式显著改变了相邻 block 的表征相似度(addition 与无跳连则相邻 block 表征高度相似,等价于”白加”)。去掉长跳连模型严重退化,在 CIFAR10 和 ImageNet 256 上均验证其关键性。 - 时间注入方式:实测”time 作为 token”优于 AdaLN(adaptive layer norm,
y_s·LayerNorm(h)+y_b,类似 ADM 的 adaptive group norm)——这是与 DiT 的关键分歧点。 - 输出前可选 3×3 卷积块:在线性投影(token→patch)之后加一个 3×3 conv,抑制 Transformer 产物的潜在 artifact、提升视觉质量;“线性投影之后加 conv”略优于”之前加”或”不加”。
- Patch embedding:原始 ViT 线性投影优于”3×3 卷积栈+1×1 conv”变体。
- Position embedding:1D 可学习位置编码(原版 ViT)优于 2D 正弦;完全去掉位置编码则无法生成有意义图像——位置信息对图像生成是 critical 的。
条件注入:类条件用类别 token + classifier-free guidance;文生图用 CLIP 文本编码器(沿用 Stable Diffusion)把文本转成 embedding 序列、作为 token 注入。论文指出”文本与图像在 U-ViT 每一层都交互”,比 U-Net 仅在 cross-attention 层交互更频繁,从而语义对齐更好。
Visual tokenizer / 潜空间:高分辨率(256/512)走 LDM 路线——用 Stable Diffusion 提供的预训练图像 autoencoder(VAE) 把图像压到 32×32×4 / 64×64×4 潜表征,再用 U-ViT 建模潜表征。消融发现小 patch size(如 2)对噪声预测这种低层任务很关键,而高分辨率上小 patch 直接做太贵,故先压潜空间。
参数量配置(Table 2):
| 配置 | Layers | Hidden D | MLP | Heads | Params |
|---|---|---|---|---|---|
| U-ViT-Small | 13 | 512 | 2048 | 8 | 44M |
| U-ViT-Small(Deep) | 17 | 512 | 2048 | 8 | 58M |
| U-ViT-Mid | 17 | 768 | 3072 | 12 | 131M |
| U-ViT-Large | 21 | 1024 | 4096 | 16 | 287M |
| U-ViT-Huge | 29 | 1152 | 4608 | 16 | 501M |
记号 U-ViT-H/2 = Huge 配置 + 2×2 patch。缩放性质(CIFAR10):depth 9→13 提升、再到 17 在 50K iter 内无增益;width 256→512 提升、768 无增益;patch size 8→2 提升、1 无增益(说明需要足够小的 patch)。
数据
均为公开学术数据集,论文卖点之一就是”不使用大规模外部数据”:
- 无条件:CIFAR10(5 万训练图)、CelebA 64×64(162,770 张人脸)。
- 类条件:ImageNet 64×64 / 256×256 / 512×512(1,281,167 张训练图,1K 类)。
- 文生图:MS-COCO 256×256(82,783 训练图 + 40,504 验证图,每图 5 条 caption)。
无 re-captioning、无合成数据、无美学/安全过滤等环节——纯学术 benchmark 训练。高分辨率数据通过 SD 的 VAE 预先抽取潜特征(scripts/extract_imagenet_feature.py / extract_mscoco_feature.py),文本经 CLIP 文本编码器预抽 embedding。
训练方法
- 训练目标:标准 DDPM 噪声预测(ε-prediction),
min E_{t,x0,ε} ‖ε − ε_θ(x_t,t,c)‖²;论文指出 U-ViT 也可参数化 x_0-prediction。非 flow matching、非 rectified flow(这是 2022 年的扩散范式)。 - 噪声调度:连续时间 VP(variance preserving)或离散时间 SD(Stable Diffusion 用的离散调度)两套,按数据集 Table 5 给定。
- Classifier-free guidance:在 ImageNet 256/512 与 MS-COCO 上采用 CFG,无条件训练概率 p_uncond=0.1~0.15,guidance strength 按数据集调(0.1/0.4/0.7/1 等)。
- 无多阶段后训练:没有 SFT / RLHF / DPO / reward model / 偏好对齐——这是一篇骨干结构论文,只有单阶段扩散预训练。
- 无蒸馏/加速训练:未用 consistency/LCM/ADD 等步数蒸馏。加速主要靠采样器(推理侧)。
- 优化器与超参(Table 5 / 附录 A):AdamW,weight decay 0.03(在 0.01
0.05 间搜得),betas (0.99, 0.99)(CIFAR10 用 β2=0.999、MS-COCO 用 (0.9,0.9)),学习率 2e-4(ImageNet 64×64 用 3e-4)。Warm-up 2.5K5K 步。 - 训练规模/迭代:CIFAR10/CelebA batch 128 训 500K;ImageNet 64/256 训 300K、512 训 500K,batch 1024;MS-COCO batch 256 训 1M。
- 省显存 trick:混合精度训练 + gradient checkpointing(论文附录 A:U-ViT-L/2 ImageNet256 batch128 单 A100 前后向显存 53GB→10GB;README 称该 trick 通用约省 65% 显存)。配合 xformers 高效 attention,README 称仅 2 张 A100 即可在 batch 1024 下训练最大的 U-ViT-H(256/512 高分辨率)。
Infra(训练 / 推理工程)
训练设备与耗时(Table 6,一手数据):
| 数据集 | 模型 | 设备 | 时长 | 迭代 |
|---|---|---|---|---|
| CIFAR10 | U-ViT-S/2 | 4× RTX 2080 Ti | 24h | 500K |
| CelebA | U-ViT-S/4 | 4× RTX 2080 Ti | 24h | 500K |
| ImageNet 64 | U-ViT-M/4 | 8× A100 | 59h | 300K |
| ImageNet 64 | U-ViT-L/4 | 8× A100 | 100h | 300K |
| ImageNet 256 | U-ViT-L/2 | 8× A100 | 100h | 300K |
| ImageNet 256 | U-ViT-H/2 | 8× A100 | 208h | 500K |
| ImageNet 512 | U-ViT-L/4 | 8× A100 | 166h | 500K |
| ImageNet 512 | U-ViT-H/4 | 8× A100 | 208h | 500K |
| MS-COCO | U-ViT-S/2 | 4× A100 | 60h | 1M |
| MS-COCO | U-ViT-S/2(Deep) | 4× A100 | 74h | 1M |
工程栈:HuggingFace accelerate(DDP + 混合精度)、facebook xformers(高效 attention,训练/推理双加速)、gradient checkpointing。README 实测 U-ViT-H/2 ImageNet256 batch128 单 A100:开混合精度 0.97 steps/s(78.9GB)→ 加 xformers 1.14 steps/s(54.3GB)→ 再加 checkpointing 0.87 steps/s(18.9GB)。
推理:采样器用 DPM-Solver(ODE,高分辨率 50 步)或 Euler-Maruyama SDE(像素空间 1K 步)。1× A100 用 DPM-Solver 生成 500 张样本:U-ViT-S ≈19s、M ≈34s、L ≈59s、H ≈89s(开 CFG 时间翻倍)。未用量化/蒸馏部署优化。
计算量(GFLOPs,Table 7):U-ViT-H/2 ImageNet256 主干 133 GFLOPs(+312 AE),U-ViT-L/2 主干 77 GFLOPs;与 ADM/LDM 主干(ADM256 110 GFLOPs、LDM 104)同级,远小于 ADM-G,ADM-U 的超分支路(632/2506 GFLOPs)。附录 E 在”同参数同算力”下对比:U-Net(ADM 实现,646M/135 GFLOPs)vs U-ViT(501M/133 GFLOPs),ImageNet256 500K iter 下 U-ViT 更优——无 CFG 时 FID 6.58 vs U-Net 10.69,CFG=0.4 时 2.29 vs 2.66。
评测 benchmark(把效果讲清楚)
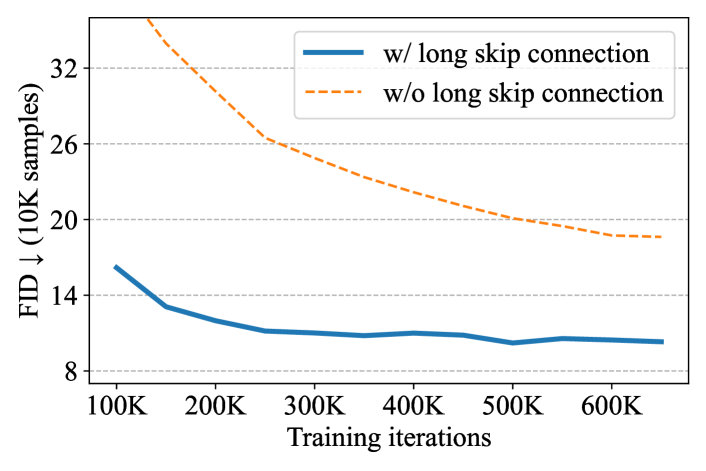
图源:All are Worth Words: A ViT Backbone for Diffusion Models (arXiv:2209.12152) Figure 5(ImageNet 256 上长跳连消融:有/无 long skip 的 FID-训练步数曲线)
所有数字均来自论文 Table 1/3/4/7(一手源)。
类条件 / 无条件(Table 1,FID↓,50K 样本):
- CIFAR10:U-ViT-S/2 3.11(GenViT 11M 为 20.20,碾压;与 DDPM 3.17 量级相当,但仍逊于用进阶训练技巧的 U-Net SOTA EDM† 1.97)。
- CelebA 64×64:U-ViT-S/4 2.87。
- ImageNet 64×64:U-ViT-M/4 5.85(优于 IDDPM-100M 的 6.92)、U-ViT-L/4 4.26。
- ImageNet 256×256:U-ViT-H/2(潜空间+CFG)FID 2.29,超越所有同期扩散模型(Table 1:ADM-G,ADM-U 3.94;LDM 3.60;正文 §5.2 称亦优于离散扩散 VQ-Diffusion,但 Table 1 未给出其 ImageNet256 具体 FID 数字)。
- ImageNet 512×512:U-ViT-L/4 4.67、U-ViT-H/4 4.05(FID 略逊于同档 ADM-G,ADM-U 的 3.85;论文强调 U-ViT 在潜空间建模、ADM-G,ADM-U 直接建模像素且带 309M 超分模块 + 43M 分类器,辅助参数/算力代价更高。Table 7 中 U-ViT-H/4 ft-EMA 的 IS 更高 263.79 vs 221.72,Precision 持平 0.84,Recall 略低 0.48 vs 0.53——并非全面更优)。
不同采样步数对比(Table 3,ImageNet256,DPM-Solver,FID↓;列为 4/5/10/15/20 步):
- LDM(178K):34.48 / 12.73 / 4.51 / 3.87 / 3.68
- U-ViT-H/2(200K):16.48 / 4.94 / 3.87 / 3.54 / 2.91
- U-ViT-H/2(500K):15.44 / 4.64 / 3.18 / 2.92 / 2.53 即在 4~20 各档步数下 U-ViT 用同一采样器全面优于 LDM(如 4 步 15.44 vs 34.48、20 步 2.53 vs 3.68)。
其他指标(Table 7,ImageNet256,U-ViT-H/2 ft-EMA 500K):FID 2.29、sFID 5.68、IS 263.88、Precision 0.82、Recall 0.57;ImageNet512 H/4:FID 4.05、sFID 6.44、IS 263.79。
文生图 MS-COCO(Table 4,30K 验证 prompt,FID↓):
- 仅用 MS-COCO 训练一档:U-ViT-S/2 5.95、U-ViT-S/2(Deep) 5.48(当时该档 SOTA),均优于作者自训的同尺寸 U-Net 基线 7.32(U-ViT-S 45M vs U-Net 53M,参数更少效果更好)。
- 对比(用大规模外部数据 zero-shot 的)DALL-E 2 10.39 / Imagen 7.27 / Parti 7.23——U-ViT 用 8.3 万张 COCO 即达 5.48,凸显”无外部数据”高效性(注:非同等设置,外部大数据方法泛化能力不同)。
- 定性:同随机种子下 U-ViT 比 U-Net 语义对齐更好(“棒球运动员挥棒击球”:U-Net 既无球棒也无球,U-ViT-S 生成了球,U-ViT-S-Deep 连球棒也生成)。
关键消融结论:long skip connection(concat 方式)是性能与收敛的命门;time-as-token > AdaLN;输出前 3×3 conv 微增益;1D 可学习位置编码最佳、无位置编码则崩溃;小 patch(=2)必需。
创新点与影响
核心贡献:
- 提出 U-ViT——一个简单通用的纯 ViT 扩散骨干,证明”扩散建模可去掉 CNN U-Net 的下/上采样,但必须保留 long skip connection”。
- 系统消融厘清了 ViT-扩散骨干的关键实现细节(跳连合并方式、时间注入、位置编码、patch size、输出卷积),为后续工作提供了配方。
- 在 ImageNet256(FID 2.29)与 MS-COCO(FID 5.48)刷新”无外部数据”档 SOTA。
对后续的影响:
- 与 DiT 一道,成为 “Transformer 取代扩散 U-Net” 范式的双源头之一;DiT 的 adaLN 路线后来被 SD3/PixArt 等主流采纳,而 U-ViT 的”条件即 token + 长跳连”则在 UniDiffuser(基于 1B U-ViT 的多模态联合扩散)中发扬,是 ViT-扩散骨干的中国侧根。
- 直接催生 UniDiffuser、DPT(1 标签/类的条件扩散)等下游工作,作者团队(Fan Bao / Jun Zhu / Chongxuan Li,TSAIL)后续延续到 UniDiffuser 等。
- “长跳连对扩散 Transformer 关键”这一论断对理解后续 DiT 变体(部分重新引入 skip,如 U-DiT/Hunyuan-DiT 的混合设计)有参考价值。
已知局限:
- 仅在学术 benchmark(CIFAR/CelebA/ImageNet/COCO)验证,未在大规模网络数据/工业级文生图上验证;最大仅 501M,缩放性论文只在 CIFAR 小规模观察(depth/width 很快饱和)。
- 无后训练/对齐/蒸馏,纯结构工作;推理仍需 50 步 DPM-Solver(未做步数蒸馏)。
- time-as-token vs adaLN 的优劣结论是在其自身设置下得出,与 DiT 的相反结论并存——说明最佳条件注入方式与整体设计耦合,并非普适定论。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2209.12152
- paper (PDF): https://arxiv.org/pdf/2209.12152
- code (GitHub, 官方 PyTorch 实现 + 预训练权重): https://github.com/baofff/U-ViT
- 下游项目 UniDiffuser: https://github.com/thu-ml/unidiffuser
- 会议: CVPR 2023
一手源存档(sources/)
- arxiv-2209.12152.pdf (arXiv 原文 PDF,不入 git)
- readme.md