一句话定位
DPM-Solver 是为扩散 ODE 量身定制的高阶、免训练专用数值求解器:它发现扩散 ODE 的”半线性”结构,把线性部分解析求解、把非线性部分化成一个”指数加权积分”,再用指数积分器(exponential integrator)的高阶 Taylor 展开逼近,从而把高质量采样从 DDIM 的上百步压到约 10–20 步。在 CIFAR-10 上 10 NFE 即 4.70 FID、20 NFE 即 2.87 FID(连续模型,相比此前最佳 ODE/SDE 求解器约 5× 加速);离散模型 12 步即可出合理样本,比此前最快免训练采样器快 4–16×(NeurIPS 2022,“Oral” 接收信息不在已落盘一手源中,源仅为 arXiv v2)。其改进版 DPM-Solver++ 成为 Stable Diffusion / diffusers 的默认快速采样器。
背景与定位
扩散模型(ddpm、score-sde)质量高但采样慢——原版 DDPM/SDE 求解需要数百到上千次网络前向(NFE)。加速采样分两类:
- 训练型:知识蒸馏(progressive distillation)、学噪声水平/采样轨迹(GGDM)。需额外训练,且会丢信息(蒸馏后模型无法在任意时刻预测 score),迁移到新模型/数据/步数成本高。
- 免训练:对预训练模型即插即用。ddim(隐式确定性采样)、Analytic-DPM(解析最优方差)、PNDM(伪数值法)、以及把扩散 ODE 交给通用黑盒求解器(score-sde 用 RK45,约 60 NFE 才达到 1000 步 SDE 的质量)。但这些方法仍需约 50 NFE 才能出高质量样本。
本文把”从 DPM 采样”等价为”解扩散概率流 ODE”(probability flow ODE,score-sde 提出),并指出此前黑盒求解器忽略了扩散 ODE 的半线性结构——dx/dt = f(t)x + g²(t)/(2σ_t)·ε_θ(x,t),前一项是 x 的线性函数、后一项是神经网络给的非线性函数。把整体丢给黑盒 RK 求解器,会同时引入线性项和非线性项的离散化误差,而线性项的精确解带指数系数、误差可能指数级放大(这也是 RK 在大步长下数值不稳定的原因)。DPM-Solver 把这块结构利用起来,从而进入”约 10 步”的少步采样新区间。
模型架构
DPM-Solver 不是模型,而是一个求解器/采样算法,对任意预训练的噪声预测网络 ε_θ(U-Net 等)即插即用,不引入任何新参数、不需要任何额外训练。它对 backbone 不可知:本文实验用的是 ddpm/score-sde 系列的 VP 型(variance-preserving,α_t²+σ_t²=1)U-Net 模型;只要给出噪声预测网络与噪声调度(noise schedule,α_t、σ_t),DPM-Solver 即可工作。
核心方法(把方法讲清楚):
- 半线性精确解(Proposition 3.1):用”常数变易法”(variation of constants)把扩散 ODE 的解写成「线性部分解析 + 非线性部分积分」。再引入半-log-SNR 变量
λ_t := log(α_t/σ_t)(严格单调递减、可逆,记其反函数 t_λ(·)),做换元后,解被化简为x_t = (α_t/α_s)·x_s − α_t·∫_{λ_s}^{λ_t} e^{−λ} ε̂_θ(x̂_λ, λ) dλ。 这个∫ e^{−λ} ε̂_θ dλ称为 ε̂_θ 的指数加权积分(exponentially weighted integral)——是本文核心洞见,此前扩散文献未揭示。它把噪声调度 f(t)、g(t) 全部吸收成解析的e^{−λ},使解与具体噪声调度无关(noise-schedule invariant,附录 A 证明 VP/VE/subVP 都可归约到此式)。 - 高阶求解器(DPM-Solver-k):对积分内的 ε̂_θ 在 λ_{t_{i-1}} 处做 (k-1) 阶 Taylor 展开,逐项的
∫ e^{−λ}(λ-λ_{i-1})ⁿ/n! dλ可用分部积分解析算出(附录 B.2)。丢掉 O(h^{k+1}) 项、用”stiff order conditions”逼近前 (k-1) 阶导数,得到 1/2/3 阶求解器:- DPM-Solver-1:
x̃_{t_i} = (α_{t_i}/α_{t_{i-1}})·x̃_{t_{i-1}} − σ_{t_i}(e^{h_i}-1)·ε_θ(x̃_{t_{i-1}}, t_{i-1}),h_i = λ_{t_i}-λ_{t_{i-1}}。本文证明它与 ddim 完全等价(DDIM 是 DPM-Solver-1,从而解释了 DDIM 为何优于朴素 Euler——它隐式利用了半线性结构)。 - DPM-Solver-2 / -3:需在区间内加 1/2 个中间评估点(Algorithm 1/2),每步分别需 2/3 次网络评估(NFE)。
- 收敛阶定理(Thm 3.2):DPM-Solver-k 是 k 阶求解器,终点误差
x̃_{t_M}-x_0 = O(h_max^k)。k≥4 需更多中间点,本文只用 k=1,2,3。
- DPM-Solver-1:
- 步长调度:① 手工——在 [λ_T, λ_0] 上均匀分 λ(注意区别于 ddpm/score-sde 在 t 上均匀分步);② 自适应——结合不同阶组合成 DPM-Solver-12/23,按局部误差动态调步(atol=0.0078, rtol=0.05, h_init=0.05, θ=0.9,附录 C)。NFE≤20 用均匀步长的固定阶组合(“DPM-Solver-fast”:尽量用 3 阶、余数补 1/2 阶步),NFE>20 用自适应。
- 离散时间 DPM 适配(Sec 3.4 / 附录 D.2):把离散训练的 ε̃_θ(x_n, n)(n=0..N-1)重参数化为连续时间 ε_θ(x,t)=ε̃_θ(x, 1000·(N-1)t/(NT))(附录 D.2 Type-2;另有 Type-1 变体),把连续时间 [0,T] 线性映回离散标签 [0, 1000(N-1)/N];借平滑时间嵌入(位置编码)容许非整数时间输入,即可对 ddpm 等离散模型用 DPM-Solver。
- 条件采样(附录 D):直接支持 classifier guidance(ADM-G),把条件噪声预测 ε_θ - s·σ_t·∇log q_φ(c|x) 代入 ODE 即可,classifier scale 默认 1.0。
数据
不适用——这是免训练采样器,不涉及任何训练数据。评测用的预训练 checkpoint 与对应数据集:
- CIFAR-10 32×32(连续 “VP deep” 模型 score-sde,线性调度;离散 L_simple 模型 ddpm,线性调度)
- CelebA 64×64(离散模型 ddim,线性调度)
- ImageNet 64×64(离散 L_hybrid 模型 improved-ddpm,cosine 调度;仅用 mean 模型,忽略 variance 模型)
- ImageNet 128×128(带 classifier guidance 的离散模型 diffusion-models-beat-gans,线性调度)
- ImageNet 256×256(ADM-G + classifier guidance,scale 1.0,用于 Fig.1 定性对比)
- LSUN bedroom 256×256(diffusion-models-beat-gans 无条件模型,线性调度)
训练方法
无训练。这正是本文相对蒸馏类方法(progressive distillation、GGDM)的核心卖点:DPM-Solver 不需任何额外训练/优化阶段,保留原模型全部信息(可在 [0,T] 任意时刻预测 score),因此可无缝扩展到 classifier guidance 等条件采样。它把”加速采样”从”再训练问题”还原为”更聪明地解 ODE”的纯数值问题。
Infra(训练 / 推理工程)
- 硬件:评测在 NVIDIA A40 GPU 上跑(论文指出可换其他 GPU 如 RTX 2080Ti,只需调采样 batch size)。无训练即无训练算力开销。
- 推理开销:DPM-Solver 每步的额外计算(解析系数)相对网络前向可忽略——论文 Table 7 实测,同 NFE 下 DPM-Solver 与 ddim 的单 batch 墙钟时间几乎相同(DPM-Solver 甚至略快,因实现细节),且运行时间随 NFE 近似线性。例如单 A40、batch=128:
- CIFAR-10 32×32:10/20/50/100 NFE → 0.923/1.833/4.580/9.204 s/batch(DPM-Solver)
- ImageNet 128×128(含 classifier guidance):10 NFE → 28.865 s/batch
- LSUN bedroom 256×256(batch=64):10 NFE → 36.996 s/batch 结论:NFE 的加速倍数≈真实墙钟加速倍数,所以 4–16× 的 NFE 节省直接转化为采样提速。
- 部署形态:纯算法、即插即用,无需重训。README 报告 Stable Diffusion 官方 demo 接入后从 50 步降到 25 步、采样快一倍;用 JAX 在 TPUv2-8 上 4 秒生成 8 张图。
评测 benchmark(把效果讲清楚)
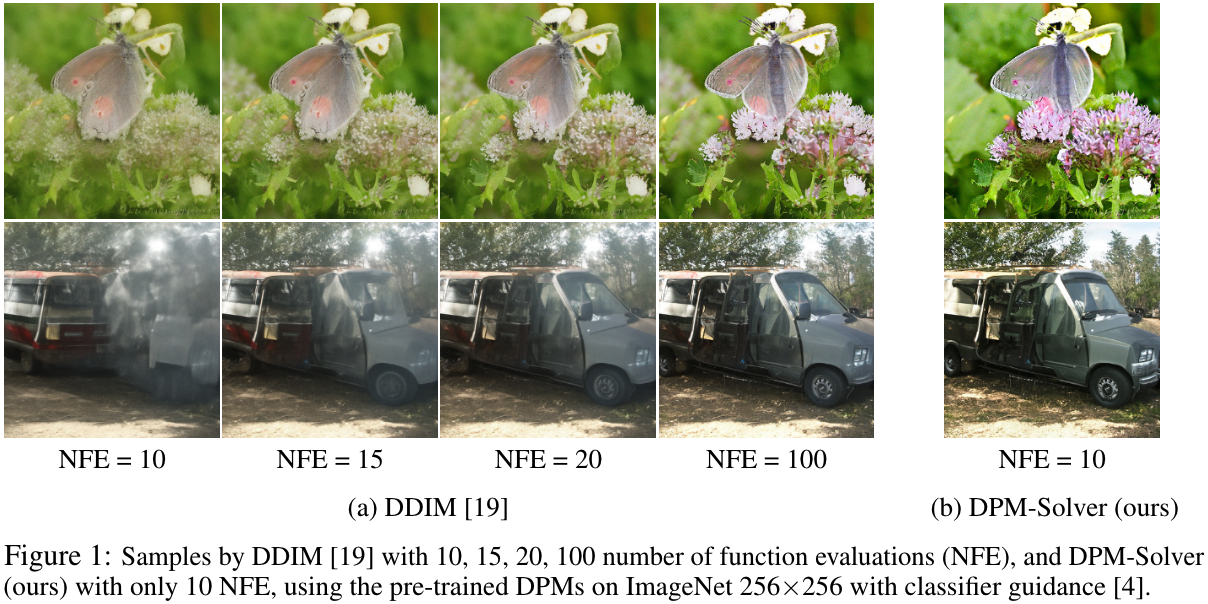
图源:DPM-Solver 论文 Figure 1 / GitHub README teaser(github.com/LuChengTHU/dpm-solver,ImageNet 256×256 + classifier guidance;DPM-Solver 仅 10 NFE 即达 DDIM 100 NFE 画质)
评测指标统一用 FID↓(各设置抽 50K 样本计算)。NFE = 噪声预测网络的调用次数。
与连续时间方法对比(CIFAR-10,“VP deep” 连续模型,线性调度):
- DPM-Solver:10 NFE → 4.70 FID;12 NFE → 3.75;15 NFE → 3.24;20 NFE → 2.87(CIFAR-10 上最快采样器)。
- 对照:扩散 SDE 的 Euler 离散、SDE 自适应步长求解器、RK45 ODE 求解器在 50 NFE 时仍有较大离散化误差——DPM-Solver 约 5× 加速于此前最佳求解器。
与传统 Runge-Kutta(RK)同阶消融(CIFAR-10,Table 1,FID↓): DPM-Solver 在同 NFE 下持续优于 RK,少步区(<15 NFE)差距最显著。
| NFE | RK2(t) | RK2(λ) | DPM-Solver-2 | RK3(t) | RK3(λ) | DPM-Solver-3 |
|---|---|---|---|---|---|---|
| 12 | 16.40 | 107.81 | 5.28 | 48.75 | 34.29 | 6.03 |
| 18 | 7.25 | 42.04 | 3.43 | 21.86 | 4.90 | 2.90 |
| 24 | 3.90 | 17.71 | 3.02 | 10.90 | 3.50 | 2.75 |
| 48 | 3.54 | 3.17 | 2.69 | 4.12 | 2.69 | 2.65 |
原因:DPM-Solver 解析算线性项、消除其离散化误差;RK 把线性项也数值化、大步长下指数放大误差。且 DPM-Solver-3 收敛快于 -2,印证收敛阶定理。
与离散时间免训练采样器对比(Fig.2,DPM-Solver vs DDPM/DDIM/Analytic-DDPM/Analytic-DDIM/PNDM/FastDPM/Itô-Taylor/GGDM): DPM-Solver 仅 12 步即可得到合理样本——
- CIFAR-10:FID 4.65 @ 12 NFE
- CelebA 64×64:FID 3.71 @ 12 NFE
- ImageNet 64×64:FID 19.97 @ 12 NFE
- ImageNet 128×128(classifier guidance):FID 4.08 @ 12 NFE
比此前最快免训练采样器快 4–16×,甚至优于需额外训练的 GGDM。
条件采样(ImageNet 256×256,classifier guidance scale 1.0,Fig.1/3): DPM-Solver-fast 15 NFE 即可生成与 ddim 100 NFE 相当的样本。
创新点与影响
核心贡献:
- 揭示扩散 ODE 的半线性结构,给出解析精确解(Proposition 3.1),把非线性部分化为”指数加权积分”——这一形式此前扩散文献未出现,且与噪声调度无关(noise-schedule invariant,与最大似然训练的不变性对偶)。
- 基于指数积分器构造 1/2/3 阶专用求解器 DPM-Solver-k,带收敛阶保证(Thm 3.2),把高质量采样压到约 10–20 步。
- 理论上统一并解释了 ddim(证明 DDIM ≡ DPM-Solver-1),说明 DDIM 优于朴素 Euler 的根源在于它隐式利用半线性结构。
- 免训练、即插即用,兼容连续/离散时间 DPM 与 classifier guidance。
影响: DPM-Solver 及其同作者改进版 DPM-Solver++(arXiv 2211.01095,本仓库已落盘)成为扩散快速采样的事实标准——
- DPM-Solver++ 针对大引导尺度(large guidance scale)下高阶求解器不稳定(甚至慢于 DDIM)的问题,改用数据预测(data-prediction)参数化 + 动态阈值(dynamic thresholding,借自 Imagen) + 多步法(multistep,Adams-Bashforth 型,等效步长更小更稳),把有引导采样也压进 15–20 步(像素空间与 latent 空间 DPM 均可)。
- 被广泛集成:HuggingFace diffusers(
DPMSolverMultistepScheduler,二阶 multistep DPM-Solver++ 是当前最快求解器、Stable Diffusion 在线 demo 默认)、Stable Diffusion v1/v2 官方代码、AUTOMATIC1111 WebUI、k-diffusion、DreamStudio、Apple Core ML Stable Diffusion(Swift 移植,限二阶)等。Stable Diffusion 官方 demo 接入后步数 50→25、速度翻倍。
已知局限(作者自述): ① 只为快速采样设计,不适合加速 DPM 的似然估计;② 即便如此,扩散+DPM-Solver 仍不及单步 GAN 那样可实时;③ 一般性生成模型的滥用风险(伪造内容),快速采样器可能放大这一负面影响。补充:DPM-Solver(原版)在大引导尺度下会失稳,这正是后续 DPM-Solver++ 要解决的问题。
原始链接
- arxiv_abs: https://arxiv.org/abs/2206.00927
- arxiv_pdf: https://arxiv.org/pdf/2206.00927
- github: https://github.com/LuChengTHU/dpm-solver
- 改进版(DPM-Solver++,部署版): https://arxiv.org/abs/2211.01095
- HF demo: https://huggingface.co/spaces/LuChengTHU/dpmsolver_sdm
一手源存档(sources/)
- arxiv-2206.00927.pdf (arXiv 原文 PDF,不入 git)
- readme.md
- arxiv-2211.01095.pdf (arXiv 原文 PDF,不入 git)