一句话定位
DDIM 把 ddpm 的马尔可夫扩散推广为一族非马尔可夫前向过程,得到一个确定性(σ=0)采样器:训练目标与 DDPM 完全相同、无需重训,却能把采样步数从 1000 步压到 20–100 步而质量几乎不掉——CelebA 上 20 步 DDIM 的 FID(13.73)与 100 步 DDPM 相当,实现 10×–50× 墙钟加速;同时赋予可逆/可编辑的潜变量轨迹,是后来 DDIM inversion 图像编辑的基础。
背景与定位
ddpm(Ho et al. 2020)虽达到媲美 GAN 的样本质量,却有一个致命缺陷:生成过程是去噪马尔可夫链的逆过程,必须逐步串行走完 T(通常 1000)步,采样极慢——论文给的数字:单张 Nvidia 2080 Ti 上从 DDPM 采 5 万张 32×32 图要约 20 小时,256×256 则近 1000 小时;而 GAN 一次前向不到一分钟。
DDIM 的核心洞察是:DDPM 的去噪目标 L_γ 只依赖边缘分布 q(x_t|x_0),不依赖联合分布 q(x_{1:T}|x_0)。 既然有无穷多个联合分布共享同一组边缘,就能换一族非马尔可夫的前向过程,使其导出同一个替代目标(surrogate objective)。于是可以直接拿训练好的 DDPM 权重,仅改变采样过程,就构造出更快、且确定性的生成器。它把扩散模型从”必须模拟随机微分方程的 Langevin 动力学”解放出来,纯粹从变分视角推导,并揭示其确定性采样等价于一个概率流 ODE 的 Euler 解——这条 ODE 线索直接通向后续的 score-sde probability-flow ODE 与 dpm-solver、consistency-models 等更快求解器。DDIM 因此成为几乎所有扩散模型(含 latent-diffusion-ldm)的默认快速采样器。
模型架构
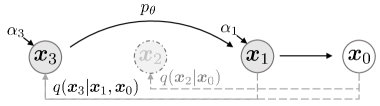
图源:Song et al. 2021, “Denoising Diffusion Implicit Models” (arXiv:2010.02502) Figure 2 — 加速生成的图模型(跳过中间步 x2,按子序列 τ 采样)
DDIM 不改架构、不改训练——它是一个采样方法/推理算法,复用 DDPM 的网络。
-
去噪网络 ε_θ:沿用 Ho et al. 2020 的 U-Net(基于 Wide ResNet),预测噪声 ε。论文对 CIFAR10 / LSUN Bedroom / LSUN Church 直接用 DDPM 原仓库的预训练 checkpoint;仅 CelebA 64×64 因官方无预训练而自训(5 个分辨率层级 64×64→4×4,用 StyleGAN 仓库的预处理脚本处理原始 CelebA,非 CelebA-HQ)。
-
预测—校正分解(DDIM 采样核心,Eq. 12):给定 x_t,先用网络估计 x_0(“predicted x_0”),再朝 x_t 方向加一项确定的”指向 x_t 的方向”,最后按 σ_t 注入随机噪声:
x_{t-1} = √(α_{t-1}) · ( (x_t − √(1−α_t)·ε_θ(x_t)) / √(α_t) )   ← predicted x_0
        + √(1 − α_{t-1} − σ_t²) · ε_θ(x_t)                       ← direction pointing to x_t
        + σ_t · ε_t                                              ← random noise
其中 α_t 是 DDPM 的累积保留系数(注意 DDIM 论文记号下 α_t 等于 DDPM 的 ᾱ_t = 累乘)。
-
σ 这个旋钮统一了一族过程:以 η∈[0,∞) 参数化 σ_{τ_i}(η)=η·√((1−α_{τ_{i-1}})/(1−α_{τ_i}))·√(1−α_{τ_i}/α_{τ_{i-1}})。
- η=1.0 → 退化回 DDPM(马尔可夫、随机)。
- η=0.0 → DDIM:随机项系数归零,前向过程对 (x_{t-1},x_0) 确定(t=1 除外),生成过程变成确定性隐式概率模型——给定初始 x_T,输出 x_0 唯一确定(类似 GAN/可逆流,故能做语义插值与编码重构)。
- 论文还测了一个方差更大的 σ̂_{τ_i}=√(1−α_{τ_i}/α_{τ_{i-1}})(即 Ho et al. 在 CIFAR10 上用的较大方差版 DDPM)。
-
加速采样(4.2 节):前向过程不必定义在全部 x_{1:T} 上,可只取一个递增子序列 τ=(τ_1,…,τ_S)(S≪T),让 q(x_{τ_i}|x_0) 仍匹配原边缘。生成按 reversed(τ) 走,只需把 Eq. 12 里的下标从 (t,t-1) 换成 (τ_i,τ_{i-1})(闭式见 Appendix D.3),训练完全不动。子序列选法:Linear τ_i=⌊ci⌋ 或 Quadratic τ_i=⌊ci²⌋(CIFAR10 用 quadratic,其余数据集用 linear,c 选到 τ_{-1} 接近 T)。
-
与 Neural ODE 的等价(4.3 节,关键理论):把 DDIM 迭代重参数化(σ=√(1−α)/√α、x̄=x/√α),它正是下述 ODE 的 Euler 离散:dx̄(t)=ε_θ(x̄(t)/√(σ²+1))·dσ(t)。Proposition 1 证明:在最优 ε_θ 下,该 ODE 等价于 score-sde 中”Variance-Exploding” SDE 的概率流 ODE(即与 Song et al. 2020 的并行工作相通,但二者 Euler 步进的自变量不同——DDIM 对 dσ 步进、score-SDE 对 dt 步进,在少步数下结果有差异)。因为是 ODE,DDIM 可反向积分:把 x_0 编码到 x_T(DDIM inversion 的雏形),再解码重构,这是 DDPM 因随机性做不到的。
无 text encoder / VAE / VQ(这是无条件像素空间扩散方法,不涉及文图对齐组件)。
数据
DDIM 本身不训练新模型(除 CelebA),数据即沿用 DDPM 设置,用于评测的 4 个图像数据集:
- CIFAR10 32×32(无条件)——用 DDPM 预训练 checkpoint。
- CelebA 64×64——作者自训(用 L_1 去噪目标),原始 CelebA(非 CelebA-HQ),StyleGAN 仓库预处理。
- LSUN Bedroom 256×256——用 DDPM 预训练 checkpoint。
- LSUN Church 256×256——用 DDPM 预训练 checkpoint。
α 调度(noise schedule)全部按 Ho et al. 2020 的启发式设定,以便与 DDPM 直接可比。无图文对、无 re-captioning、无美学/安全过滤——与本工作无关。
训练方法
训练与 DDPM 字面完全相同,DDIM 不引入任何新训练步骤。 这是全文最核心的结论之一。
- 训练目标:去噪/噪声预测目标 L_1(即 Eq. 5 中 γ=1 的版本):E[‖ε_θ(√(α_t)x_0+√(1−α_t)ε)−ε‖²],等价于 DDPM 的简化目标、也等价于多噪声层级的 score matching(score-sde 的 NCSN)。
- 统一变分目标(Theorem 1,理论支柱):对每个非马尔可夫 σ,论文定义变分目标 J_σ(Eq. 11)。定理 1 证明:对任意 σ>0,存在权重 γ 与常数 C 使 J_σ = L_γ + C。 又因为当各步参数不共享时 L_γ 的最优解与权重 γ 无关、等于 L_1 的最优解,所以同一个用 L_1 训出的 DDPM 网络,对一整族 σ(含 DDIM 的 σ=0)都是最优解——这就是”无需重训即可切换采样器”的严格依据。
- 无多阶段、无 SFT/RLHF/DPO、无 reward model:2020 年的无条件图像扩散,谈不上偏好对齐。
- 加速 = 改采样而非蒸馏:DDIM 的提速来自减少采样步数(子序列 τ)+ 确定性轨迹,不是步数蒸馏/一致性蒸馏(那是后来 consistency-models、LCM、ADD 的路线)。DDIM 反而是这些蒸馏方法常用的”教师 ODE 轨迹”来源。
- 采样的两个旋钮:τ(控制速度)与 η(在确定性 DDIM η=0 与随机 DDPM η=1 间插值)。
Infra(训练 / 推理工程)
- 训练算力:未单独披露(CIFAR10/LSUN 复用 DDPM 公开 checkpoint;仅 CelebA 自训,论文未给具体 GPU·时)。
- 推理硬件与吞吐:实验在单张 Nvidia 2080 Ti 上度量。论文 Figure 4 给出关键工程结论——采样墙钟时间随轨迹长度 S 线性增长,因此把 S 从 1000 降到 20–100 即得近线性的 10×–50× 加速。文中基线数字:DDPM 在该卡上采 5 万张 32×32 约 20 小时、256×256 约 1000 小时;DDIM 把同质量样本压到 20–100 步内产出。
- 并行/混合精度/量化:未报告(与方法无关)。
- 部署形态:作为采样器被广泛集成——HuggingFace
diffusers库提供DDIMScheduler/DDIMPipeline,可直接套到 latent-diffusion-ldm/Stable Diffusion 等更强模型上(README 给了把DDIMScheduler装到 SD-v1.5 的示例)。
评测 benchmark(把效果讲清楚)
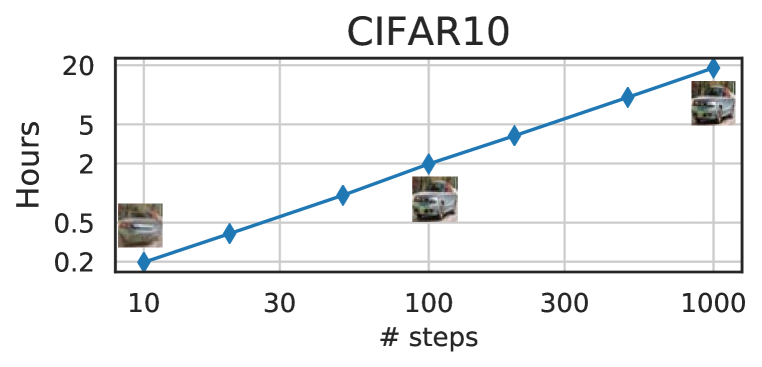
图源:Song et al. 2021, “Denoising Diffusion Implicit Models” (arXiv:2010.02502) Figure 4 — CIFAR10 上采样耗时随步数变化(步数越少越快,配同随机种子的样本质量插图)
所有数字均来自论文(已落盘 ddim--paper-ar5iv.md),指标为 FID(越低越好),S=采样步数,η=0 为 DDIM、η=1 与 σ̂ 为 DDPM 变体。
Table 1 — CIFAR10 (32×32) FID,按步数 S = 10 / 20 / 50 / 100 / 1000:
| η | 10 | 20 | 50 | 100 | 1000 |
|---|---|---|---|---|---|
| 0.0 (DDIM) | 13.36 | 6.84 | 4.67 | 4.16 | 4.04 |
| 0.2 | 14.04 | 7.11 | 4.77 | 4.25 | 4.09 |
| 0.5 | 16.66 | 8.35 | 5.25 | 4.46 | 4.29 |
| 1.0 (DDPM) | 41.07 | 18.36 | 8.01 | 5.78 | 4.73 |
| σ̂ (DDPM-大方差) | 367.43 | 133.37 | 32.72 | 9.99 | 3.17 |
Table 1 — CelebA (64×64) FID,S = 10 / 20 / 50 / 100 / 1000:
| η | 10 | 20 | 50 | 100 | 1000 |
|---|---|---|---|---|---|
| 0.0 (DDIM) | 17.33 | 13.73 | 9.17 | 6.53 | 3.51 |
| 0.2 | 17.66 | 14.11 | 9.51 | 6.79 | 3.64 |
| 0.5 | 19.86 | 16.06 | 11.01 | 8.09 | 4.28 |
| 1.0 (DDPM) | 33.12 | 26.03 | 18.48 | 13.93 | 5.98 |
| σ̂ (DDPM-大方差) | 299.71 | 183.83 | 71.71 | 45.20 | 3.26 |
Table 3 — LSUN 256×256 FID(DDPM 1000 步基线:Bedroom 6.36、Church 7.89):
| dim(τ) | Bedroom 10 | 20 | 50 | 100 | Church 10 | 20 | 50 | 100 |
|---|---|---|---|---|---|---|---|---|
| DDIM (η=0) | 16.95 | 8.89 | 6.75 | 6.62 | 19.45 | 12.47 | 10.84 | 10.58 |
| DDPM (η=1) | 42.78 | 22.77 | 10.81 | 6.81 | 51.56 | 23.37 | 11.16 | 8.27 |
关键结论:
- 少步数下 DDIM 全面碾压 DDPM:S=10 时 CIFAR10 DDIM 13.36 vs DDPM 41.07;CelebA 17.33 vs 33.12;LSUN Bedroom 16.95 vs 42.78。σ̂ 版 DDPM 在短轨迹下灾难性退化(CIFAR10 S=10 FID=367)。
- 质量随步数单调改善,提供”算力↔质量”可调权衡;DDIM 在 20–100 步即达到接近 1000 步的质量(论文明确:CelebA 20 步 DDIM ≈ 100 步 DDPM)。
- 唯一 DDPM 略胜处:S=1000 步、用 σ̂ 时 DDPM 微弱领先(CIFAR10 3.17 vs DDIM 4.04),即步数充足时随机性带来极小优势,但这正是 DDIM 不需要的场景。
Table 2 — 重构误差(CIFAR10 测试集,每维 MSE,缩放到 [0,1]),验证 ODE 可逆性:
| S | 10 | 20 | 50 | 100 | 200 | 500 | 1000 |
|---|---|---|---|---|---|---|---|
| Error | 0.014 | 0.0065 | 0.0023 | 0.0009 | 0.0004 | 0.0001 | 0.0001 |
步数越多重构误差越小(1000 步 ≈1e-4),证明 DDIM 像 Neural ODE / 归一化流一样可编码—重构,DDPM 因随机性做不到。
消融/定性结论:(1) 一致性(Sample consistency)——固定 x_T、改变轨迹长度 τ,生成图的高层特征基本不变,说明 x_T 是一个信息充分的潜在编码、细节才靠更长轨迹补足;DDPM 无此性质。(2) 语义插值——直接在 x_T 上做插值(slerp)即得语义连贯的图像渐变,DDPM 因随机性无法做到。
创新点与影响
核心贡献
- 非马尔可夫前向过程族:证明 DDPM 目标只依赖边缘,从而构造共享同一训练目标的一族过程(Theorem 1),打通”训练一次、采样任选”。
- 确定性采样器(σ=0 / DDIM):把扩散采样从 1000 步降到几十步且质量几乎不掉,10×–50× 墙钟加速,给出 FID↔步数的连续权衡。
- 隐式模型属性:确定性 → x_T 成为可控潜变量,支持语义插值与编码—重构。
- Neural ODE / 概率流视角:揭示 DDIM = 某 ODE 的 Euler 解,且等价于 score-sde VE-SDE 的概率流 ODE,并指出可反向积分编码。
影响
- 成为几乎所有扩散模型的默认快速采样器(被
diffusers等框架内置DDIMScheduler,套用于 latent-diffusion-ldm/Stable Diffusion 等)。 - DDIM inversion 由 4.3 节的可逆 ODE 思路发展而来,成为 prompt-to-prompt、Null-text inversion、SDEdit 类图像编辑的基石——确定性轨迹让”把真实图编码回噪声再重新生成”可行。
- 开启少步扩散采样研究线:直接催生 dpm-solver 等高阶 ODE 求解器,并为 consistency-models/LCM/ADD 等步数蒸馏提供教师轨迹。
已知局限
- 步数极充足(~1000)时质量略逊于随机 DDPM(σ̂),随机性在长轨迹下有微小增益。
- 仍需多步前向(几十步),未达单步生成——这一空白由后来的一致性/蒸馏模型填补。
- 论文仅在无条件像素空间小/中分辨率数据集(≤256×256)验证;未涉及文生图、潜空间或大规模条件生成(这些由后续工作承接)。
原始链接
- arxiv_abs: https://arxiv.org/abs/2010.02502
- arxiv_pdf: https://arxiv.org/pdf/2010.02502
- 全文(ar5iv HTML 镜像,含公式/表格/附录): https://ar5iv.labs.arxiv.org/html/2010.02502
- github: https://github.com/ermongroup/ddim
- diffusers 集成(DDIMPipeline/DDIMScheduler): https://huggingface.co/docs/diffusers/api/pipelines/ddim
一手源存档(sources/)
- arxiv-2010.02502.pdf (官方 PDF 原文,22 页,含正文 + 全部公式 + Table 1/2/3 + 附录 B 证明 / D 实验细节;已 pdftotext 核对全部 FID 数字)
- paper-ar5iv.md (ar5iv 全文 HTML→markdown,含方法 Eq.5–16、Theorem 1、Table 1/2/3 全部 FID 数字、附录 D 实验细节)
- readme.md (ermongroup/ddim 官方仓库 README,含 η/STEPS 采样命令与 diffusers 集成示例)
取数说明:官方 PDF(export.arxiv.org/pdf/2010.02502,10.86 MB / 22 页)经不走本地代理的直连成功落盘(之前经代理时被截断在 9 MB 导致 PDF 损坏,去代理后拿到完整文件);另保留 cloakbrowser 抓取的 ar5iv 全文 HTML→markdown 作为可检索镜像。本页所有 benchmark 数字、架构与实验细节均已用
pdftotext对 PDF 原文逐项核对,未臆造。