一句话定位
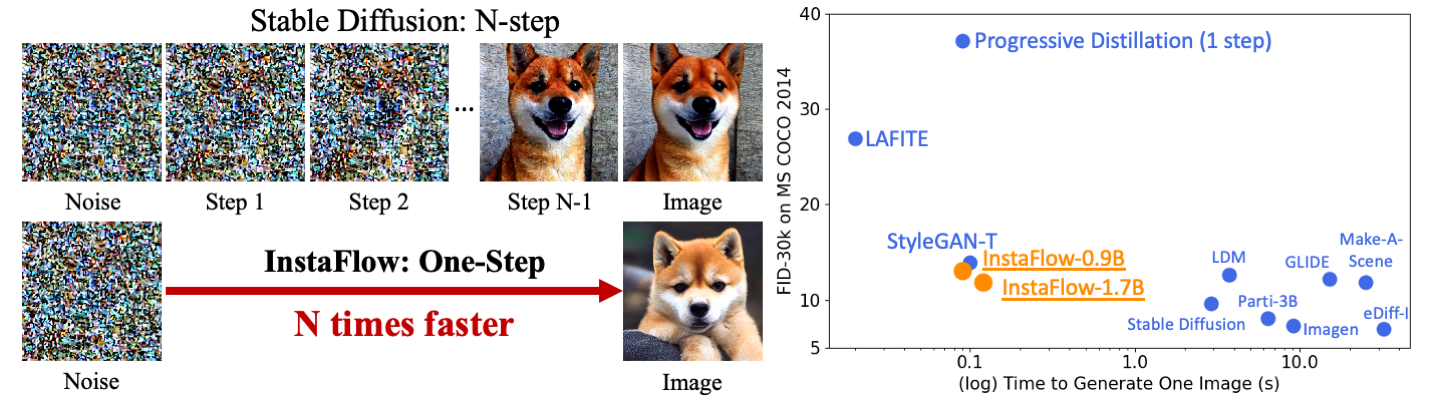
InstaFlow 是第一个由 Stable Diffusion 蒸馏得到、能在单步(one-step)生成 SD 级质量图像的文生图模型——核心方法是把 SD 当作 1-flow,先用 text-conditioned reflow(文本条件回流)拉直 ODE 轨迹、改善 noise↔image 配对,再做单步蒸馏。最亮眼结果:MS COCO 2017-5k 上单步 FID=23.4(0.09 秒/图),把此前最佳单步方法 Progressive Distillation 的 37.2 直接打到 23.4;COCO 2014-30k 上 FID=13.1,首次让蒸馏单步 SD 追平大规模文生图 GAN(StyleGAN-T 13.9),而全部微调只花 199 A100 GPU days。ICLR 2024 收录。
背景与定位
扩散模型质量高但推理慢:SD 即便配最好的采样器(dpm-solver 等)也要 20+ 步,<10 步时质量明显塌。此前把扩散压到 1 步的尝试基本失败——Progressive Distillation([58])只能做到 2/4 步、强行 1 步 FID 退化到 37.2;唯二能单步的大规模 T2I 模型是 GAN 路线的 StyleGAN-T、GigaGAN,但需要精心调对抗训练。
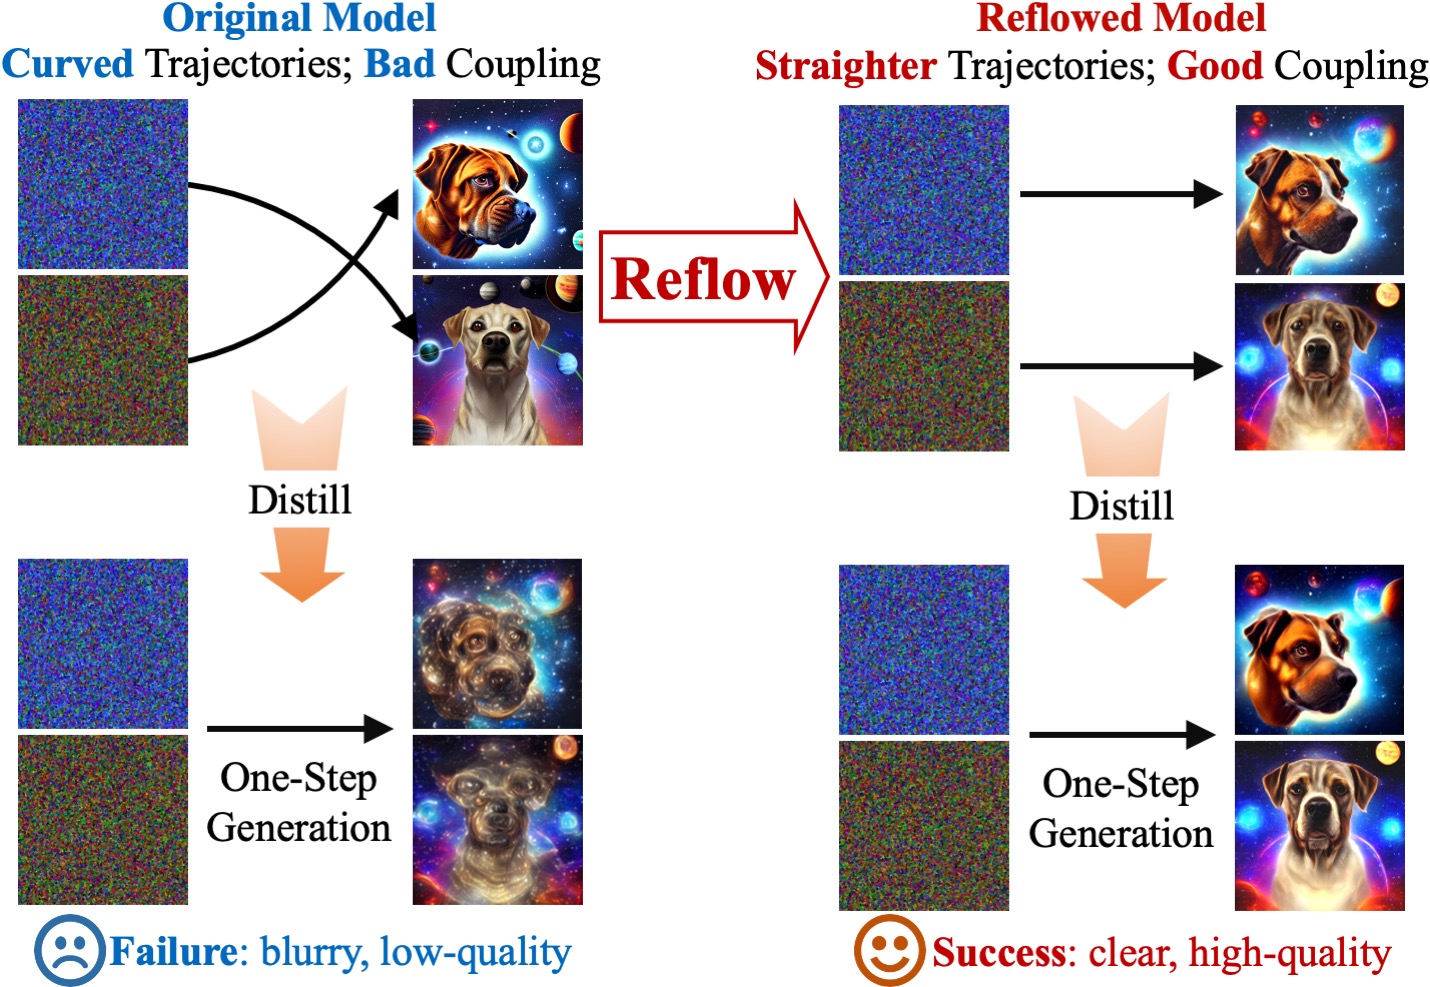
作者的核心洞察:直接蒸馏 SD 之所以失败,根因是 SD 概率流 ODE 轨迹弯曲、噪声与图像之间的耦合(coupling)很差,学生网络一步学不会这种”扭曲映射”。InstaFlow 把 rectified-flow(Liu et al. 2022 的 reflow 思想,此前只在 CIFAR10 等小数据集验证过)首次扩到大规模文生图:reflow 在不改变边缘分布的前提下迭代拉直轨迹、降低传输代价、把耦合变规整,从而让单步蒸馏变得可行。它与 stable-diffusion-1、latent-diffusion-ldm、ddpm 一脉相承(都在 SD 的潜空间上做),并与同期的 consistency-models / latent-consistency-models、dmd、sdxl-turbo-add(ADD)并列为”少步/单步生成”的里程碑工作——区别在于 InstaFlow 不用对抗损失、不用一致性约束,纯监督最小二乘。
模型架构
图源:InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image Generation (arXiv:2309.06380) Figure 3
完全复用 SD 的三段式结构,不引入新组件:
- Text encoder:CLIP ViT-L/14,训练全程冻结(编码 1 张图约 0.01s)。
- 潜空间生成器(被蒸馏的主体):SD 的 U-Net。reflow 阶段不改结构、只微调;蒸馏阶段把时间固定 t=0、学单步 Euler 映射
x + v(x|T)。 - VAE decoder:复用 SD 预训练自编码器,下采样因子 8,训练冻结(解码约 0.04s)。
- 条件注入 / CFG:提出”Classifier-Free Guidance 速度场”——
v^α(Z_t,t|T)=α·v(Z_t,t|T)+(1-α)·v(Z_t,t|NULL),α 同样在质量/多样性间权衡;α↑ 同时抬高 FID-5k 和 CLIP(语义对齐变好但画质退化),2-Rectified Flow 蒸馏时用 α=1.5。
两个规模:
- InstaFlow-0.9B:标准 SD U-Net,~0.9B 参数,512×512 单步 0.09s。
- InstaFlow-1.7B(Stacked U-Net):把两个 U-Net 串联(不共享参数)得到 ~1.7B 大网络,0.12s。其结构来自一组消融(附录 B):串两个 U-Net 能显著降蒸馏损失、提质量但翻倍耗时;于是逐块删,发现唯一删了不掉点的是”删掉中间 In+Out Block”(Structure 3),由此换来约 7.7% 推理提速(0.13s→0.12s)。
分辨率策略:评测主体为 512×512;论文还演示 InstaFlow 单步出 512 图作”快速预览器”,再用 sdxl 的 SDXL-Refiner 插值到 1024 精修,作为高效高分辨率流水线。
数据
- 训练用的不是真实图文对,而是 SD 自己生成的三元组:从 SD(教师)按文本 prompt 用 ODE 采样出 (text, noise, image) 三元组
(X0, X1=ODE[v_SD](X0|T)),作为 reflow 与蒸馏的监督数据。 - 文本 prompt 集 D_T:取自 laion2B-en(stable-diffusion-1 同款过滤的 LAION 子集),只用 prompt,不用 LAION 原图。
- 数据量:预实验(SD 1.4)直接蒸馏生成 3,200,000 对
(X0, ODE[v_SD](X0));reflow / 蒸馏各 1,600,000 对(25 步 Euler/DPMSolver 求解)。正式 InstaFlow 数据生成同量级(3.2M 对,约消耗 16 GPU-day 量级)。 - 清洗/标注/合成:未做额外清洗或 re-caption;数据本质是”蒸馏教师 SD 的分布”,质量上限即 SD。安全/美学过滤未涉及(推理时报告的时延不含 NSFW detector)。
训练方法
纯监督学习,无对抗、无可逆网络、无一致性损失。三步流水线:
-
生成三元组——用预训练 SD(v1=v_SD,25 步 DPMSolver、固定 guidance)从噪声+prompt 采样图像,得到
(X0, X1)配对。 -
Text-Conditioned Reflow(关键创新)——以线性插值
X_t=tX1+(1-t)X0学新速度场,最小化v_{k+1}=argmin E[‖(X1−X0)−v(X_t,t|T)‖²],其中X1=ODE[v_k](X0|T)。 reflow 三大性质(论文 §2.2):①保持终端分布不变(仍生成正确的 π1);②轨迹更直(需要更小的 Euler 步 N);③新耦合(X0, ODE[v_{k+1}](X0|T))的凸传输代价更低 ⇒ 学生更易学。得到的 v2 称 2-Rectified Flow,可重复回流得 3-RF(论文试过,发现 2 步已够、3-RF 需把 lr 从 1e-6 降到 1e-7 才稳,正式版未采用)。 -
单步蒸馏——固定 t=0,学
ṽ_k=argmin E[D(ODE[v_k](X0|T), X0+v(X0|T))],相似度损失 D 先用 L2、后切 LPIPS(AlexNet 版)。蒸馏与 reflow 正交:作者反复强调,不先 reflow、直接蒸 SD 必然失败(FID 40.9 / 68.3),先 reflow 把映射变规整后再蒸才成功(FID 23.4)。
straightness 度量 S(Z)=∫E‖(Z1−Z0)−v(Z_t,t)‖²dt(越小越直,全直时=0),实测 reflow 显著降低 S(Z),定量验证拉直效果。
关键超参 / trick(附录 C/D):AdamW;EMA 0.9999;grad-norm clip=1;warmup 1000 步;BF16 训练省显存;reflow lr=1e-6;SD guidance 由 6.0(1.4 预实验)降到 5.0(1.5 正式版,否则 2-RF 过饱和);用梯度累积把 batch 撑到 >32。
InstaFlow-0.9B 完整四阶段(共 199.2 A100-day):数据生成 16 day → Reflow Stage1(batch 64,70k iter,11.2 day)→ Reflow Stage2(batch 1024,25k iter,64 day)→ Distill Stage1(固定 t=0,L2,batch 1024,21.5k iter,54.4 day)→ Distill Stage2(切 LPIPS,batch 1024,18k iter,53.6 day)。 InstaFlow-1.7B:从 2-RF 起,Stacked U-Net 蒸馏 Stage1(L2,batch 64,110k iter,35.2 day)+ Stage2(LPIPS,batch 320,2.5k iter,4.4 day),合计 39.6 day。
Infra(训练 / 推理工程)
- 算力:预实验(SD 1.4)2-RF+Distill 仅 24.65 A100 GPU days;正式 InstaFlow-0.9B 199 A100 GPU days,1.7B 额外 39.6 day。对照之下从头训 SD 1.4 需 6250 A100-day、StyleGAN-T 1792、GigaGAN 4783、一步 PD 下限 108.8——InstaFlow 因为是在公开 SD 上微调,成本”可忽略”。
- 硬件 / 软件栈:8× A100(预实验)/ 梯度累积扩 batch;PyTorch 2.0.1 + HuggingFace Diffusers 0.19.3;训练脚本改自 Diffusers 官方 text2image 微调示例;BF16。
- 吞吐参考:batch=4 + U-Net 时 1 A100-day 可跑 ~100k iter(L2)/ ~86k iter(LPIPS);batch=16 数据生成 1 A100-day 出 ~200k 对。
- 推理:单步直接 noise→image,A100 上 0.9B 约 0.09s、1.7B 约 0.12s(含 0.01s 文本编码 + 0.04s VAE 解码,不含 NSFW 检测),相比 25 步原 SD 省约 90% 时间。
- 生态兼容(README):InstaFlow 单步模型直接兼容预训练 ControlNet、LoRA、SDXL-Refiner(无需重训);社区提供 ONNX 版、Colab、本地 Gradio。
评测 benchmark(把效果讲清楚)
图源:InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image Generation (arXiv:2309.06380) Figure 1
统一在 NVIDIA A100、batch=1 测时延。核心数字(论文 Table 1/2/4/5):
MS COCO 2017-5k(FID-5k / CLIP,评测协议沿用 Progressive Distillation [58];论文未明示 FID 计算分辨率,仅 COCO2014 注明下采样到 256) —— 下列正式版数字取自 Table 2a(SD 1.5 系),预实验数字取自 Table 1a/Table 4(SD 1.4 系)。
- SD 1.5(25 步):FID 20.1 / CLIP 0.318(0.88s);2-RF(25 步):21.5 / 0.315。
- Progressive Distillation-SD 1 步:FID 37.2 / 0.275;2 步 26.0;4 步 26.4。
- 正式版未蒸馏单步 2-RF(SD1.5):47.0 / 0.271;预实验 SD 1.4+Distill(直接蒸馏,无 reflow,U-Net):FID 40.9,几乎不可用。
- InstaFlow-0.9B(1 步,0.09s):FID 23.4 / CLIP 0.304 —— 比 PD 1 步(37.2)大幅领先,且蒸馏成本相当(108 ↔ 108.8 A100-day)。
- InstaFlow-1.7B(1 步,0.12s):FID 22.4 / CLIP 0.309 —— 更接近 25 步 SD。
MS COCO 2014-30k(FID-30k,生成图下采样到 256×256 后算 FID,对齐 StyleGAN-T/GigaGAN 口径,Table 5 caption)
- SD*:9.62;2-RF(25 步):13.4。
- SD 1.4+Distill(无 reflow,U-Net):34.6;2-RF+Distill(U-Net):20.0 —— 直观证明 reflow 的增益(34.6→20.0)。
- InstaFlow-0.9B:FID 13.10(0.09s),超过 StyleGAN-T 的 13.90(0.10s),是”≤0.1 秒档”最佳;InstaFlow-1.7B:11.83。对照同表大模型:DALL·E 27.5、GLIDE 12.24、LDM 12.63、Imagen 7.27、Parti-20B 7.23、GigaGAN 9.09。
关键消融与结论:
- Reflow 是单步蒸馏成功的前提(预实验 SD 1.4,COCO2017-5k,Table 1/4):直接蒸 SD(U-Net 40.9、Stacked U-Net 52.0)几乎不可用;不蒸的单步 2-RF 本身也只有 68.3;而先 reflow 再蒸(Pre 2-RF+Distill)降到 31.0(正式版扩规模后进一步到 InstaFlow-0.9B 的 23.4)。且 2-RF+Distill 与教师 2-RF 的 FID 差距远小于 SD+Distill 与 SD(论文 Fig 5),说明 2-RF 是”更好教师”。
- Stacked U-Net 消融(附录 B/Table 4):5 种删块方案里唯有删中间 In+Out Block 不掉点,2-RF+Distill(Stacked U-Net) FID-5k 24.6 / COCO2014 13.7,明显优于无 reflow 的 Stacked 直蒸(52.0 / 41.5)。
- 少步生成:2-RF 在 N≤4 步时清晰可辨,而 SD 1.5-DPMSolver 在同 N 下还是噪点(论文 Fig 9/15)。
- 多次 reflow:3-RF+Distill(U-Net) FID 29.3,并未优于 2-RF(误差累积 + 需降 lr),故正式版止步 2-RF。
- 直接蒸馏网格搜索(Table 3):lr∈{1e-5,1e-6,1e-7}×wd∈{1e-1,1e-2,1e-3},最优也只到 FID 44;lr≥1e-4 直接 NaN——印证”不 reflow 调不出来”。
- 未报告 GenEval / T2I-CompBench / DPG-Bench / HPSv2 / ImageReward / 人评 ELO 等(2023 年这些 benchmark 尚未流行,论文只用 FID + CLIPScore)。
创新点与影响
核心贡献:①首次把 Rectified Flow 的 reflow 从小数据集扩到大规模文生图,给出 text-conditioned reflow 目标;②由此造出第一个 SD 级质量的单步扩散文生图模型,且纯监督(无 GAN、无一致性损失、无可逆网络);③定量揭示”直接蒸馏失败=噪声-图像耦合差”,并用 straightness 指标 S(Z) 量化 reflow 的拉直作用;④极低成本(199 A100-day 微调)即追平大规模 T2I GAN。
影响:与 consistency-models / latent-consistency-models、sdxl-turbo-add(ADD)、dmd 并列为 2023 年”少步/单步生成”四大代表路线,把 reflow 推成主流加速范式之一;催生 PeRFlow(piecewise rectified flow)等后续工作,并把 rectified-flow 思想外溢到文生 3D、图像反演/编辑(README 提到的 rectified_flow_prior)。更深远地,reflow / flow matching 的”拉直直线流”思想后来被 SD3、FLUX 等 MMDiT 主干采纳为训练目标(flow-matching 路线),InstaFlow 是其在大规模 T2I 上”少步可行性”的早期实证。单步模型还兼容 ControlNet/LoRA,且其规整潜空间便于编辑分析。
已知局限:①质量上限受教师 SD 约束,复杂构图/多对象组合仍会失败(论文 Fig 11);②2-Rectified Flow 在论文中未完全收敛,作者明言更长训练/更大数据可继续提升;③评测仅 FID+CLIP,缺组合性与人评维度;④”快速预览器”需 SDXL-Refiner 二次精修才能上 1024 高分辨率。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2309.06380
- paper PDF: https://arxiv.org/pdf/2309.06380
- code (GitHub): https://github.com/gnobitab/InstaFlow
- demo (HF Space): https://huggingface.co/spaces/XCLiu/InstaFlow
- official Rectified Flow repo: https://github.com/gnobitab/RectifiedFlow
一手源存档(sources/)
- arxiv-2309.06380.pdf (arXiv 原文 PDF,不入 git)
- readme.md