一句话定位
Flow Matching(FM)提出一种 simulation-free(无需 ODE 仿真) 的训练目标,把”训练连续正规化流(CNF)“从昂贵的极大似然 ODE 反传,降维成”回归一个固定条件概率路径的向量场”的简单 L2 回归;其核心创新 Conditional Flow Matching(CFM) 证明了”边际向量场损失”与”逐样本条件向量场损失”梯度等价,并引入 最优传输(OT)直线路径 替代扩散曲线路径——在 ImageNet 上 FM-OT 在 NLL/FID/采样步数三项上一致优于 DDPM/Score Matching/ScoreFlow(ImageNet-128 FID 20.9,仅用 500k iter 即超过扩散基线 4.36m iter 的训练量)。它是后来 SD3、FLUX、Lumina 等”rectified-flow 文生图”模型的理论基石。
背景与定位
- 要解决的问题:ddpm 这类扩散模型虽可扩展、训练稳定,但被局限在”简单扩散过程”导出的概率路径上 → 采样路径空间受限、训练慢、需要专门的快速采样器(DDIM/指数积分器等)。另一端,连续正规化流(CNF,Chen et al. 2018 Neural ODE) 理论上能建模任意概率路径,但传统极大似然训练要做昂贵的前/后向 ODE 仿真,无法扩展到高维图像;已有的 simulation-free 尝试要么涉及高维难估的积分(Moser Flow),要么在 minibatch 下梯度有偏(Ben-Hamu 2022)。
- 本文定位:给 CNF 提供首个可扩展、simulation-free、无偏梯度的训练框架,且绕开扩散 SDE 的构造,直接在”概率路径”层面设计动力学。这让”扩散路径”只是其中一个特例,从而打开”非扩散路径”(尤其 OT 直线路径)的大门。
- 技术脉络位置:与 latent-diffusion-ldm/ddpm 同属”通过 ODE/SDE 在噪声-数据间搬运概率质量”的连续生成范式;FM 把 Song et al. 2021 的 probability-flow ODE 视角推广,并与同期的 rectified-flow(Liu et al. 2022, arXiv:2209.03003)和 Stochastic Interpolants(Albergo & Vanden-Eijnden 2022, arXiv:2209.15571)独立殊途同归——三者都得到类似的条件回归目标。FM 的 OT 路径(µ_t=t·x₁,σ_t 线性)在 σ_min→0 时即 rectified flow 的”直线插值”。
模型架构
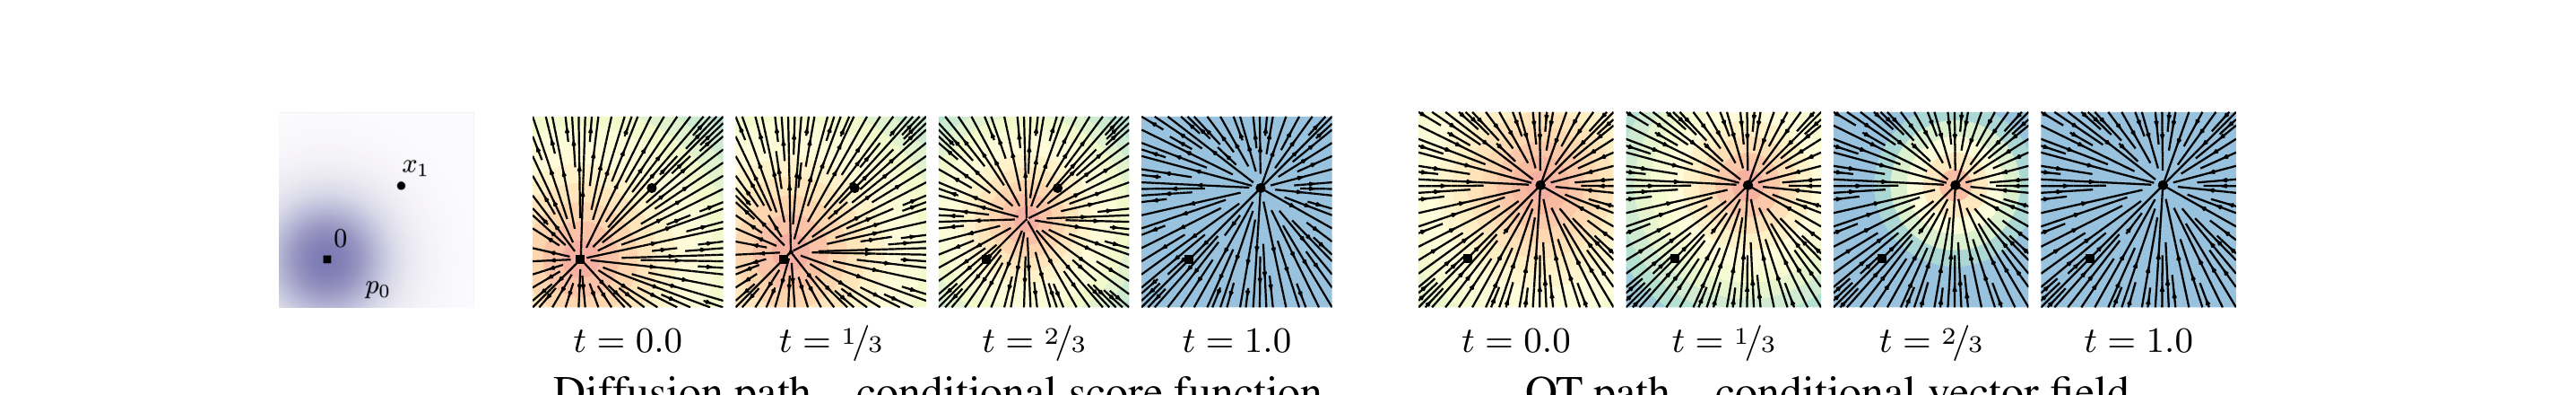
图源:Lipman et al., “Flow Matching for Generative Modeling” (arXiv:2210.02747) Figure 2 — 扩散路径条件 score function vs OT 路径条件向量场(t=0→1)
本文是方法/理论工作,不发布产品或权重;架构沿用已有 backbone,只替换训练目标。
- 被建模对象:神经网络直接参数化时间相关向量场 v_t(x;θ): [0,1]×R^d→R^d(注意不是 score、不是 ε,而是 ODE 的速度场)。生成时从先验噪声 x₀∼N(0,I) 出发,用现成 ODE 求解器积分 dφ_t/dt=v_t(φ_t) 到 t=1 得样本。
- Backbone:图像实验直接复用 Dhariwal & Nichol (2021) 的 U-Net(ADM 架构),“minimal changes”,不引入新结构;2D toy 实验用 5 层×512 的 MLP。FM 的贡献与 backbone 正交——任何接收 (x,t) 的网络都能用。
- 无 VAE / tokenizer / text-encoder:本文在像素空间直接做无条件/类条件/超分生成,不涉及 latent VAE、VQ、CLIP/T5 文本编码(这些是后来 SD3/FLUX 把 FM 搬到 latent+文本条件时才加的)。
- 分辨率策略:分别在 CIFAR-10、ImageNet-32/64/128 上各训一个模型;ImageNet-128 用比 ADM 基线大 25% 的模型(channels=256, depth=3, channel-mult=1,1,2,3,4, attention@32/16/8)。
- 关键架构性”设计”其实在路径而非网络:选用 Gaussian 条件路径 p_t(x|x₁)=N(x|µ_t(x₁),σ_t(x₁)²I),并取最简的标准(canonical)仿射流 ψ_t(x)=σ_t(x₁)x+µ_t(x₁)——它把多余的旋转/散度无关分量去掉,使回归目标最简。
数据
- 数据集:CIFAR-10(Krizhevsky 2009)+ ImageNet(Deng 2009)下采样到 32/64/128,外加 ImageNet 64→256 超分实验。均为学术公开数据集,非自建大规模图文对。
- 预处理:图像中心裁剪(center crop)+ resize 到目标分辨率;32×32 / 64×64 沿用 Chrabaszcz et al. (2017) 的下采样 ImageNet 预处理。像素从 [−1,1] 经 ϕ(y)=2⁷(y+1) 映到 [0,256] 用于 BPD 计算;NLL 评测用标准 uniform dequantization + 重要性加权估计(K 个噪声样本,附录 Table 4 给不同 K 的 BPD:CIFAR-10 K=1/20/50、ImageNet-32 K=1/5/15、ImageNet-64 K=1/5/10)。
- 规模/配比/标注/合成数据/美学安全过滤:不适用——这是 2022 年的纯方法论文,主要是无条件生成 ImageNet,无 re-captioning、无合成数据、无美学/安全过滤管线(这些是后续大规模文生图工作才有的内容)。
训练方法
这是本文的核心,分三层递进:
-
Flow Matching 目标(不可直接用):给定目标概率路径 p_t 与生成它的向量场 u_t,
L_FM(θ) = E_{t,p_t(x)} ‖v_t(x) − u_t(x)‖²(式5,t∼U[0,1])。 问题:边际 u_t、p_t 都含难解积分(式6/8),无法直接采样估计。 -
Conditional Flow Matching(CFM)——关键创新:改回归逐样本的条件向量场 u_t(x|x₁):
L_CFM(θ) = E_{t,q(x₁),p_t(x|x₁)} ‖v_t(x) − u_t(x|x₁)‖²(式9)。- Theorem 1:把条件向量场按 p_t(x|x₁)q(x₁)/p_t(x) 加权”边际化”得到的 u_t,确实生成边际路径 p_t(满足连续性方程)。
- Theorem 2:在 p_t(x)>0 前提下,L_FM 与 L_CFM 仅差一个与 θ 无关的常数 → ∇_θ L_FM = ∇_θ L_CFM。
- 意义:训练只需逐样本采 x₁∼q、采 x∼p_t(·|x₁)、算闭式 u_t(x|x₁),完全 simulation-free、无偏、可扩展到高维,无需任何 ODE 仿真,也不必知道难解的边际场。这正是 ddpm denoising score matching 思路的推广(从匹配 score 推广到匹配任意向量场)。
-
条件路径与向量场族(Gaussian 路径,Theorem 3):取 p_t(x|x₁)=N(µ_t,σ_t²I),唯一最简向量场为
u_t(x|x₁) = (σ'_t/σ_t)(x−µ_t) + µ'_t(式15)。两个实例:- Diffusion 路径(特例):选 µ_t、σ_t 复现 VE / VP 扩散路径(式16-19),且证明与 Song et al. 2020b 的 probability-flow ODE 速度场完全一致(附录D)。但即便在扩散路径上,用 FM 目标比用 score matching 更稳定、更鲁棒。
- Optimal Transport(OT)路径——本文主推:µ_t(x)=t·x₁,σ_t(x)=1−(1−σ_min)t(均随时间线性变化),向量场
u_t(x|x₁) = (x₁−(1−σ_min)x)/(1−(1−σ_min)t)(式21)。 该条件流恰是两高斯间的OT 位移映射(McCann 1997)→ 粒子走直线、恒速轨迹;扩散路径却是曲线、会”过冲(overshoot)“后回退。CFM 损失化简为E‖v_t(ψ_t(x₀)) − (x₁−(1−σ_min)x₀)‖²(式23),即回归”数据减噪声”的常向量——与 rectified flow 一致。
- 多阶段/RLHF/DPO/蒸馏:不涉及。本文是单阶段从头训练,无 SFT/偏好对齐,无 consistency/LCM/步数蒸馏;其”加速”来自 OT 直线路径天然好解,而非蒸馏。
- 关键超参(Table 3):Adam(β₁=0.9, β₂=0.999, wd=0, ε=1e-8);学习率 5e-4(CIFAR)/1e-4(ImageNet),polynomial decay 或 constant,warmup(1e-8→peak 线性升,再线性降回 1e-8);VP 扩散用 β_min=0.1, β_max=20;时间采样区间 [0,1−ε], ε=1e-5;σ_min 取很小值使 p_1 集中在 x₁。
Infra(训练 / 推理工程)
- 算力规模(Table 3,本文罕见地公开了 GPU 数):
- CIFAR-10:2 GPU,effective batch 256,1000 epoch / 391k iter。
- ImageNet-32:4 GPU,batch 1024,200 epoch / 250k iter。
- ImageNet-64:16 GPU,batch 2048,250 epoch / 157k iter。
- ImageNet-128:32 GPU,batch 1536,571 epoch / 500k iter。
- 未披露具体 GPU 型号(V100/A100)与总 GPU·时。
- 混合精度:CIFAR-10 与 ImageNet-32 用 full FP32;ImageNet-64/128/256 用 FP16 混合精度。
- 训练效率(核心卖点):ImageNet-128 上 ADM 基线训 4.36m iter(batch 256),FM 仅 500k iter(batch 1536,模型还大 25%),总图像吞吐少 33% 却 FID 更好;ScoreFlow/VDM 报告需 1.3m/10m iter,FM 收敛快得多(Fig.5 FID 曲线下降更快更低)。
- 推理加速:用现成自适应 ODE 求解器 dopri5(Dormand-Prince,atol=rtol=1e-5,torchdiffeq)做高精度采样/似然;低成本采样切固定步求解器(Euler/Midpoint/RK4)。FM-OT 在任何求解器下都最省 NFE:达到同等数值误差只需扩散模型 ~60% 的 NFE(ImageNet-32),且训练全程采样成本恒定,而 score matching 的采样成本会随训练漂移(Fig.10)。
- 似然计算 infra:用 Hutchinson trace 估计器把散度 div(v_t) 的 O(d) 计算变成无偏随机估计(式34-35),配合 instantaneous change-of-variable ODE(式28)算 BPD。FID/IS 用 TensorFlow-GAN 库(ImageNet-128 沿用 openai/guided-diffusion 评测脚本以对齐 ADM)。
评测 benchmark(把效果讲清楚)
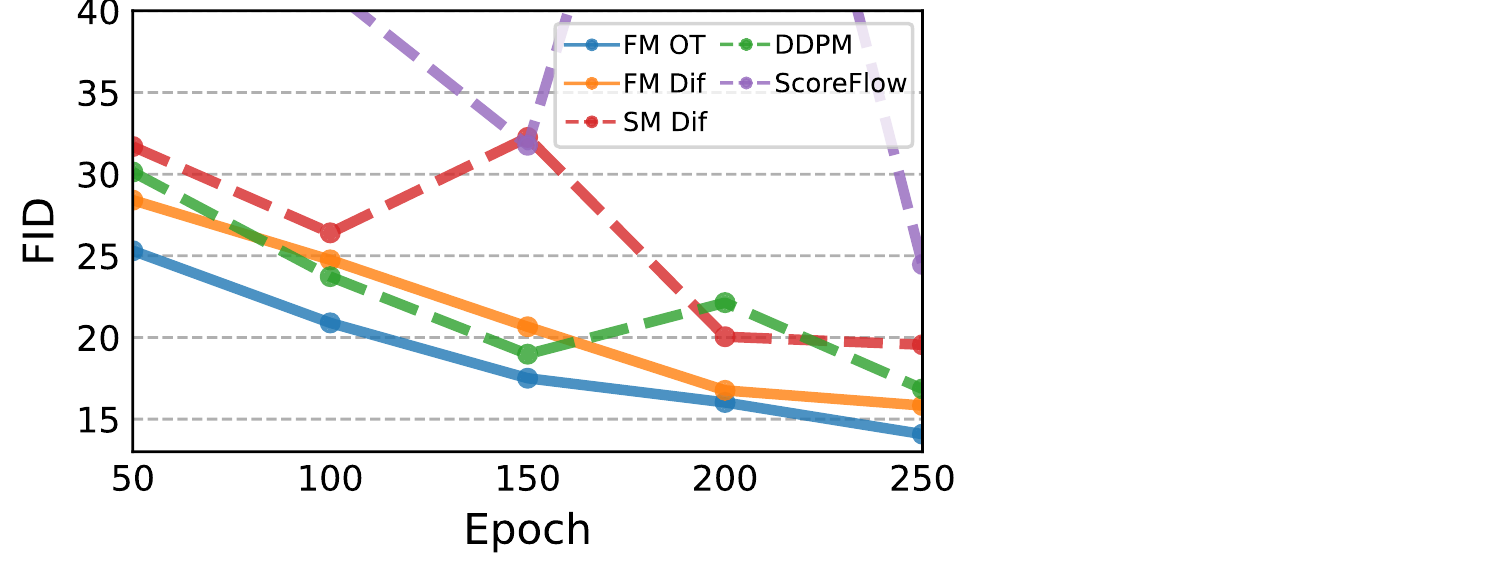
图源:Lipman et al., “Flow Matching for Generative Modeling” (arXiv:2210.02747) Figure 5 — ImageNet-64 训练过程 FID 曲线,FM-OT(蓝)始终最低且收敛最快
所有数字均为无条件生成(除超分外),同架构同超参,FM 三法横评(数字来自论文 Table 1/2/4)。
Table 1 — NLL(BPD↓) / FID↓ / NFE↓:
| 模型 | CIFAR-10 NLL/FID/NFE | ImageNet-32 NLL/FID/NFE | ImageNet-64 NLL/FID/NFE |
|---|---|---|---|
| DDPM | 3.12 / 7.48 / 274 | 3.54 / 6.99 / 262 | 3.32 / 17.36 / 264 |
| Score Matching | 3.16 / 19.94 / 242 | 3.56 / 5.68 / 178 | 3.40 / 19.74 / 441 |
| ScoreFlow | 3.09 / 20.78 / 428 | 3.55 / 14.14 / 195 | 3.36 / 24.95 / 601 |
| FM w/ Diffusion | 3.10 / 8.06 / 183 | 3.54 / 6.37 / 193 | 3.33 / 16.88 / 187 |
| FM w/ OT | 2.99 / 6.35 / 142 | 3.53 / 5.02 / 122 | 3.31 / 14.45 / 138 |
- FM-OT 在三套数据上三项指标几乎全面最优:NLL 最低、FID 最低、NFE(采样函数评估数)最少。NFE 优势尤其明显(如 ImageNet-64:FM-OT 138 vs ScoreFlow 601)。
- 作者注:CIFAR-10 的 FID 整体偏高,因 U-Net 架构是为 ImageNet 调的、未对 CIFAR 优化。
ImageNet-128(Table 1 右):FM-OT FID 20.9 / NLL 2.90,超过一众 GAN(Uncond. BigGAN 25.3、PGMGAN 21.7、Self-cond. GAN 41.7 等),为当时 SOTA(仅 IC-GAN 因用自监督 ResNet50 条件而被排除在对比外)。
超分(Table 2,ImageNet 64→256):FM-OT FID 3.4 / IS 200.8 vs SR3(Saharia 2022)FID 5.2 / IS 180.1;PSNR/SSIM 与 SR3 相当(FM-OT 24.7/0.747 vs SR3 26.4/0.762),即在感知质量(FID/IS)上更优、失真指标略低(作者引 SR3 观点:FID 更能反映生成质量)。
NLL 重要性加权(Table 4):随 K 增大 BPD 单调下降,FM-OT 在所有 K 下 BPD 最低(如 ImageNet-32 K=15:FM-OT 3.53 vs DDPM 3.54 vs ScoreFlow 3.55)。
关键消融结论:
- OT 路径 > 扩散路径:FM-OT 全面优于 FM-Diffusion(训练更快、NFE 更少、FID/NLL 更好);直线轨迹避免扩散的”过冲-回退”。
- FM 目标 > Score Matching 目标(同为扩散路径):FM-Diffusion 比 SM-Diffusion 更稳定(2D checkerboard Fig.4/9),FID 也更好,说明”回归向量场”本身比”回归 score”更鲁棒。
- 低 NFE 行为(Fig.7):FM-OT 即使在极低 NFE(≤100)下也能保持低数值误差与不错 FID,给出最佳”质量-成本”折中。
创新点与影响
- 核心贡献:
- Flow Matching / Conditional Flow Matching 目标:首个对 CNF 可扩展、simulation-free、无偏梯度的训练范式(Thm 1/2 给出理论保证:条件目标=边际目标的梯度)。
- 统一视角:把扩散模型解释为 FM 在”扩散 Gaussian 路径”上的特例,从而”扬弃 SDE 构造,直接设计概率路径”。
- OT/直线路径:用最优传输位移插值定义条件路径,得到直线恒速轨迹 → 训练更快、采样步数更少、泛化更好。
- 后续影响(行业基石):FM/CFM + OT(rectified) 路径成为现代”flow-matching 文生图/视频”主流训练目标——Stable Diffusion 3(rectified flow + MMDiT)、FLUX、Lumina、Meta Movie Gen 等均以此为训练核心;与同期 Rectified Flow、Stochastic Interpolants 共同奠定了”对噪声-数据直线插值回归速度场”的范式,几乎取代了 ε-prediction 的 DDPM 损失。作者团队后续还出了《Flow Matching Guide and Code》系统综述与库。
- 已知局限:
- 实验仅到 ImageNet-128 像素空间、无条件/类条件,未触及大规模文生图/latent/文本条件(留给后人)。
- “条件流是 OT 最优”不等于”边际向量场是 OT 最优”——直线性只在条件层面严格,边际路径仍可能弯曲(作者明确指出,仅”期望边际场仍相对简单”)。
- 采样仍是多步 ODE 积分,本文未做步数蒸馏/一步生成(后续 consistency/distillation 工作补足)。
- 未公开 GPU 型号与总算力,未发布代码/权重(纯方法论文)。
原始链接
- arxiv_abs: https://arxiv.org/abs/2210.02747
- arxiv_pdf: https://arxiv.org/pdf/2210.02747
一手源存档(sources/)
- arxiv-2210.02747.pdf (arXiv 原文 PDF,不入 git)