一句话定位
Meta 的「媒体基座套件」:一个 30B 参数的 Flow Matching 联合图/视频生成模型(Movie Gen Video,最长 16s/1080p/同步音频)+ 一个 13B 的 视频/文本到音频模型(Movie Gen Audio),并通过后训练加挂 个性化 与 无监督视频编辑 两项能力。最大亮点是把扩散类视频生成的骨干整体换成 LLaMa3 架构并验证其优于 DiT(质量净胜率 +18.6%、文本对齐 +12.6%),用 6,144 张 H100、73K token 上下文规模化训练;人评上对 Runway Gen3 总体净胜 35.0%、对 Sora 净胜 8.2%、与 Kling1.5 持平。
背景与定位
Movie Gen 是 Meta 生成式媒体的「第三波」工作,延续自 Make-A-Scene(场景图)、Emu/Emu Video/Emu Edit(扩散图像与视频)这条脉络(详见 emu / latent-diffusion-ldm)。它要解决的核心问题是:把图像、视频、音频、编辑、个性化这些此前分裂的能力统一到少数几个可规模化的基座模型上,并第一次以近百页技术报告的体量披露 infra/数据/训练配方。
技术定位上有两条主张:
- 用 LLM 的架构与并行经验做视频生成——放弃媒体生成主流的 DiT(dit-scalable-diffusion-transformers)专用块,直接照搬 LLaMa3 Transformer block,从而能”自信地”放大模型规模并复用 LLM 的 3D 并行栈。
- 用 Flow Matching(flow-matching / rectified flow)替代扩散——天然零终端 SNR、对噪声 schedule 更鲁棒,简化训练目标。
相对前置工作(Emu Video 用因子化的”先生图再生视频”+ 帧插值),Movie Gen 通过 8× 时空压缩的 TAE 直接在原生帧率上生成长视频,取消了帧插值模型,结构更简单。它对标的是同期闭源 SOTA:OpenAI Sora、Runway Gen3、LumaLabs、Kling1.5(视频)与 Flux.1 / DALL-E 3 / Midjourney V6.1 / Ideogram V2(图像)。
模型架构
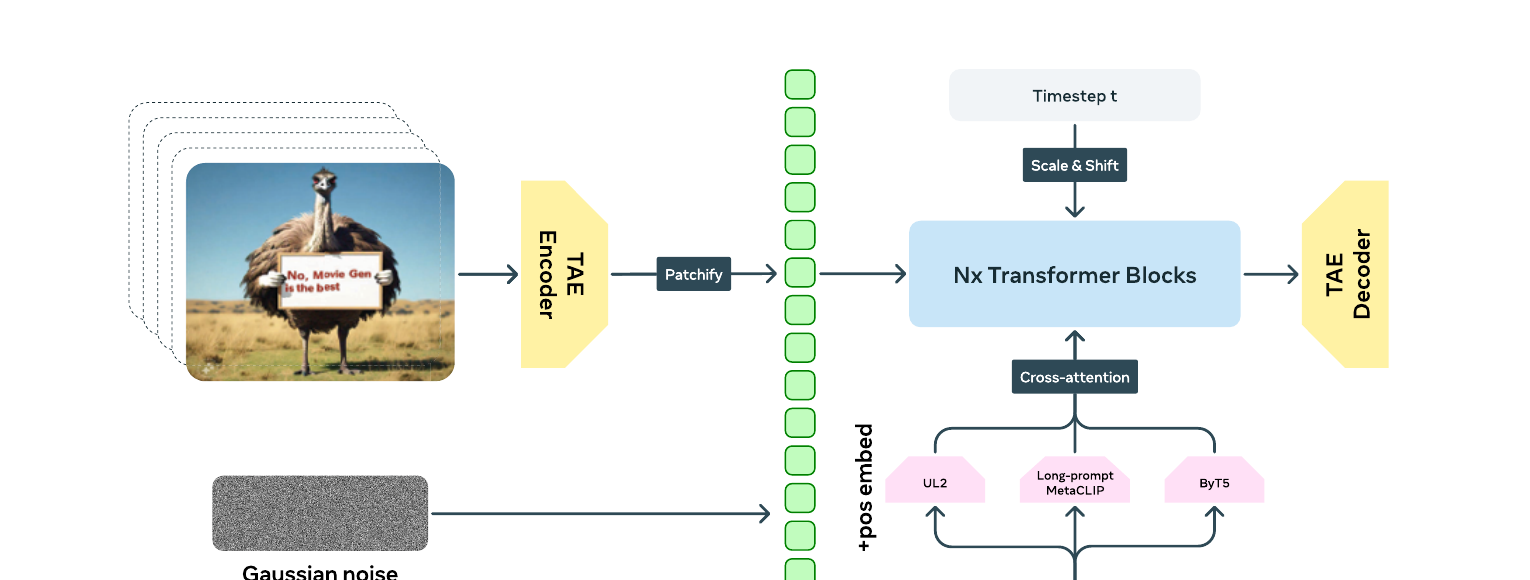
图源:Movie Gen: A Cast of Media Foundation Models(Meta, 2024)Figure 3「Overview of the joint image and video generation pipeline」https://ai.meta.com/static-resource/movie-gen-research-paper
Movie Gen Video(30B,联合 T2I + T2V)
- Backbone:Transformer,严格照搬 LLaMa3 设计空间——RMSNorm、SwiGLU、48 层、model dim 6144、FFN dim 16384、48 个注意力头。30B 仅指 Transformer 本体(不含文本编码器/TAE)。对 LLaMa3 block 做了 3 处改造:(1) 在 self-attn 与 FFN 之间插入 cross-attention 注入文本条件;(2) 加 adaptive layer norm(adaLN)注入 flow 时间步 t;(3) 用全双向注意力取代因果注意力。消融显示 LLaMa3-like 架构对 DiT 在质量上 +18.6%、文本对齐 +12.6%。
- Visual tokenizer(TAE,Temporal Autoencoder):基于 VAE,把 RGB 视频在时/高/宽三维各 8× 压缩(8×8×8),潜空间通道 C=16。架构是把图像 AE「inflate」——每个 2D 空间卷积后加 1D 时间卷积、每个空间 attention 后加 1D 时间 attention(即 2.5D,消融显示 3D 仅微弱更好但内存/算力贵得多)。图像被当作单帧视频统一编码。关键 trick:Outlier Penalty Loss(OPL)——发现标准 VAE 目标会产生高范数”latent dots”导致解码出”spot”伪影(一种 shortcut learning),加一项惩罚远离均值的潜值的损失(r=3,权重 1e5)即可消除。长视频推理用时间维 tiling(编码 tile=32 帧无重叠,解码 16 帧重叠 + 线性混合)。
- Patchify:3D 卷积,kernel/stride = 1×2×2(即 2×2 空间 patch,时间不下采样)。768px/256 帧视频经 TAE+patchify 后上下文长度约 73K token。
- 位置编码:可学习的因子化位置嵌入(分别对 h/w/t 编码后相加),支持任意尺寸/宽高比/时长;且加到所有 Transformer 层(而非只加首层),显著减少时间维的扭曲/morphing 伪影。
- 文本编码器(三路互补,拼接后投影到 6144 维):UL2(纯文本训练,强文本推理)+ Long-prompt MetaCLIP(在长 caption 上微调,token 77→256,视觉对齐)+ ByT5(字符级,仅用于编码引号内待生成的”visual text”)。
- FPS 控制:把采样 FPS 作为 token(如”FPS-16”)前置到 prompt。
- Spatial Upsampler(独立 7B 模型):把 768px 上采到 1080p HD,formulate 成 video-to-video 生成;从 1024px T2I 模型初始化,逐帧 VAE,训练用二阶 degradation 模拟(并随机替换为 TAE 伪影以减小 train-test gap);滑窗 + MultiDiffusion 保时间一致性,仅 ~20 步推理即可。
Movie Gen Audio(13B,V2A / TV2A)
- 架构:Flow Matching + DiT(注意:音频模型用 DiT 而非 LLaMa3;与视频模型不同)。36 层、attn/FFN 维度 4608/18432,13B 参数(不含 MetaCLIP/T5/DAC-VAE)。共享一个 MLP 预测 6 个调制参数(4 scale + 2 bias),只加层相关 bias,省参数。
- 音频表征:48kHz 音频经 DAC-VAE(Descript Audio Codec 去掉 RVQ、改 VAE 目标)压成 25Hz、C=128 的 1D 连续潜序列(相比 Encodec 的 75Hz/24kHz 帧率更低、采样率更高、重建更好)。
- 条件注入:视频用 Long-prompt MetaCLIP 取每帧 1024 维嵌入,逐帧相加(比时间维 concat 对齐更好);音频上下文(masked DAC-VAE 特征)沿通道维 concat 以支持 infilling/extension;文本用 T5-base(756 维,≤512 token)经 cross-attention 注入。
- 长音频生成:训练成 masked audio prediction(生成/前后扩展/中间填充统一),推理时用 multi-diffusion(三角窗加权合并,优于均匀窗)做任意长度扩展,亦提供 segment-level 自回归 + beam search 方案。
数据
视频/图像预训练
- 规模:O(100)M video-text 对 + O(1)B image-text 对。
- 视频数据 curation 三段过滤 + 一段标注(Figure 9):
- 视觉过滤(6 个过滤器):最小宽高 ≥720px;宽高比配比(初期 60% 横屏 / 40% 竖屏);OCR 去多文字;FFmpeg 场景边界检测切 4–16s 片段;训练简单视觉模型按美学/质量/大边框/特效过滤;去掉片头不稳定镜头。
- 运动过滤:静态视频检测去无运动;按 VMAF motion score + 运动向量保留”合理运动”;PySceneDetect 去抖动;去幻灯片类特效视频。
- 内容过滤:copy-detection 嵌入去重;语义聚类后按簇大小平方根倒数重采样以抑制主导概念。
- 标注(re-captioning):用微调过的 LLaMa3-Video 8B/70B 生成平均 100 词的密集 caption(70% 来自 8B、30% 来自 70B);训练一个 16 类相机运动分类器,把高置信度相机运动(zoom-out/pan-left 等)前缀到 caption 以支持相机控制。消融:视频 caption 比”逐帧图像 caption 再 rewrite”的方案被偏好 67% vs 15%,使 prompt 对齐 +10.8%(运动对齐 +10.7%)。
- 多阶段 curation:低分辨率集(≥720px)→ 高分辨率集(≥768px)→ 增补高分集(80% 横/20% 竖,≥60% 含人;用 600 个人类动作动词 taxonomy 做零样本检索保人物视频)。
- bucketization:按宽高比(5 桶)× 时长(5 桶,4–16s)分桶使同桶 latent 形状一致便于 batch(见 Table 2)。
SFT(视频)
小规模、人工精选高质量视频:自动过滤(美学/运动/场景变化阈值 + 目标检测去小主体,得几百万)→ 概念平衡(用动作 taxonomy + 视频 k-NN 取概念均衡子集)→ 人工筛”电影感”(自然/影棚打光、鲜艳不过饱和、无杂乱、非平凡运动、无抖动/叠字)→ 人工精修 caption(修正 LLaMa3-Video caption,补相机/表情/运动/打光细节)。最终时长 10.6–16s,50% 为 16s。
个性化(PT2V)数据
从预训练集筛”全程同一人”的视频:caption 选含人概念 → 每秒抽帧人脸检测,保留单人脸且相邻帧 ArcFace 余弦 >0.5 → 得 O(1)M text-video 对。分paired(参考图取自同片)与cross-paired(同人不同片,含 O(10)K 真实 + O(1)M 合成;合成用预训练个性化图生成模型造多表情/姿态/光照的参考图,ArcFace<0.7 丢弃)。cross-paired 是为打破”copy-paste”捷径(模型照搬参考图表情/头姿)。
图像后训练 / 音频数据
- 图像 quality-tuning:O(1000) 张内部艺术家创作图(仿 Emu)。
- 音频预训练:O(1)M 小时音频。按 audio type(voice/music/general sound,AED 模型 527 类 AudioSet 本体打标)× diegetic/non-diegetic(用 CAVTP 对比模型按音视频余弦相似度判别)两轴分类(Table 22);本工作聚焦 diegetic general sound、non-diegetic 音效、器乐音乐,不做语音/带词音乐。
训练方法
训练目标
- Flow Matching(Lipman 2023):线性插值/最优传输路径 Xt = t·X1 + (1−(1−σ_min)t)·X0(σ_min=1e-5),模型预测速度场 v=dXt/dt,MSE 监督;时间步 t 采样自 logit-normal(仿 SD3)。天然零终端 SNR,对噪声 schedule 鲁棒;消融对扩散(v-pred + zero-terminal-SNR)质量 +16.5%、文本对齐 +7.1%。
多阶段训练配方(Table 3,30B 模型)
- 256px T2I 预热:O(1)B 图像,bs 9216,lr 1e-4,210k iter,1.94B 样本。(直接从头训 T2I/V 收敛慢,故先低分辨率 T2I 预热以更大 batch / 更多数据。)
- 256px 联合 T2I/V:O(100)M clips,TP=4,bs 1536→3072(123k iter 后翻倍 GPU),lr 6e-5,共 185k iter / 394.8M 样本。
- 768px 联合 T2I/V(最贵阶段,73K 上下文):bs 1536→512,lr 6e-5 逐步降到 1e-5(验证 loss plateau 时降 lr),共 74.5k iter / 73.8M 样本。图像数据按 1:10 配比混入。
- 验证:维护未见视频验证集,Flow Matching 验证 loss 与人评高度相关,可作开发期代理指标。
微调与对齐
- 视频 SFT:同架构、从预训练 ckpt 初始化,小 batch / 64 节点(512 H100)、cosine lr;16s 视频用 16FPS、10.6–16s 用 24FPS。Model Averaging:仿 LLaMa3,平均多组 SFT(不同数据/超参/预训练 ckpt)的模型权重。SFT 对预训练净胜:总体 +34.65%、运动自然度 +18.38%、文本对齐 +10.5%。
- 未用 RLHF/DPO/reward model——视频侧的”偏好对齐”主要靠高质量 SFT 数据 + 人评筛选 + 模型平均,而非显式 RL。
- 个性化 PT2V 三阶段:Stage-I 身份注入(截断到 8 latent 帧/64 RGB 帧的短视频加速身份学习,冻结 vision encoder 只训 backbone)→ Stage-II 恢复长视频能力(加大 latent 帧数)→ Stage-III 改善自然度(用 cross-paired 数据 + 微调 vision encoder 破除 copy-paste)。共 30k iter / 15.36M 视频。
- 视频编辑 Movie Gen Edit(无监督,三阶段):核心是无任何监督视频编辑数据也能训。架构上加输入视频通道(latent 沿通道 concat)+ 仿 Emu Edit 的 task embedding,新增权重零初始化。Stage-I 单帧编辑(把图像编辑当单帧视频,与 T2V 生成多任务交替,图像编辑 batch 采样频率 ×5)→ Stage-II 多帧编辑(两个合成任务:随机仿射动画化图像编辑对 + 把视频分割当成”用特定颜色标记物体”的编辑)→ Stage-III 视频编辑 backtranslation(在多帧高质量输出视频上训练)。消融显示全模型多任务训练优于 ControlNet adapter。
加速与推理优化
- Linear-Quadratic t-schedule(无需额外训练):前 25 步沿 N 步线性 schedule,后 25 步用二次间隔近似剩余步——论文最优配置是50 步逼近 250 步线性结果(L 形曲线观察基于 1000 步参考),整体最多 ~20× 加速(论文原话 “up to ∼20× speed up”)。依据是 flow 早期步对场景/运动起决定作用(Transformer block 输入输出变化呈 L 形曲线)。推理用一阶 Euler 解(优于 midpoint/Dopri5),CFG=7.5。
- Inference Prompt Rewrite:用 LLaMa3 把短用户 prompt 改写成训练 caption 风格的密集描述;为降延迟,70B 当 teacher 经 HITL 蒸馏到 8B 学生模型。
- 音频训练:预训练 eff. batch 1536、500K 更新、384 GPU × 14 天;微调 256 batch、50K 更新、64 GPU × 1 天,AdamW(wd=0.1) + bf16 + EMA(0.999)。推理用 midpoint 64 步、CFG=3、8 候选重排。
Infra(训练 / 推理工程)
- 算力:最多 6,144 张 H100(700W TDP,80GB HBM3),Meta Grand Teton 平台;节点内 8 卡 NVSwitch 全连,跨节点 400Gbps RoCE RDMA;MAST 全局调度。
- 并行(3D parallelism):FSDP + 张量并行(TP)+ 序列并行(SP)+ 上下文并行(CP)组合。最贵的 768px/73K 上下文阶段,不同组件用不同切分:文本编码器(ByT5/MetaCLIP 复制、UL2 仅 FSDP),TAE 因激活巨大预计算并缓存高分潜变量,backbone 各段分别 FSDP / FSDP+TP / FSDP+TP+SP / FSDP+TP+SP+CP(self-attn 用满所有维度)。
- 与 LLM 的差异:因用全双向注意力,无法享受 LLM 因果掩码的 ~2× 加速;因非自回归且未用 GQA(留作 future work),CP 通信的 K/V 张量比 LLaMa3(用 GQA,K/V 小 8×)更大,CP 扩展特性不同。
- 自研并行实现:基于 TP/SP/CP 原理手写 backbone block 前后向,PyTorch 编译成 CUDAGraph,支持变长输入,achieve 接近 strong-scaling 的激活内存与步时;建解析框架建模计算/通信时间、识别重复激活与暴露通信,自动生成并选择 sharding plan(找”batch-size 对步时近中性”的方案以独立扩展优化步数)。
- 推理:视频侧靠 linear-quadratic schedule(50 步)+ MultiDiffusion 上采样(~20 步)。论文未给出具体端到端生成延迟/GPU·秒数字(标注为未报告)。
评测 benchmark(把效果讲清楚)
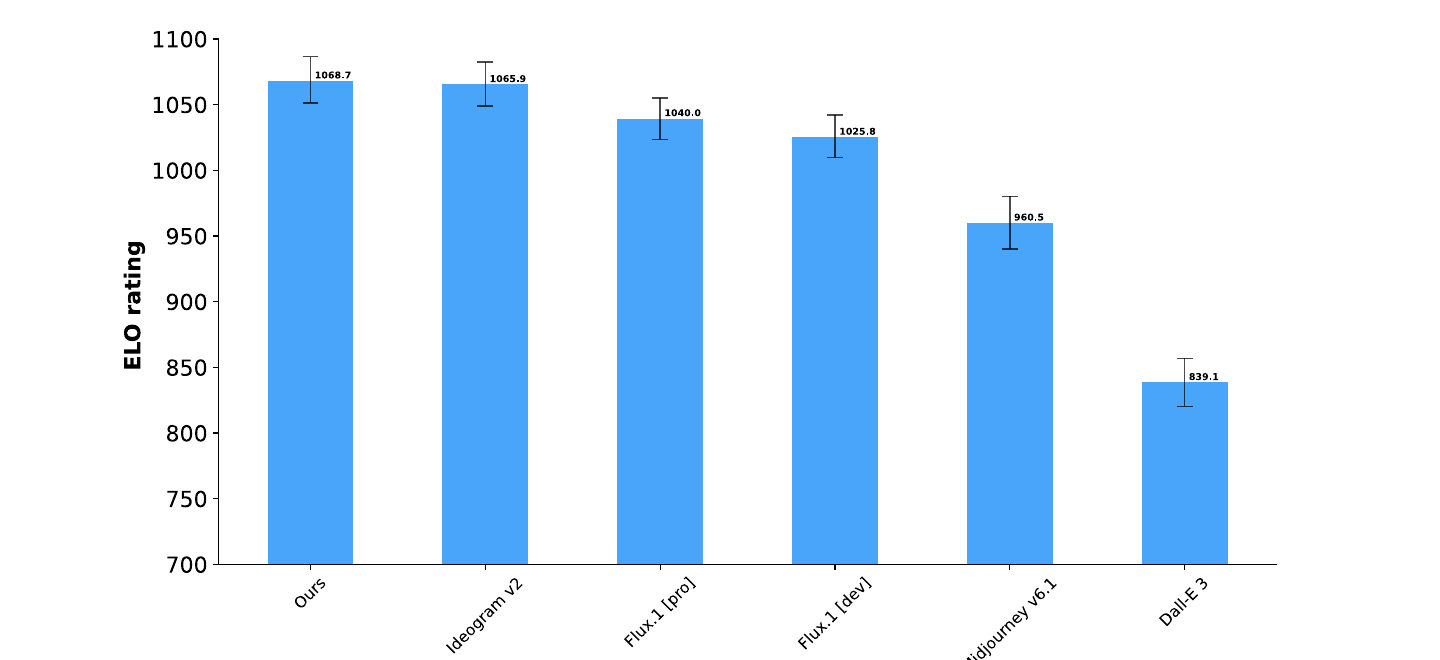
图源:Movie Gen: A Cast of Media Foundation Models(Meta, 2024)Figure 18「ELO rating comparison of text-to-image methods」https://ai.meta.com/static-resource/movie-gen-research-paper
Meta 明确论证 FVD/IS/CLIP 等自动指标与视频人评不相关,主线用人评 A/B 净胜率(net win rate = win%−loss%,范围 [−100,100]),并自建 Movie Gen Video Bench(1000 prompt,3× 于前作)。
文生视频(Movie Gen Video vs 同期,Table 6,净胜率)
| 对手 | 总体质量 | 帧一致性 | 运动自然度 | 运动完整度 | 文本对齐 | 真实感 | 美学 |
|---|---|---|---|---|---|---|---|
| Runway Gen3 | +35.02 | +33.1 | +19.27 | −1.72 | +10.45 | +48.49 | +38.55 |
| LumaLabs | +60.58 | +42.14 | +29.33 | +23.59 | +12.23 | +61.83 | +48.19 |
| OpenAI Sora | +8.23 | +8.22 | +4.43 | +8.86 | +17.72 | +11.62 | +6.45 |
| Kling1.5 | +3.87(持平) | +13.5 | +0.52 | −10.04 | −1.99 | +37.09 | +26.88 |
结论:对 Runway/Luma 全面显著领先(>2σ);对 Sora 总体中等净胜(1–2σ)、真实感显著胜;与 Kling1.5 总体持平但帧一致性显著胜、运动完整度输(论文解读为 Kling 倾向生成”大但带扭曲”的运动)。
文生图(ELO,Table/Figure 18)
Movie Gen 图像在 Flux.1 / DALL-E 3 / Midjourney V6.1 / Ideogram V2 中取得最高 ELO(基于人评 win/tie/lose 转 battle record)。
TAE 重建(Table 10,512px)
- 视频:TAE 在 8× 时间压缩下与逐帧 AE 相当——SSIM 0.9093 / PSNR 32.25 / FID 1.49(逐帧 AE 0.9348 / 34.11 / 0.94)。
- 图像:TAE 优于逐帧 AE——SSIM 0.9231 / PSNR 32.16 / FID 0.287(vs 0.8877 / 30.83 / 1.76),得益于 C=16 通道。
- OPL 微调使图/视频 SSIM/PSNR/FID 均改善(Table 12)。
个性化 PT2V(Table 13/15)
- 身份保持显著碾压 ID-Animator:Identity-best 65.5%(finetune)/ 71.9%(pretrain) vs 3.69%;Face Consistency 95.6% vs 79.7%。
- 视频质量/文本对齐对 ID-Animator 净胜:总体 +64.74、文本对齐 +53.20。
- 消融:可训练 vision encoder 比冻结的身份保持 +16%;cross-paired 训练虽降身份相似度但运动自然度 +26.14、文本对齐 +27.36。
视频编辑 Movie Gen Edit(Table 17)
- TGVE+ 上对前 SOTA EVE 在 Overall 人评胜率 74%;ViCLIP_dir 取得 SOTA(0.225)。
- Movie Gen Edit Bench 上对 SDEdit、Runway Gen3 V2V 均显著被偏好(如对 SDEdit Overall 91.96 胜率)。
音频 Movie Gen Audio(人评净胜,6.4 节)
- 音效生成对全部 6 个 baseline(Diff-Foley/FoleyCraft/VTA-LDM/Seeing&Hearing/PikaLabs/ElevenLabs)大幅领先:同步性 +33.8%
+70.4%、正确性 +27.5%+82.2%、生成视频上总体质量 +31.3%~+82.1%。在”professionalness”上比”naturalness”赢更多(学到专业制作音)。自动指标用 ImageBind(IB)score 测音视频对齐、CLAP score 测文本对齐;明确不采用 FAD/KLD(理由见 3781 行附近,认为不可靠)。
关键消融汇总(Table 8)
| 设计决策 | 总体质量净胜 | 文本对齐净胜 |
|---|---|---|
| Flow Matching vs 扩散 | +16.53 | +7.08 |
| 视频 caption vs 图像 caption | +0.80 | +10.80 |
| LLaMa3-like vs DiT | +18.63 | +12.60 |
创新点与影响
核心贡献
- 把视频生成骨干从 DiT 换成 LLaMa3 架构并实证其更优、更易规模化——为”用 LLM 栈做媒体生成”提供了强证据,打通了 LLM 的并行/scaling 经验到生成模型。
- Flow Matching 作为视频生成主目标的大规模验证(30B / 73K 上下文),论证其相对扩散的简洁性与鲁棒性。
- 8× 三维压缩的 TAE + OPL:取消帧插值,并定位/修复了潜空间”high-norm dot→spot 伪影”这一 shortcut learning 问题。
- 无监督视频编辑配方(单帧→合成多帧→backtranslation 三阶段),绕开监督视频编辑数据稀缺。
- Linear-Quadratic 推理 schedule:~20× 免训练加速。
- 个性化的 cross-paired 数据思路破除 copy-paste 捷径。
- Movie Gen Audio:DAC-VAE 连续潜 + 逐帧视频特征相加 + multi-diffusion 任意长度扩展,做出能区分 diegetic/non-diegetic、能配非画内音乐的”电影感”配音模型。
- 配套评测基建:Movie Gen Video Bench / Edit Bench / Audio Bench + 承诺释放非 cherry-pick 生成结果,推动可复现的人评对比。
影响:作为 Sora 之后体量最大的开放技术报告之一,Movie Gen 把视频生成的训练/数据/infra 细节公开到工业级颗粒度,深刻影响后续开源视频模型(如对 LLM 风格 backbone、Flow Matching、3D 并行、re-captioning 配方的采纳)。
已知局限(论文自述):复杂几何/物体操控/物理状态转换仍有伪影;密集/小目标/遮挡动作(踏舞、脚步、吉他和弦)的音视频同步差;不支持语音生成(设计选择);视频与音频分开训练,未做联合多模态生成;研究仅限英文文本输入;自动指标不可靠故重度依赖人评(有标注偏差);未公开端到端推理延迟。
原始链接
- blog(官方博客,一等公民): https://ai.meta.com/blog/movie-gen-media-foundation-models-generative-ai-video/
- research page(项目页): https://ai.meta.com/research/movie-gen/
- paper PDF(92 页技术报告): https://ai.meta.com/static-resource/movie-gen-research-paper
- 视频示例: https://go.fb.me/MovieGenResearchVideos
一手源存档(sources/)
- movie-gen.pdf (官方 92 页技术报告 PDF,gitignore,仅本地) (PDF 不入 git,走 HF bucket)
- movie-gen.txt (pdftotext 全文,仅本地)
- blog.md (官方博客 cloakbrowser 快照,入 git)
- research.md (research 项目页快照,入 git)