一句话定位
MeanFlow 提出用”平均速度场”(average velocity)替代 Flow Matching 的”瞬时速度场”,从平均速度的定义直接推出一条不依赖神经网络的恒等式(MeanFlow Identity),把它当作训练目标,从而从零训练出一个**单步(1-NFE)**生成模型——无需预训练、无需蒸馏、无需课程(curriculum)。在 ImageNet 256×256 上单步生成达到 FID 3.43(XL/2,676M),相对此前单步 SOTA(Shortcut 10.60、IMM 7.77)有 50%–70% 的相对提升,几乎抹平单步与多步扩散/流模型的差距。
背景与定位
- 生成建模目标是把先验分布搬运成数据分布。flow-matching / rectified-flow 通过学习连接两分布的速度场来构造流路径,与 ddpm / 分数模型同源,但其采样本质是迭代解 ODE(probability flow ODE),需要多步函数评估(NFE)。
- 即使把”条件流”设计成直线(rectified),边际速度场(marginal velocity,对所有 (x, ε) 配对取期望)通常仍是弯曲轨迹;用粗离散的数值 ODE 求解器在弯曲轨迹上会产生误差——这是 few-step / one-step 的根本难点,且这种”非直”不仅是网络逼近误差,而是底层 ground-truth 场本身就弯。
- 此前的单步/少步路线主要两类:
- 蒸馏类(progressive distillation、ADD、分数蒸馏 DMD/SiD 等)——依赖一个预训练多步教师;
- 一致性类(consistency-models iCT/ECT/sCT、Shortcut、IMM)——把”一致性约束”强加在网络行为上,但底层真值场该满足什么性质并不清楚,导致训练不稳,需要精心设计的”离散化课程”逐步收紧时间域。
- MeanFlow 的定位:给单步生成一个原理性框架(principled)——核心约束来自平均速度的定义本身,而非对网络强加的启发式一致性。这条恒等式 u 必然满足,不依赖网络引入,因此最优解原则上与具体网络无关,训练更稳。论文明确把自己放在”重审扩散/流模型基础”的位置。
模型架构
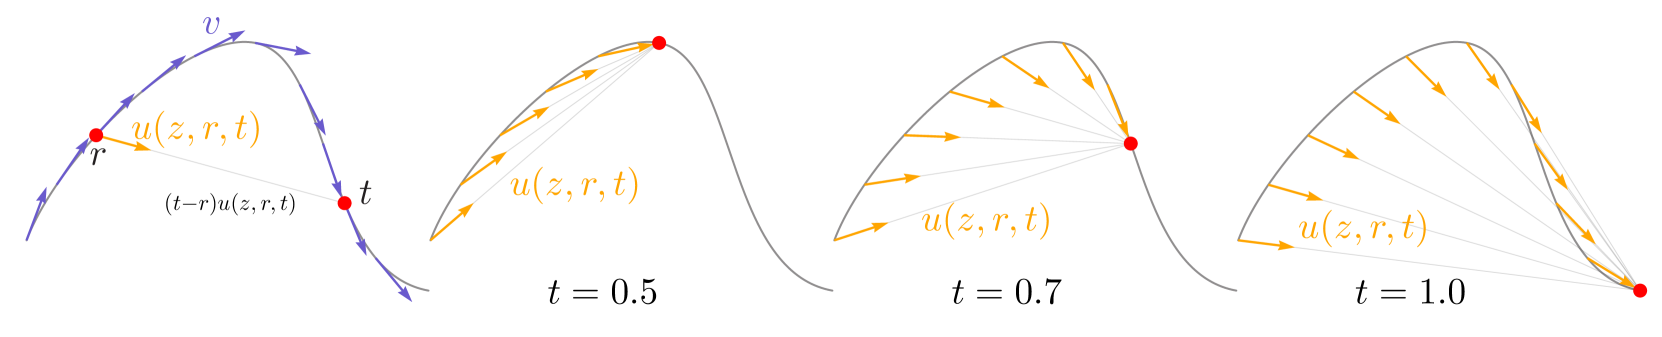
图源:MeanFlow: Mean Flows for One-step Generative Modeling, Figure 3(平均速度场 u(z,r,t) 示意),https://arxiv.org/abs/2505.13447
- Backbone:直接沿用 dit-scalable-diffusion-transformers(Diffusion Transformer)结构,基于 ViT + adaLN-Zero 做条件注入,DiT block 原封不动(架构改进与本方法正交,留作未来工作)。
- 潜空间(latent):在预训练 VAE tokenizer 的潜空间上建模(256×256 图像 → 32×32×4 latent 作为输入);VAE 用
sd-vae-ft-mse-flax(HF: pcuenq/sd-vae-ft-mse-flax)。CIFAR-10 则直接在 32×32×3 像素空间用 ~55M U-Net(源自 Song & Ermon 的网络),无 EDM preconditioner。 - 双时间条件:与 Flow Matching 只条件于单个 t 不同,MeanFlow 的场 u(z, r, t) 同时依赖两个时间变量 r(终点时刻,采样目标)和 t(当前时刻)。对每个时间变量做 positional embedding → 2 层 MLP → 相加,作为条件。消融发现条件于 (t, t−r)(时间 + 间隔)效果最好,(r, t) 几乎一样好,甚至只给间隔 t−r 也能出合理结果。
- 无 preconditioner:CIFAR-10 上不用 EDM 风格的 preconditioner,仍具竞争力。
- 模型尺寸/分辨率策略(附录 Table 4):
- B/4(消融用):131M,5.6 GFLOPs,depth 12,hidden 768,12 heads,patch 4×4。
- B/2:131M,23.1 GFLOPs,patch 2×2。
- M/2:depth 16,hidden 1024,16 heads,54.0 GFLOPs。注:论文自相矛盾——配置表 Table 4 列 params 497.8M,而对比表 Table 2 列 308M;下方主结果表沿用 Table 2 的 308M。
- L/2:459M,119.0 GFLOPs,depth 24,hidden 1024,16 heads。
- XL/2:676M,119.0 GFLOPs,depth 28,hidden 1152,16 heads。
- 主结果均为 patch=2 的 /2 系列;/4 仅用于 80-epoch 快速消融。
数据
- 数据集:ImageNet(class-conditional 256×256)为主实验;CIFAR-10(32×32,class-unconditional)为辅。两者均为标准公开数据集,无私有/合成数据、无 re-captioning——本质是生成方法论工作,不涉及大规模数据工程。
- 预处理:ImageNet 图像先用 VAE 编码为 32×32×4 latent 后再训练(README 的
prepare_data.sh即做 latent 预计算并存盘)。CIFAR-10 数据增强沿用 EDM 设置,但禁用垂直翻转与旋转。 - 数据规模/配比/美学过滤/安全过滤:不适用 / 未涉及(标准 benchmark 数据集,无额外配比或过滤策略)。
训练方法
这是本文的核心,分几层讲清楚:
1. 平均速度的定义 瞬时速度 v 是 Flow Matching 的建模对象;MeanFlow 改为建模平均速度 u(z_t, r, t) ≜ (1/(t−r)) ∫_r^t v(z_τ, τ) dτ,即两时刻间位移除以时间间隔。位移 = (t−r)·u。u 是由 v 诱导的场(u = F[v]),不依赖任何网络。它天然满足边界条件 lim_{r→t} u = v,以及”可加性一致性”:一大步 [r,t] 等于两小步 [r,s]+[s,t],无需显式约束。
2. MeanFlow Identity(训练目标的来源) 直接对定义式 (t−r)u = ∫_r^t v dτ 两边关于 t 求导(把 r 当作与 t 无关),用乘积法则 + 微积分基本定理,得到恒等式:
u(z_t, r, t) = v(z_t, t) − (t−r)·(d/dt)u(z_t, r, t)
其中时间总导数 d/dt u 用链式法则展开为 d/dt u = v·∂_z u + ∂_t u(因为 dz/dt=v,dr/dt=0,dt/dt=1)。这正好是 Jacobian-vector product (JVP):Jacobian [∂_z u, ∂_r u, ∂_t u] 与切向量 [v, 0, 1] 的乘积,可用 torch.func.jvp / jax.jvp 一次反向高效算出。
3. 损失函数 参数化网络 u_θ,最小化 L(θ) = E‖u_θ(z_t, r, t) − sg(u_tgt)‖²,其中目标 u_tgt = v_t − (t−r)·(v_t·∂_z u_θ + ∂_t u_θ)。
- v_t 用条件速度(默认 v_t = ε − x,schedule a_t=1−t, b_t=t)替代不可计算的边际速度,沿用 Flow Matching 做法。
- stop-gradient (sg) 加在目标上:避免对 JVP 做”二次反传”(double backprop),从而不引入高阶优化。若 u_θ 真达到零损失,则它满足 MeanFlow Identity,进而满足原始积分定义(附录 B.3 证明恒等式既是必要也是充分条件——关键在于建模 u 而非直接建模位移 S,自动满足 S|_{t=r}=0 边界条件)。
- 与 Flow Matching 的关系:整套方法等价于”带修正目标的 Flow Matching”——目标只多了 −(t−r)(v_t∂_z u_θ + ∂_t u_θ) 这一项;若强制 t=r,该项消失,退化为标准 Flow Matching。
4. 训练即一阶段、从零、自洽 无预训练、无蒸馏、无课程。训练流程(Alg.1):采样 (t,r) → z=(1−t)x+t·ε → v=ε−x → (u,dudt)=jvp(fn,(z,r,t),(v,0,1)) → u_tgt=v−(t−r)·dudt → 回归。采样(Alg.2)单步即 x = ε − u_θ(ε, r=0, t=1)。
5. 把 CFG 烘焙进真值场(关键工程亮点) 不在采样时朴素施加 CFG(那会把 NFE 翻倍),而是把 CFG 当作底层真值场的属性:构造 v_cfg = ω·v(·|c) + (1−ω)·v(·),并定义其对应平均速度 u_cfg,直接用网络 u_cfg_θ 建模。利用 v(z_t,t)=v_cfg(z_t,t) 与 v_cfg(z_t,t)=u_cfg(z_t,t,t) 两条关系,把目标里的修正速度写成 ṽ_t = ω·v_t + (1−ω)·u_cfg_θ(z_t,t,t)。采样时无需线性组合,单 NFE 即享 CFG 收益。附录 B.1 进一步引入混合系数 κ(improved CFG),让 class-conditional 与 class-unconditional 的 u_cfg 同时进入目标,等效引导尺度 ω’=ω/(1−κ),类条件以 10% 概率随机丢弃。
6. 关键设计与超参(消融结论,见下节)
- r≠t 比例:25% 最优(0% 即纯 Flow Matching,1-NFE 完全崩,FID 328.91)。
- 时间采样器:logit-normal 优于 uniform(与 SD3 等观察一致),主实验 lognorm(−0.4, 1.0)。
- 损失度量:自适应加权 w = 1/(‖∆‖²+c)^p,p=1 最优,p=0.5 ≈ Pseudo-Huber 次优,p=0(纯 L2)最差但仍可用。
- 优化器:Adam (β=0.9,0.95 for ImageNet / 0.9,0.999 for CIFAR),constant lr=1e-4(CIFAR 6e-4),weight decay 0,EMA 0.9999(CIFAR 0.99995),batch 256(CIFAR 1024),dropout 0(ImageNet)/ 0.2(CIFAR,附录 A)。主结果训练 240 epochs,消融 80 epochs(400K iters)。CIFAR 另用 800K iters(10K warm-up)、r≠t 比例 75%、p=0.75、sampler lognorm(−2.0, 2.0)(与 ImageNet 主配置不同)。
Infra(训练 / 推理工程)
- 硬件/框架:官方实现是 JAX,跑在 TPU 上(致谢 Google TPU Research Cloud)。后续社区/官方补了 PyTorch(py-meanflow,CIFAR-10)与 JAX+GPU sanity check。
- JVP 开销极小(核心工程论点):因为 JVP 结果被 stop-grad 当常数,θ-反传不受影响;额外成本只是 JVP 自身的一次反向(且只反传到输入、不到参数 θ,比标准反传更便宜)。在 B/4 + TPU v4-8 上实测:Flow Matching 0.045 sec/iter,MeanFlow 0.052 sec/iter,仅 ~16% wall-clock 开销(论文正文称 <20%)。
- 推理形态:1-NFE——一次前向 x = ε − u_θ(ε, 0, 1) 即出图;2-NFE 也直接支持(无需课程)。无需缓存、无需步数蒸馏、无需量化即达 SOTA,这是相对蒸馏类方法的部署优势。
- 绝对算力规模/GPU·时:未报告精确卡时;论文用 Fig.1 的训练 compute(GFLOPs,对数轴)做缩放对比,但未给总 GPU 小时数。
评测 benchmark(把效果讲清楚)
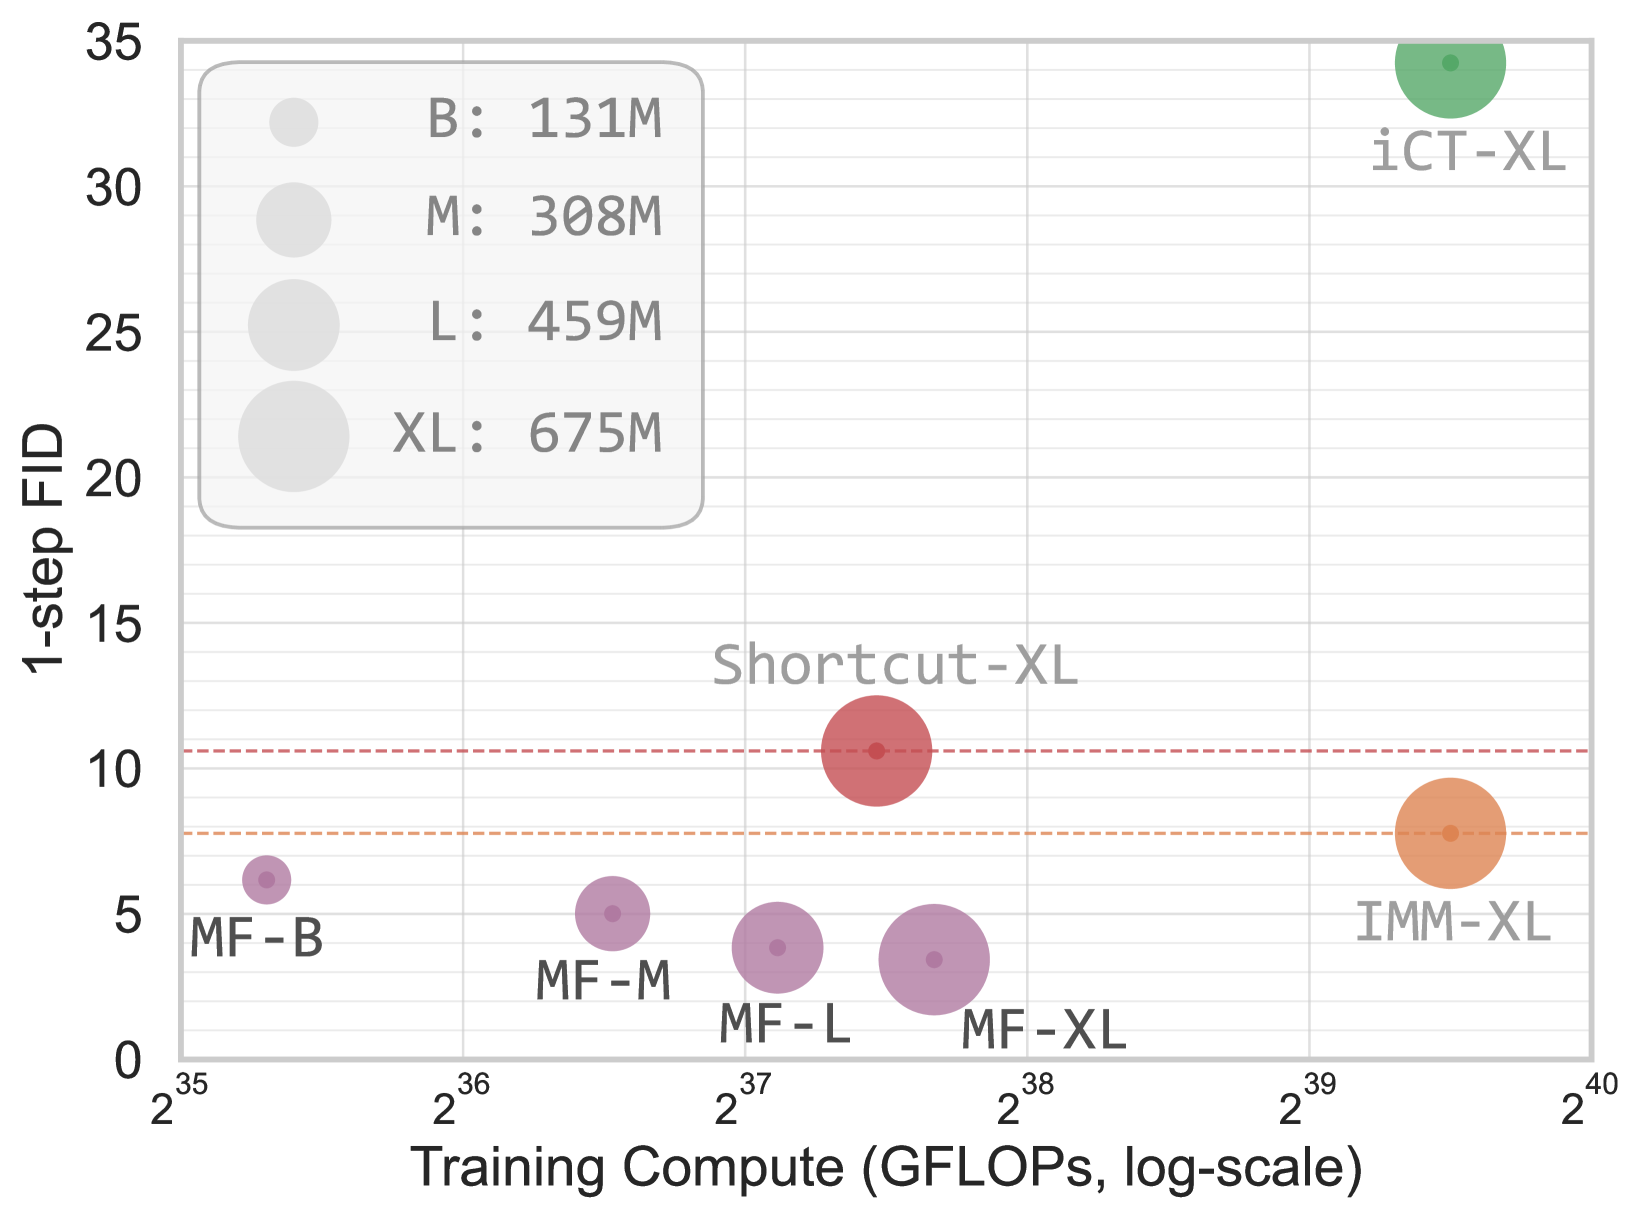
图源:MeanFlow: Mean Flows for One-step Generative Modeling, Figure 1(ImageNet 256 1-step FID vs 训练 compute 缩放对比:MF-B/M/L/XL 全面优于 iCT-XL / Shortcut-XL / IMM-XL),https://arxiv.org/abs/2505.13447
所有 FID 为 FID-50K,数字均出自已抓取的论文一手源(Table 1/2/3/4/5、Fig.1/4 与 README)。
ImageNet 256×256,1-NFE(从零训练,含 CFG)—— 主结果(Table 2 左 / Fig.4)
| 模型 | 参数 | NFE | FID |
|---|---|---|---|
| iCT-XL/2 | 675M | 1 | 34.24 |
| Shortcut-XL/2 | 675M | 1 | 10.60 |
| MeanFlow-B/2 | 131M | 1 | 6.17 |
| MeanFlow-M/2 | 308M | 1 | 5.01 |
| MeanFlow-L/2 | 459M | 1 | 3.84 |
| MeanFlow-XL/2 | 676M | 1 | 3.43 |
- 对比同类单步:相对 IMM 单步 7.77 提升 >50%;只比 1-NFE(非 1-step)则相对前 SOTA Shortcut 10.60 提升近 70%。
- 缩放性(Fig.4):随模型增大与训练时长,1-NFE FID 单调改善(B/2 6.17 → XL/2 3.43),与 DiT/SiT 的缩放趋势一致。
ImageNet 256×256,2-NFE(Table 2 左下)
- MeanFlow-XL/2:FID 2.93;MeanFlow-XL/2+(更长训练 + 长训配置):FID 2.20。
- 对照多步基线(同 XL/2 backbone、250×2 NFE):DiT-XL/2 2.27、SiT-XL/2 2.06/2.15。即 2-NFE 的 MeanFlow 已与 250×2 步的多步模型同档。
参考系(Table 2 右,其它生成范式):BigGAN 6.95 / GigaGAN 3.45 / StyleGAN-XL 2.30(1-NFE GAN);VAR-d30 1.92、MAR-H 1.55(AR/masking,多步);ADM 10.94、LDM-4-G 3.60、DiT-XL/2 2.27、SiT-XL/2 2.06、SiT+REPA 1.42(多步扩散/流,均 250×2)。REPA 等正交改进可叠加,论文留作未来工作。
消融(Table 1,B/4 backbone,80 epoch,1-NFE FID)
| 维度 | 关键结论 |
|---|---|
| r≠t 比例 (1a) | 0%→328.91(崩);25%→61.06(最优);50%→63.14;100%→67.32 |
| JVP 切向量 (1b) | 仅正确切向量 (v,0,1)→61.06;(v,0,0)→268.06、(v,1,0)→329.22、(v,1,1)→137.96(错误 JVP 全崩,证明 JVP 是连接所有 (r,t) 的核心机制) |
| (r,t) 条件形式 (1c) | (t,t−r)→61.06 最优;(t,r)→61.75;只 t−r→63.13 仍可用 |
| 时间采样器 (1d) | lognorm(−0.4,1.0)→61.06 最优;uniform→65.90 |
| 损失度量 p (1e) | p=1→61.06 最优;p=0.5→63.98;p=0(L2)→79.75 |
| CFG 尺度 ω (1f) | ω=1→61.06;ω=2→20.15;ω=3→15.53;ω=5→20.75 |
| improved CFG κ (Table 5,固定 ω’=2.0) | κ=0→20.15;κ=0.9→18.63(混入 class-cond 进一步提升) |
CIFAR-10,1-NFE 无条件(Table 3):MeanFlow(无 preconditioner)FID 2.92,与 iCT 2.83、sCT 2.97、IMM 3.20、ECT 3.60 竞争力相当——且 MeanFlow 不用 EDM preconditioner。
README 复现核对:MF-B/4 sanity checkpoint 期望 FID 11.4;guidance_eq=cfg(ω=1.0,κ=0.5) @240ep 复现 11.35(对应 Table 5),“paper/repo” 数字基本吻合。
创新点与影响
核心贡献
- 概念创新:把建模对象从瞬时速度换成平均速度,并从其定义直接推出 MeanFlow Identity——一条不依赖网络、必然成立的恒等式,作为原理性训练目标,替代以往强加在网络行为上的启发式一致性约束。
- 工程可训性:用 JVP + stop-gradient 把含积分/时间导数的目标变成一次廉价反向(~16% 开销),单阶段、从零、无蒸馏/无课程即可训练。
- CFG 内化:把 classifier-free guidance 烘焙进真值场,保持严格 1-NFE 采样仍享 CFG 收益(improved CFG κ 进一步提升)。
- 结果:ImageNet 256 单步 FID 3.43,2-NFE 2.20,把单步与多步的差距压到几乎可忽略。
影响
- 作为 flow-matching / consistency-models / shortcut-models / inductive-moment-matching 之后的”统一而更简洁”的单步生成框架,迅速成为 2025 单步生成的重要基线与起点。
- 衍生快:官方 README 已记录 improved MeanFlow (iMF, arXiv 2512.02012) 与 pixel MeanFlow (pMF, arXiv 2601.22158,端到端像素空间);社区出现多份第三方 PyTorch 复现(zhuyu-cs、HaoyiZhu、noamelata 等,含 ImageNet 复现)。
- 与 REPA 等表征对齐改进正交,可叠加;论文把单步生成与物理多尺度模拟做了类比,提出连接生成建模、模拟与动力系统的研究愿景。
已知局限
- 主要在 ImageNet/CIFAR 的 class-conditional/unconditional 标准 benchmark 上验证,未涉及 text-to-image / 大规模文本条件 / 视频等更复杂多模态场景。
- 需要 JVP 支持(torch.func.jvp / jax.jvp),对部分自定义算子/框架有实现门槛。
- 绝对训练算力(GPU·时)未披露;2.20 的最优数字依赖”XL/2+ 更长训练 + 专门长训配置”。
- r≠t 比例、时间采样器、损失 p 等超参对结果敏感(消融可见 FID 跨度很大),需调参。
原始链接
- arxiv_abs: https://arxiv.org/abs/2505.13447
- arxiv_pdf: https://arxiv.org/pdf/2505.13447
- arxiv_html: https://arxiv.org/html/2505.13447v1
- github (官方 JAX/TPU): https://github.com/Gsunshine/meanflow
- github (官方 PyTorch/CIFAR): https://github.com/Gsunshine/py-meanflow
- 衍生 iMF: https://arxiv.org/abs/2512.02012 ・ https://github.com/Lyy-iiis/imeanflow
- 衍生 pMF: https://arxiv.org/abs/2601.22158 ・ https://github.com/Lyy-iiis/pMF
一手源存档(sources/)
- arxiv-2505.13447.pdf (arXiv 原文 PDF,不入 git)
- arxiv-2505.13447.txt(PDF 文本抽取)
- readme.md(官方 JAX 仓库 README)
- github-readme.md(同上,jsDelivr 镜像抓取)