一句话定位
Emu3 是 BAAI 用纯 next-token 预测从头训练的 8B 单一 Transformer:把图像、文本、视频全部离散化成 token,在一个自回归解码器里统一生成与理解、统一图/文/视频——不用扩散、不用 CLIP、不用外接预训练 LLM/文本编码器。在图像生成(人评、GenEval、T2I-CompBench、DPG-Bench)上超过 SDXL、对标 DALL-E 3 / MJ-v5.2;视觉理解对标 LLaVA-1.6-7B;视频生成 VBench 总分 80.96(自回归唯一选手)超过多数开源扩散模型。
背景与定位
2024 年的多模态版图是”分裂”的:视觉生成被扩散模型(latent-diffusion-ldm、sdxl、stable-diffusion-3 等)统治,视觉理解被”CLIP 视觉编码器 + LLM”的组合式方案(LLaVA 系列)统治。即便是早期统一尝试也是”打补丁”:Emu/Emu2 把 LLM 接到外部扩散模型上回归视觉 embedding,Chameleon/CM3Leon 虽然是 token-based 自回归但生成质量打不过 task-specific 模型,Transfusion/Show-o 又把扩散和自回归缝合在一起。
Emu3 的论点很激进——“Next-Token Prediction is All You Need”:只要把所有模态都变成离散 token,一个标准的 LLM 式自回归 Transformer 从头训练,就能在生成和理解两端同时打过专用模型,彻底去掉扩散与组合式架构。它是 BAAI “Emu 系列”的代表作,也是 2024 年”全离散 token 统一多模态”路线(对照 Chameleon、janus/janus-pro、show-o、transfusion)中第一个在多个一线生成/理解 benchmark 上同时达到或超过 SOTA 的工作。其最有价值的开源贡献之一是放出了一个同时能 tokenize 图像与视频的视觉分词器(此前公开缺失)。
模型架构
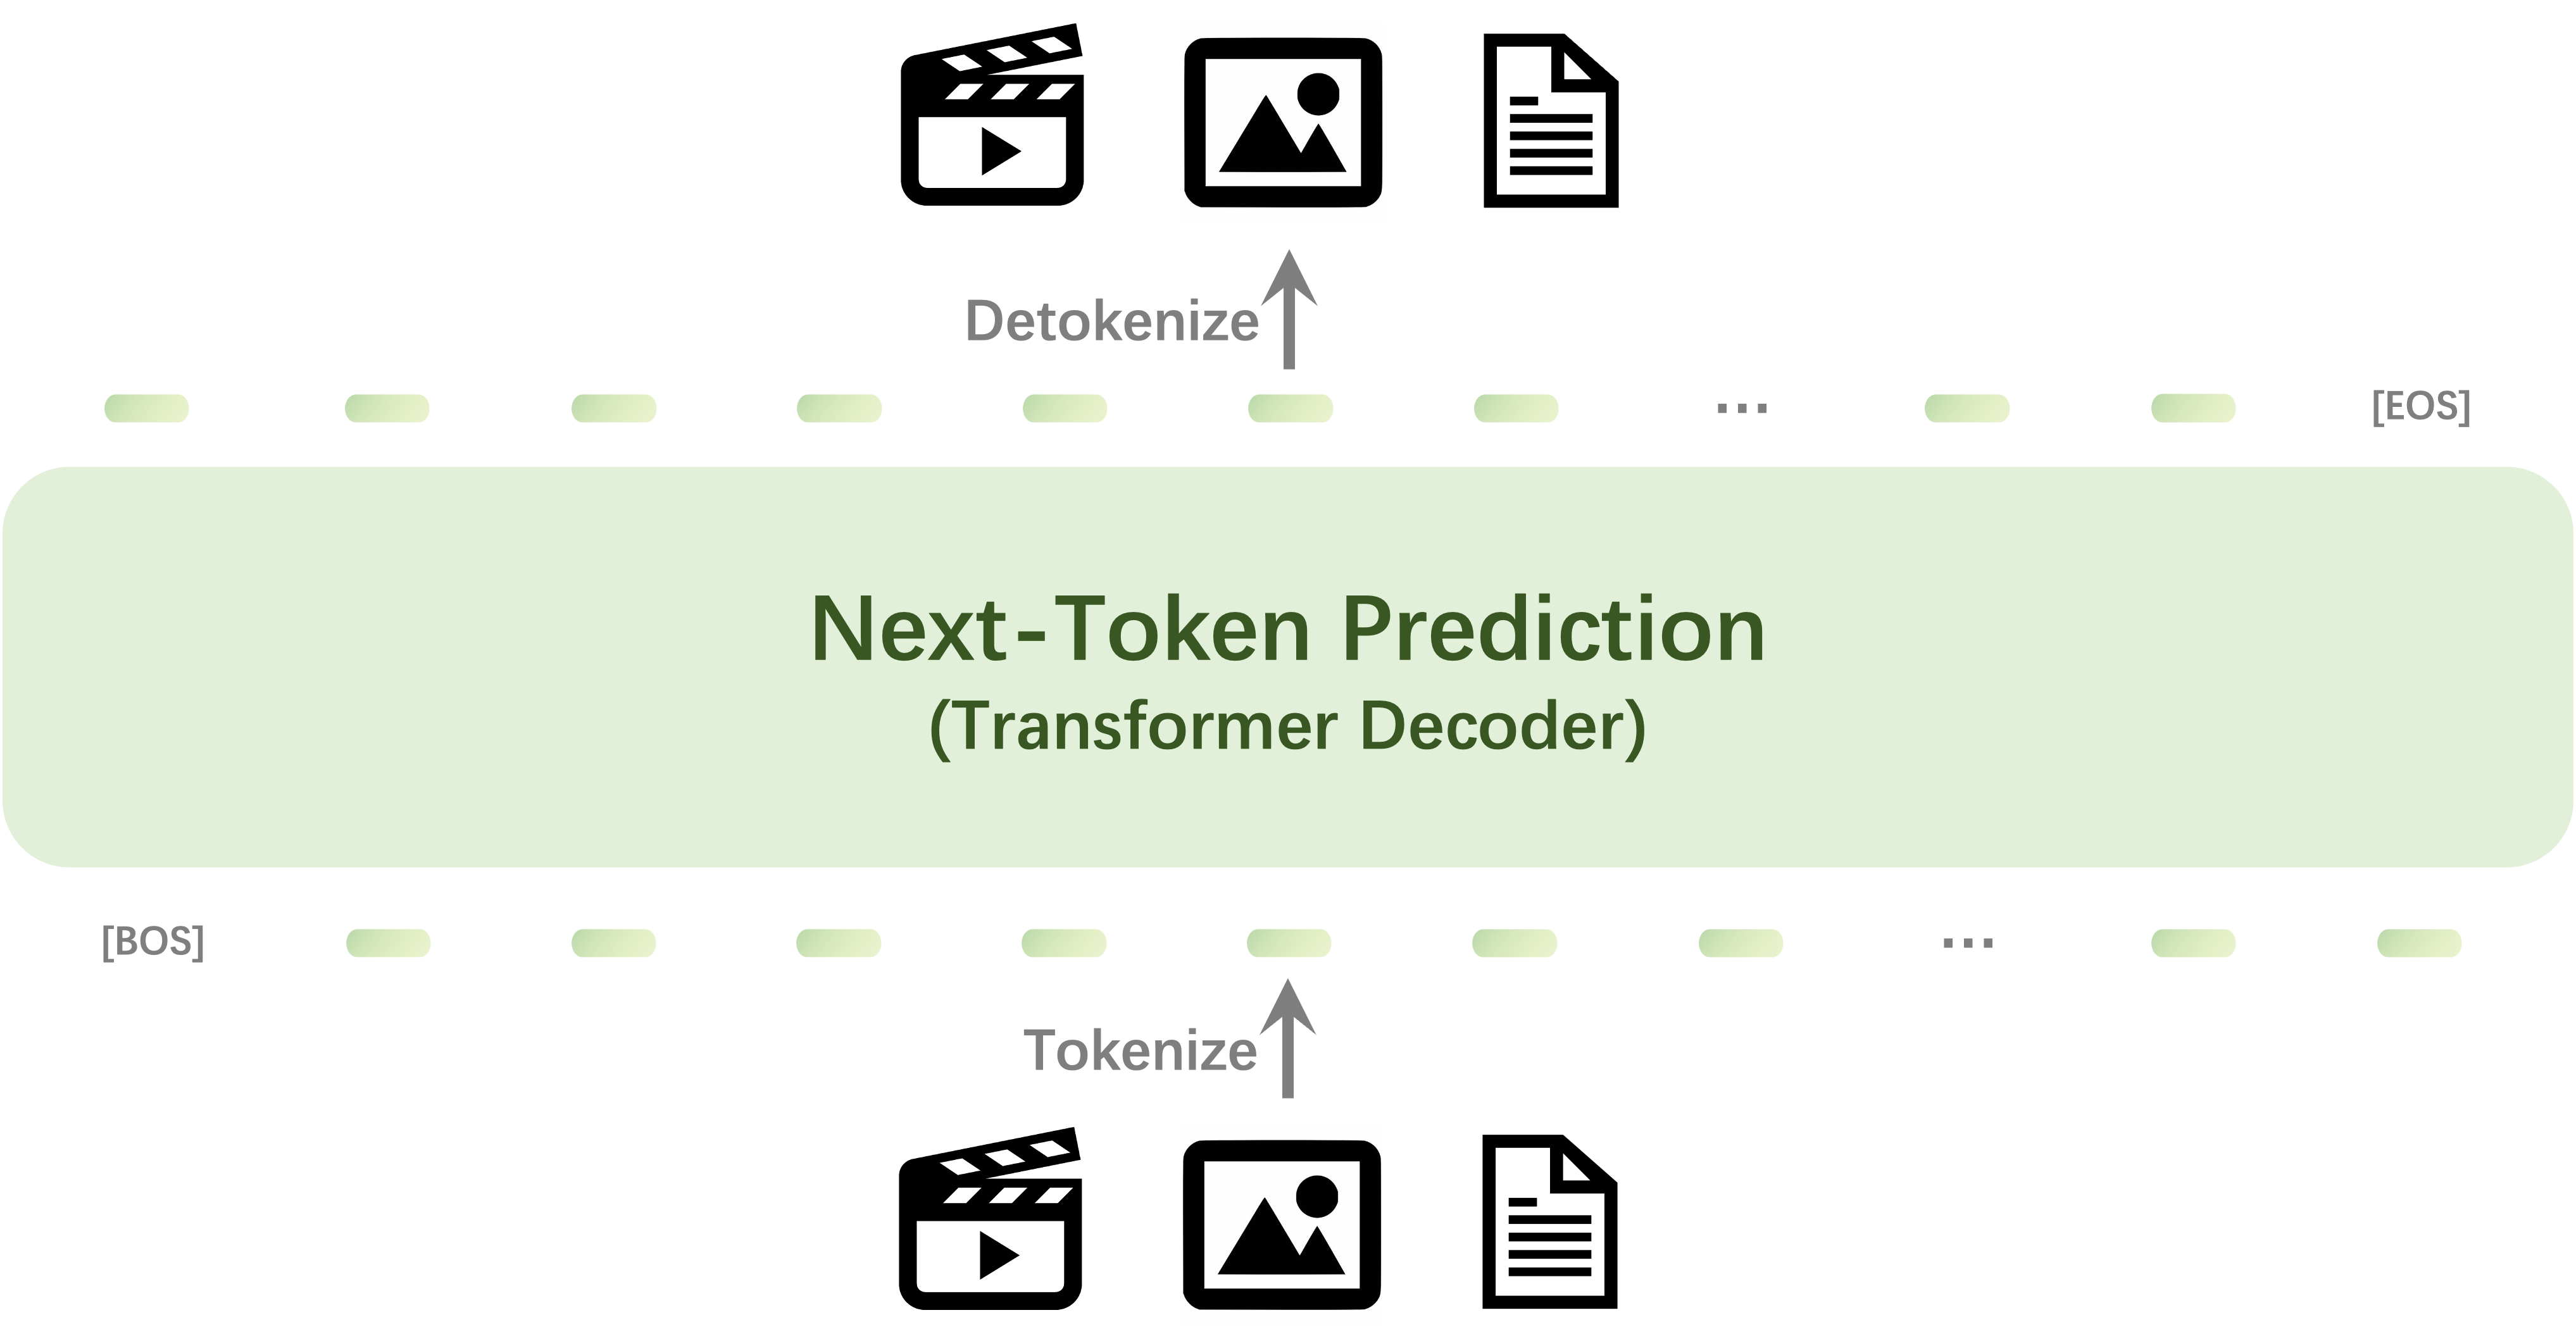
图源:Emu3 官方 GitHub README(baaivision/Emu3, assets/arch.png)—— https://github.com/baaivision/Emu3
主干 = LLM 式自回归 Transformer(解码器 only)。 沿用 Llama-2 框架,唯一主要改动是扩大 embedding 层以容纳离散视觉 token。具体配置(Table 3):
- 参数 8B;32 层;hidden size 4096;intermediate size 14336;32 attention heads,8 KV heads(GQA)。
- 归一化 RMSNorm;激活 SwiGLU;位置编码 RoPE,RoPE base = 1,000,000;qkv 与线性投影去掉 bias;加 dropout 0.1 提升训练稳定性。
- 词表 184,622(文本词表 + 视觉 codebook + 特殊 token);上下文长度 131,072(为容纳视频)。
- 文本分词用 QwenTokenizer(多语言)。
视觉 tokenizer(关键组件,单独训练): 基于 SBER-MoVQGAN-270M(MoVQGAN 架构,见 taming-transformers-vqgan 谱系)。
- codebook 32,768;空间 8×8 下采样、时间 4× 下采样(4×8×8);可处理任意时空分辨率。
- 把一个
4×512×512视频片段或一张512×512图像编码成 4096 个离散 token。 - 在 MoVQGAN 基础上,编码器与解码器各加两层带 3D 卷积核的时间残差层以增强视频分词能力。
- 没有 text encoder(无 T5/CLIP):文本条件信息天然由自回归序列里的 caption token 提供,这是它相对扩散模型的核心架构差异。
统一序列格式(条件注入): 用 5 个特殊 token 把文/视拼成”文档”:
[BOS] {caption} [SOV] {meta text} [SOT] {vision tokens} [EOV] [EOS]。[SOV]=视觉输入起、[SOT]=视觉 token 起、[EOV]=视觉输入止;视觉 token 内部再插 [EOL](换行)、[EOF](换帧)。meta text 用纯文本写分辨率(视频还含帧率、时长)。把 caption 移到 [EOV] 之后即构成”理解”样本——生成与理解共享同一格式,仅靠 caption 的前后位置区分。
数据
从头训练,混合语言 + 图像 + 视频三类数据(具体 token 配比/总规模论文未完整披露)。
- 语言数据: 直接复用 Aquila 的高质量中英双语语料。
- 图像数据: 自建大规模图文数据集 = 开源 web 数据 + AI 生成数据 + 高质量自有数据。过滤流水线:①分辨率过滤,丢弃 < 512×512;②用 LAION-AI 美学预测器打分,< 5.5 剔除;③未过美学的图再走文本检测(PaddleOCR)+ 颜色过滤,保留非单色、少文字图以提召回;④按 DenseFusion 流程额外抽取数百万张涵盖图表/表格/富文本等类别的图用于理解。
- re-caption(合成标注): 基于 Emu2-17B 训练一个图像 captioner 来生成 dense 合成 caption——先用 GPT-4V + 细致 prompt 造约 100 万图文对,再 fine-tune Emu2-17B 作为最终 captioner,用 vLLM 加速大规模标注。论文明确指出训练大量使用合成 dense caption,所以模型在 dense prompt 上比短 prompt 表现更好(这也是后面 GenEval/T2I-CompBench 要用”prompt 改写”的原因)。
- 视频数据: 覆盖风景/动物/植物/游戏/动作等。四阶段处理:①PySceneDetect(ContentDetector + ThresholdDetector)切场景;②PaddleOCR 文本检测,去掉文字过多片段(抽 2 FPS、短边 resize 256 省算力);③算光流(flow score = 平均光流幅值/短边)剔除运动过小或过大的片段;④LAION 美学预测器抽 3 帧打分,最低分 < 5 丢弃。视频 caption 用基于图像 captioner 微调的 video captioner:先 GPT-4V 标注(每片段抽 8 帧,描述内容+运动,部分人工修订),再微调得到 video captioner,vLLM 大规模加速;< 20s 抽 12 帧标注,更长的切成 10–20s 子片段各自标注。
训练方法
统一训练目标:next-token prediction + 标准交叉熵(视觉信号已全离散,无需扩散/flow matching)。为防止视觉 token 主导学习,给视觉 token 的 loss 乘 0.5 权重。
预训练(两阶段):
- 阶段一(无视频):从头训,文本+图像,上下文长度 5120。
- 阶段二(引入视频):上下文长度拉到 131072。
- 两阶段学习率均 5×10⁻⁵,cosine 退火到 0。
- 图像/视频按保持宽高比 rescale 到面积接近 512×512 再分词;把 text-image 数据 pack 到最大上下文以打满算力,并保证打包时不切割完整图像。
后训练 —— 视觉生成(两步):
- 质量微调 QFT:继续 next-token 训练但只监督视觉 token;图像数据按 HPSv2.1 + MPS + LAION-Aesthetics 三个偏好分的均值筛高质量,分辨率从 512 提到 720;视频走更严的分辨率+光流过滤;结尾用 annealing 把 lr 线性退到 0。
- DPO(首次把 DPO 用到自回归视觉生成):对每个用户 prompt 用 QFT 模型推 8–10 次建数据池→ 3 名标注员就”视觉吸引力 + prompt 对齐”打分→ 取最高分为 chosen、最低为 rejected 组成三元组。关键工程:直接存数据构造阶段产生的 token供训练复用,避免重新 tokenize 带来的重建差异。Emu3-DPO 同时最小化 DPO loss 与 next-token 交叉熵。
后训练 —— 视觉理解(两阶段):
- image-to-text 训练:图像理解数据 + 纯语言数据混合,忽略视觉 token 的 loss(只预测文本);图按宽高比 resize 到约 512×512。
- 指令微调:从 LLaVA-OneVision 采子集做 vision instruction following;< 512×512 或 > 1024×1024 的图按下/上限 resize,其余保持原分辨率。
视频后处理(附录 B.2,独立小模型,非主干): ①视频稳定化——基于 SVD 时间 VAE 训练,损失 = L1 + LPIPS + GAN + KL;②超分——时空 UNet,4× 放大,BlurPool 下采样 + sub-pixel 上采样,损失 = L2 + LPIPS + GAN。VBench 评测在后处理后的视频上做。
Infra(训练 / 推理工程)
- 并行: 张量并行 TP + 上下文并行 CP + 数据并行 DP 组合(CP 为支撑 131072 长上下文/视频的关键)。data packing 打满算力且不切完整图。
- 算力规模 / GPU·时 / 吞吐 / 集群细节:论文未披露。
- 数据标注 infra: captioner 标注用 vLLM 大规模加速。
- 视觉 tokenizer 训练: 在 LAION-High-Resolution(图)+ InternVid(视频)上端到端训,损失 = L2 + LPIPS 感知损失 + GAN loss + commitment loss。
- 推理(来自 GitHub/HF 代码): HF Transformers 推理,bf16 + flash_attention_2;图像生成用
max_new_tokens=40960、top_k=2048、do_sample、CFG(demo 默认 guidance 3.0,T2I 评测用 5.0–5.5),并用PrefixConstrainedLogitsProcessor按目标 h/w 约束 token 排布、用UnbatchedClassifierFreeGuidanceLogitsProcessor做无分类器引导。T2I 评测设 Top-k=16,384、Top-p=1.0;Emu3 输出 512×512、Emu3-DPO 输出 720×720。Emu3-Chat 已被 vLLM 以Emu3ForConditionalGeneration支持。 - 部署形态:开源权重(HF/ModelScope/Wisemodel),含 Emu3-Stage1(512×512 预训练)、Emu3-Gen(生成)、Emu3-Chat(理解)、Emu3-VisionTokenizer。
评测 benchmark(把效果讲清楚)
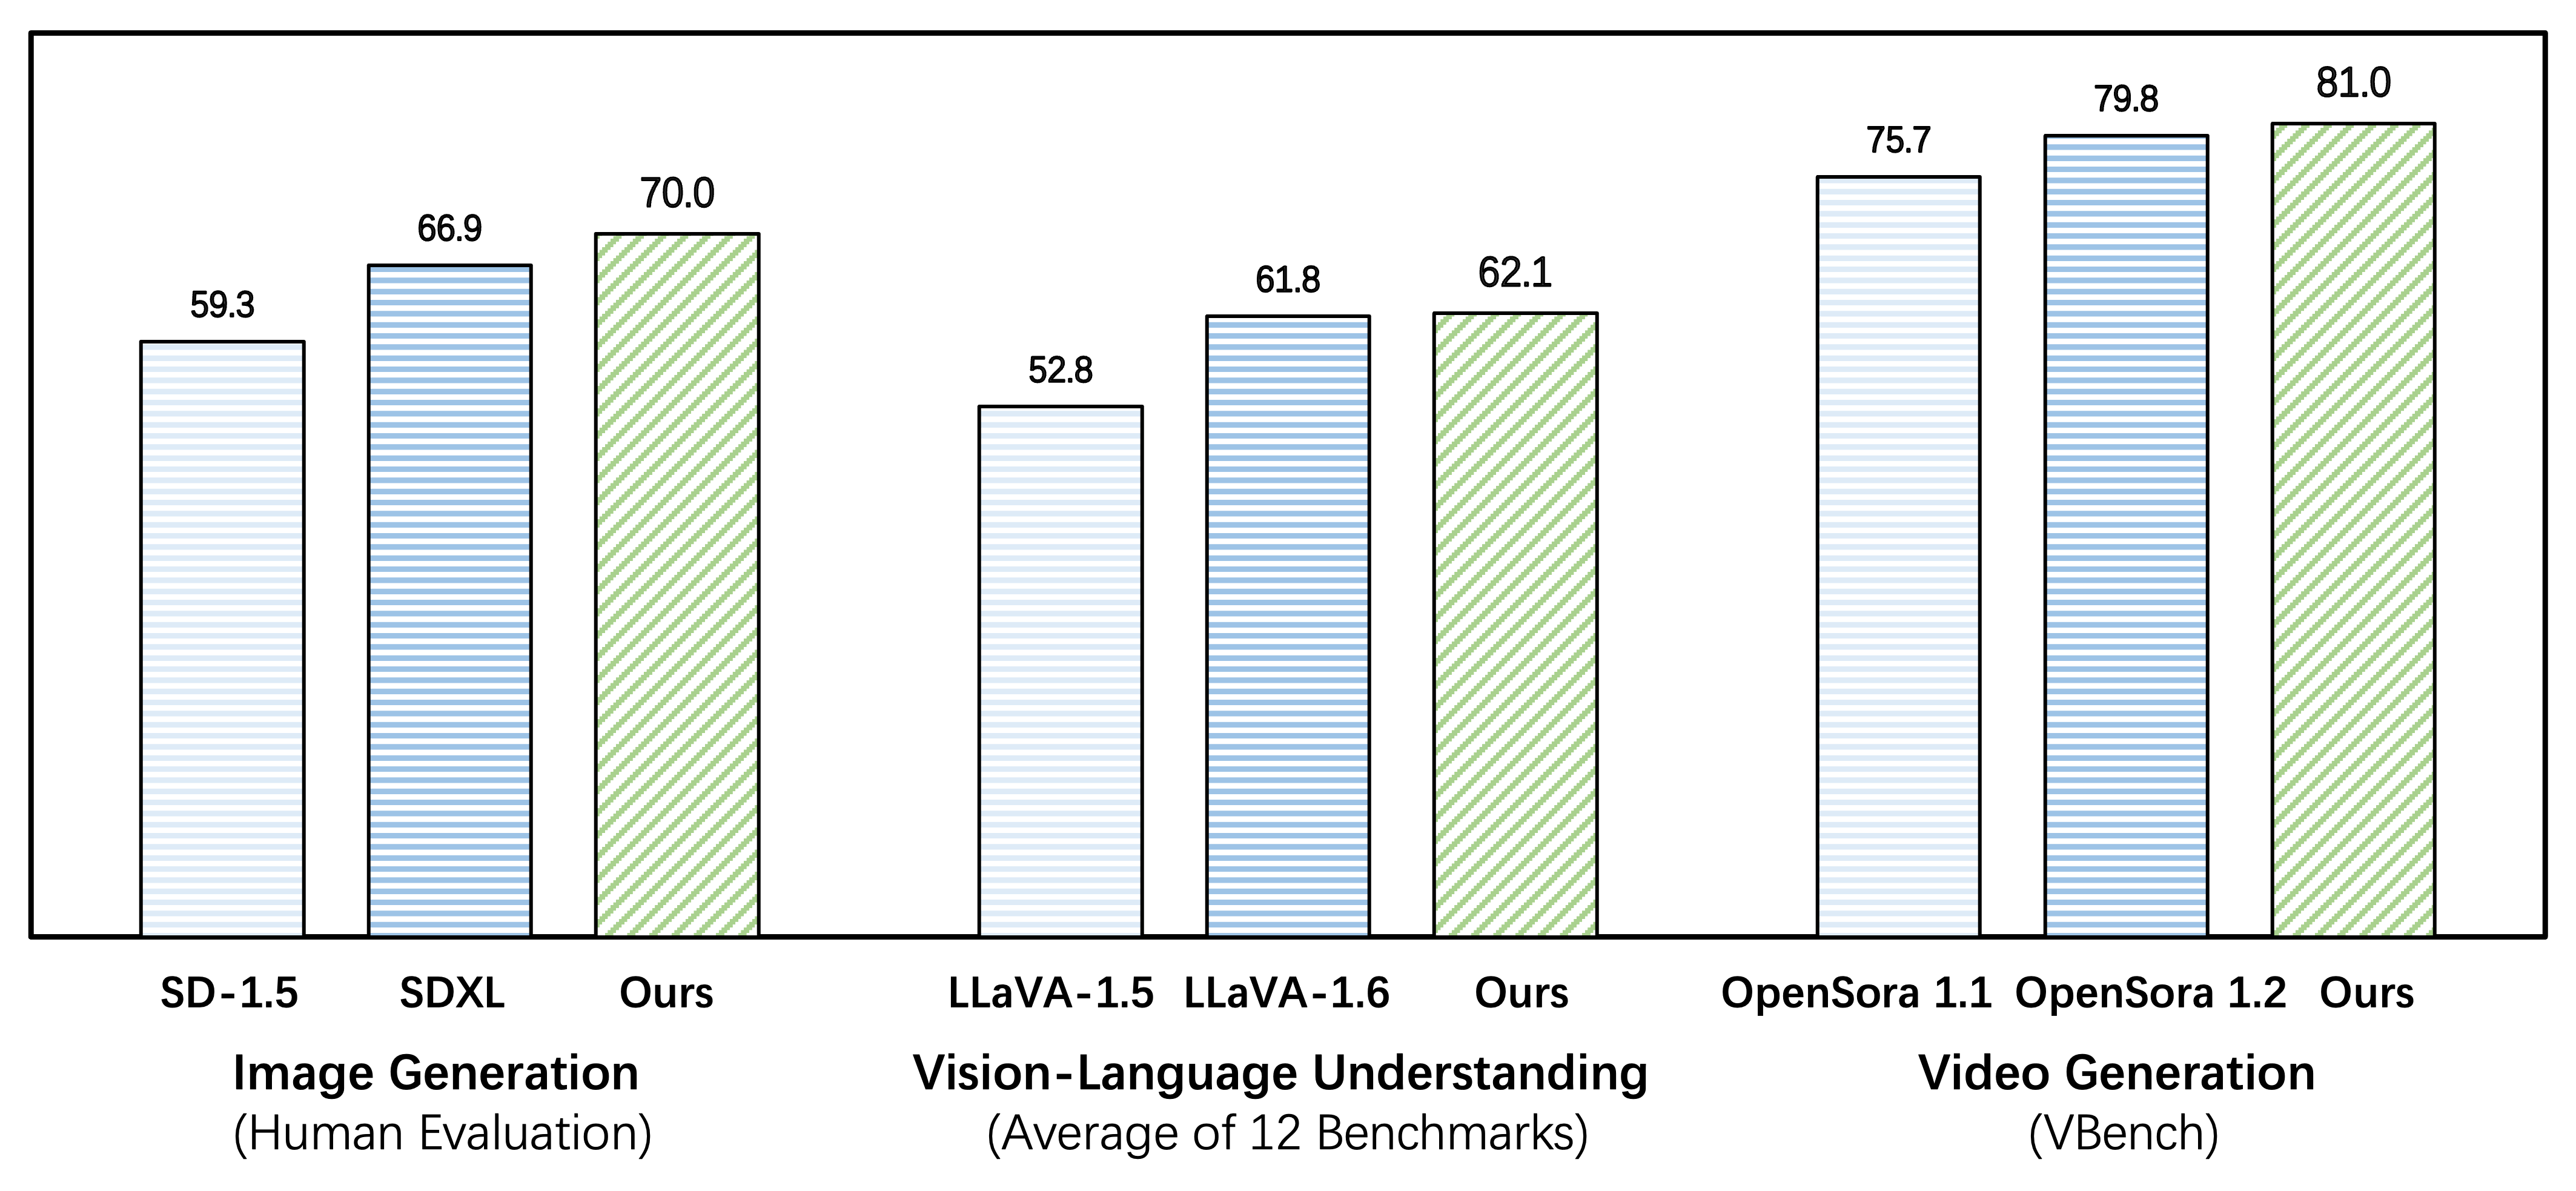
图源:Emu3 官方 GitHub README(baaivision/Emu3, assets/comparison.png)—— https://github.com/baaivision/Emu3 ;三组对比:图像生成人评(Ours 70.0 > SDXL 66.9)、视觉理解 12 benchmark 均分(Ours 62.1 > LLaVA-1.6 61.8)、视频生成 VBench(Ours 81.0 > OpenSora-1.2 79.8)。
所有数字来自已抓取的论文 PDF(Table 4/5/6/7/8 与附录 B.1)。
图像生成 —— 自动指标:
- GenEval(overall,Table 4/7):裸 prompt Emu3 = 0.54、Emu3-DPO = 0.52;加 GPT-4V rewriter 后 Emu3 = 0.66、Emu3-DPO = 0.64。对比 Chameleon 0.39、LlamaGen 0.32、Show-o 0.53、Transfusion 0.63、SDXL 0.55、DALL-E 3 0.67、SD3 0.74。即 Emu3(rewriter,0.66)显著超 Chameleon/Show-o/Transfusion,超 SDXL,对标 DALL-E 3(0.67),但仍低于 SD3 的 0.74;DPO 后 GenEval 略降(0.66→0.64),与下文”DPO 提升人评却令自动指标回退”一致。(分维度见 Table 7,含 Single/Two Obj、Counting、Colors、Position、Color Attri.,Emu3 在 Position 维仍偏弱。)
- T2I-CompBench(Color / Shape / Texture,BLIP-VQA):Emu3 = 0.7913 / 0.5846 / 0.7422,Emu3-DPO = 0.7544 / 0.5706 / 0.7164(均为 rewriter 结果),与 SOTA 扩散模型竞争。
- DPG-Bench(average,长 dense prompt):Emu3 = 80.60,Emu3-DPO = 81.60,高于 SDXL 与 PixArt-alpha,对标 DALL-E 3(用 mPLUG-large 评测,每 prompt 生 4 图、CFG 5.0)。
- MSCOCO-30K(zero-shot):报告了 CLIP-I / CLIP-T / FID(CFG=5.0),但论文也强调因大量合成 dense caption,短 prompt 的 GenEval/T2I-CompBench 不能完全反映真实能力,故引入人评。
图像生成 —— 人评(100 prompt,每条 3 人投票,视觉质量+prompt 对齐加权):
- 论文正文(§3.1.2)明确结论:Emu3 总分超过 SDXL,与 DALL-E 3、MJ-v5.2 相当(这是文字定性,未在正文给 Emu3 自身的总分数字)。图 5 给出的对照模型分(英/中文 prompt)为 DALL-E3 73.4/74.6、MJ-v5.2 77.4/71.1、FLUX.1-dev 68.5/66.9、PG-v2.5 70.0/67.7(柱状图轴标,仅供量级参照;Emu3/SD-XL 柱的精确总分无法从 PDF 文本可靠读出)。
- DPO 消融(图 6,非总分图):相对 SD-XL 基线,DPO 同时提升视觉质量 52.3 → 57.3、prompt 对齐 60.6 → 61.6(w/o → w/ DPO),人评层面有效;但自动指标上 DPO 后略降(GenEval 0.66→0.64、DPG 等),论文解释为 DPO 数据偏重整体美学、与自动评测模型的偏好域不一致——故强调要看人评。
视频生成 —— VBench(Table 5,16 维,展示 11 维 + 总分):
- Emu3(唯一 AR 模型)总分 80.96;对照 ModelScope 75.75、LaVie 77.08、OpenSora V1.2 79.76、VideoCrafter-2.0 80.44、T2V-Turbo 81.01、CogVideoX-5B 81.61、Kling(2024-07) 81.85、Gen-3 82.32。
- 结论:超过多数开源扩散视频模型(含 OpenSora-1.2),落后于最先进闭源 Kling/Gen-3。其动态程度(dynamic degree 79.27)很高,但多物体/人物动作等语义维偏弱。
- 还能做视频外推/未来预测:2s 上下文预测后续 2s,可迭代外推到超上下文长度(实测用 2s 上下文成功外推 8s)。
视觉理解 —— 12+ 公开 benchmark(Table 6,encoder-free 路线):
- Emu3 作为纯 encoder-free、不依赖专用 LLM 与 CLIP 的方法,在多个 benchmark 上超过同类 encoder-free(Fuyu-8B、EVE-7B、Chameleon、Show-o)。
- 与 encoder-based 的 LLaVA-1.6-7B 总体竞争/相当(论文图 2 给出 12 benchmark 平均超过 LLaVA-1.6-7B 的对比;逐项见 Table 6,部分项标注训练见过相关数据集图像)。
视觉 tokenizer 重建(Table 2,Pexels 3172 视频): 512×512 视频 LPIPS 0.112 / PSNR 22.69 / SSIM 0.690;720×720 时 PSNR 24.30 / SSIM 0.771。
创新点与影响
核心贡献:
- 首个证明”纯 next-token 预测”可在生成与理解两端同时打过/对标 task-specific SOTA 的统一多模态模型——单一 8B Transformer,彻底去掉扩散、CLIP、外接 LLM/文本编码器,把复杂多模态设计收敛到唯一焦点:“token”。
- 开源了一个同时能离散化图像与视频的强视觉 tokenizer(4×8×8 压缩、codebook 32768),填补此前公开空白。
- 首次把 DPO 用于自回归视觉生成并验证有效(含”复用构造阶段 token、避免再分词”的工程细节)。
- 用统一序列格式(特殊 token + caption 位置)把”生成”与”理解”、“图/文/视频”装进同一训练范式,论证了纯离散 token 自回归的可扩展性(训练/推理两端都能直接吃 LLM 生态的 scaling 与 infra)。
影响: 与 Chameleon、Janus 系列、Show-o、Transfusion 共同坐实”全离散 token 统一多模态”路线;作为开源一手实现(权重 + tokenizer + 代码),成为后续统一自回归生成/理解工作的常用对照与起点(Emu3-Chat 后被 vLLM 原生支持)。
已知局限(论文/数据可见):
- 视频生成仍落后最先进闭源扩散(Kling/Gen-3),语义维(多物体、人物动作)偏弱。
- 强依赖合成 dense caption,导致短 prompt 上要靠 GPT-4V rewriter 才能发挥,裸短 prompt 评测偏低。
- DPO 提升人评却令部分自动指标回退,偏好域与自动评测域不一致。
- 自回归逐 token 解码 + 超长视觉序列(一图 4096 token、
max_new_tokens上万)→ 推理慢,是该范式相对扩散并行去噪的固有代价(论文未给推理延迟数字)。 - 训练算力/GPU·时/总 token 配比等关键 infra 数字未披露。
原始链接
- arxiv_abs: https://arxiv.org/abs/2409.18869
- arxiv_pdf: https://arxiv.org/pdf/2409.18869
- github: https://github.com/baaivision/Emu3
- hf_collection: https://huggingface.co/collections/BAAI/emu3-66f4e64f70850ff358a2e60f
- hf_modelcard(Emu3-Gen): https://huggingface.co/BAAI/Emu3-Gen
- modelscope: https://modelscope.cn/collections/Emu3-9eacc8668b1043
- project_page: https://emu.baai.ac.cn
一手源存档(sources/)
- arxiv-2409.18869.pdf (arXiv 原文 PDF,不入 git)
- readme.md
- emu3-gen—hf-modelcard.md
- projectpage.md