一句话定位
Transfusion 用单个 transformer、单套权重同时承载两种损失——文本走 next-token prediction(自回归),图像走 diffusion(DDPM 去噪),在混合模态序列上从零联合预训练;7B 模型在 2T token 上训练后,GenEval 达 0.63(超过 DALL-E 2 0.52、SDXL 0.55),文本能力与同数据 Llama 1(66.1 平均准确率)持平,做到”两个世界的好处一锅端”。
背景与定位
多模态生成需要同时产出离散元素(文本/代码)与连续元素(图像/音视频)。两条主流路线各有损失:语言模型用 next-token 统治离散域,ddpm 类扩散模型(及 flow matching)统治连续域。要把两者塞进一个模型,此前要么 (1) 把扩散模型当工具外挂/嫁接到 LLM(GILL、DreamLLM),要么 (2) 把图像量化成离散 token 再用标准 LM 建模(DALL-E 1、Parti、chameleon)——后者结构简单但有量化信息瓶颈。
Transfusion 的核心主张:不必量化、不必信息损失,让同一个模型既预测离散文本 token 又对连续图像做扩散去噪即可。它与同期 Meta 的 chameleon(早融合、全离散 token)构成直接对照——Transfusion 把图像保留在连续空间,去掉了 VQ 量化瓶颈。论文用严格的 compute-/data-controlled 实验证明在同 FLOPs 下 Transfusion 全面优于 Chameleon 路线。该工作是 bagel 等后续统一多模态模型的直接先驱(“理解+生成单模型”范式)。
模型架构
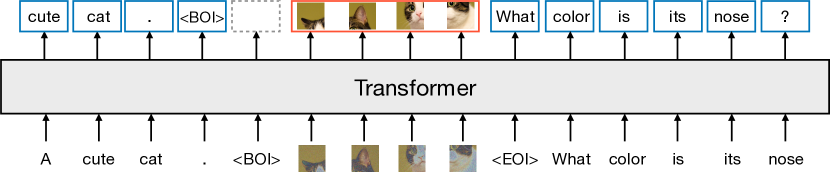
图源:Transfusion (arXiv:2408.11039) Figure 1
- Backbone:单个 Llama 风格 transformer(SwiGLU 激活 + RoPE 位置编码),所有模态共享绝大部分参数。处理 R^d 向量序列进、同型向量出。模型规模 0.16B / 0.37B / 0.76B / 1.4B / 7B(7B = 32 层、emb 4096、32 头)。
- 模态特定轻量编解码层(不共享):
- 文本:标准 embedding 矩阵(整数→向量)+ 输出投影(向量→词表分布)。
- 图像:先经预训练 VAE(86M 参数,CNN 编解码,latent 维度 8)把 256×256 像素压成 32×32×8 latent;再用以下二选一把 k×k 的 latent patch 压成一个 transformer 向量:
- 简单 linear 层(patch 前给每个 patch 向量加上 timestep t 的 embedding),参数量可忽略(<0.5% 总参数);
- U-Net 的 down/up block(把 AdaLayerNorm 换成普通 LayerNorm),共 0.27B 额外参数,对 7B 仅 +3.8%(与 embedding 层量级相当)。U-Net 自带内部 bidirectional attention,带来超出”加参数”本身的归纳偏置增益。
- Transfusion Attention(关键设计):整条序列用 causal mask,但单张图像内部的 patch 之间用 bidirectional attention(图内全连,图外只能看前文)。消融显示这是 FID 的关键:linear 编码下从 causal-only 的 FID 61.3 → bidirectional 的 20.3。
- 条件注入:caption 文本与图像同处一条序列、靠注意力做跨模态条件(无独立 cross-attention 模块);生成图像时图像 patch 自回归地 attend 到前面的 caption。
- 分辨率/压缩策略:通过改 patch 大小,单图可表示为 1024 / 256 / 64 / 16 个序列元素;U-Net 编码下可压到每图仅 16 个 patch(64× 压缩),服务成本大降而图像质量损失小。
- 标记:BOI / EOI 特殊 token 包裹图像段,分隔模态、并作为推理时切换 LM↔diffusion 的触发信号。
数据
- 文本:Llama 2 tokenizer 与语料,2T token 的多领域分布;多数实验取其中样本。
- 图像(受控实验):380M 张授权 Shutterstock 图文对,center-crop + resize 到 256×256。caption 与 image 随机排序,80% 概率 caption 在前(图像条件于 caption,按”生成比理解更 data-hungry”的直觉)。
- 大规模实验(§4.4)数据配比:总 2T token = 1T 文本 + ~3.5B 图文对(256 patch/图,约 1T patch)。图像侧混合:
- 220M 公开图文对(预过滤掉含人物的)以增多样性;
- 上采样 80M 含人物的 Shutterstock 图以重平衡分布;
- 加入 Conceptual 12M (CC12M);最终每 epoch 692M 图文对,约 5 个 epoch。
- 训练最后 1% 阶段上采高美学(high-aesthetic)图像。
- 与 chameleon 对照时,两者的 VAE/VQ-VAE 用完全相同的数据、算力、架构训练,唯一差别是量化层 + codebook loss,以排除混淆变量。
训练方法
- 联合损失:
L_Transfusion = L_LM + λ · L_DDPM,λ=5(预实验定,未细调)。LM loss 逐 token 计(BOI token 不计损失);diffusion loss **按整张图(image-level)**计,先对 latent x0 加噪得 x_t 再 patchify。 - 扩散设定:遵循 ddpm(Ho et al. 2020)的 ε-预测目标 + cosine 噪声调度(Nichol & Dhariwal)。训练 1000 个 timestep。论文明确把 flow matching / rectified flow 当作未来工作(本作仍用经典 DDPM)。
- Image Noising trick:对 20% “图在前、caption 在后”的样本,把扩散噪声上限截到 t=500(半程),避免下游 caption 条件于过度噪化的图。消融显示这显著提升 captioning(CIDEr,0.76B 上 25.4→29.4、7B 上 33.7→35.2;Table 8),对其它指标影响 <1%。
- 优化:全参数随机初始化(from scratch,非微调已有模型);AdamW(β1=0.9, β2=0.95, ε=1e-8),lr=3e-4,warmup 4000 步、cosine 衰减到 1.5e-5;weight decay 0.1,grad clip 1.0;序列长 4096,batch 2M token,250k 步达 0.5T token(大规模实验 batch 4M、500k 步、2T token)。
- VAE 训练目标(附录 A):
L_VAE = L1 + L_LPIPS + 0.5·L_GAN + 0.2·L_ID + 1e-6·L_KL,其中 L_ID 是基于 Moco v2 内部特征的感知损失;GAN loss 延迟到 50k 步才开启。VQ-VAE 把 L_KL 换成 codebook commitment loss(β=0.25),codebook 16384 个 token 类型,量化在投影到 8 维后施加。 - 未用:无 SFT/RLHF/DPO/reward model(纯预训练 + 图像编辑做了小规模微调,见下),无 consistency/LCM/ADD 等步数蒸馏。
- 图像编辑微调(§4.5):受 LIMA 启发,仅用 8k 公开图像编辑样例(输入图 + 编辑指令 + 输出图)微调 7B 模型,即可在 EmuEdit 测试集上做指令式编辑(删除/替换物体、改风格、写字等),证明可泛化到预训练未覆盖的 image-to-image 任务。
Infra(训练 / 推理工程)
- 训练算力:论文未披露具体 GPU 型号/数量/卡时。用理论 FLOPs(6ND)作为算力代理度量,未给绝对墙钟时间或集群规模。混合精度、并行策略等工程细节未披露。
- 推理:解码算法在 LM 模式与 diffusion 模式间切换——LM 模式逐 token 采样(文本用 greedy;Llama eval 用 ranked classification),采到 BOI 即切到 diffusion 模式,向序列追加 n 个纯噪声 patch、迭代去噪 T 步,每步用预测噪声生成 x_{t-1} 并覆盖序列中的 x_t(模型只 condition 于最新 timestep,不 attend 历史 timestep),结束追加 EOI 切回 LM。
- 推理步数:训练 1000 步、推理 250 步扩散。CFG 系数:受控对照用 5(论文称对 Transfusion 偏次优),消融用 3,大规模实验按 benchmark 逐一调。
- 服务成本:U-Net 编码 + 大 patch 可把每图压到 16 patch,相比 1 patch/latent 减少最多 64× 序列长度→大幅降推理成本。
- 部署形态:研究原型,无开源权重/代码发布(截至本页核查,facebookresearch 无官方 transfusion 仓库,返回 404)。
评测 benchmark(把效果讲清楚)
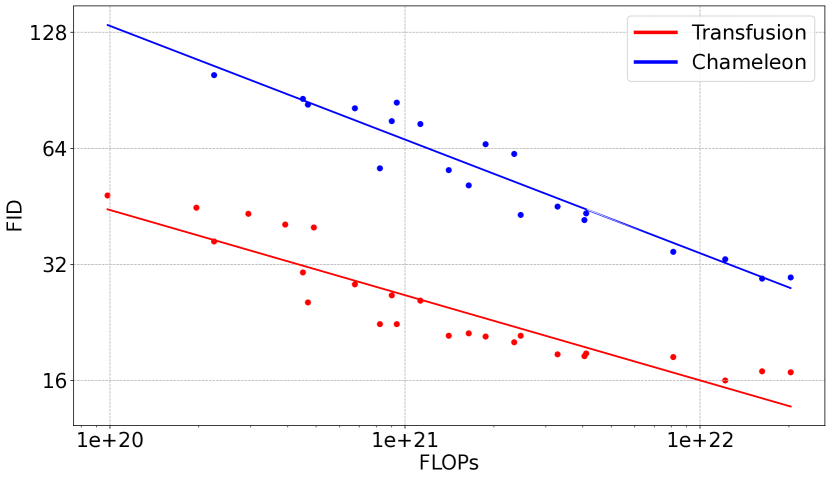
图源:Transfusion (arXiv:2408.11039) Figure 5(e) — MS-COCO 30k FID scaling(Transfusion vs Chameleon,同 FLOPs 下 Transfusion 红线全面更低)
评测套件:文本困惑度(Wikipedia / C4,20M held-out token)、Llama 2 eval suite(HellaSwag/PIQA/SIQA/WinoGrande/ARC-e/-c/BoolQ 的 0-shot 平均准确率)、图生文 MS-COCO CIDEr、文生图 MS-COCO 30k 的 FID 与 CLIP score、以及 GenEval。
1) 受控对照 Chameleon(同 N、同 D、同 FLOPs,0.5T token,7B)— Table 3 + parity FLOP ratio:
- Transfusion 在每个 benchmark 上 scaling 都优于 Chameleon,趋势线近平行但持续领先。
- 关键 parity FLOP ratio(Transfusion 达到 Chameleon 同等性能所需 FLOPs 占比):
- 图像生成 FID:0.029(即用 34× 更少算力即达 parity,论文最亮眼数字);
- 图生文 CIDEr:0.218(21.8% FLOPs);
- 文本 C4 PPL 0.489 / Wiki PPL 0.526 / Llama Acc 0.600(约 50%–60% FLOPs,纯文本也更高效)。
- 7B 受控结果对比(C4 PPL / Wiki PPL / Llama Acc / COCO-CIDEr / FID / CLIP):Transfusion 7.72 / 4.28 / 61.5 / 27.2 / 16.8 / 25.5 vs Chameleon 8.41 / 4.69 / 59.1 / 18.0 / 29.6 / 24.3。
2) 文本退化归因(0.76B,Table 4,相对 Llama 2 recipe 基线 C4 10.1 / Wiki 5.8 / Acc 53.7):
- Transfusion 加扩散+图像 patch 后:C4 +0.3、Wiki +0.2、Acc −2.0(代价小);
- Chameleon 的稳定性改动 + 在图像 token 上算 LM loss 后:C4 +0.9→+0.8、Acc −1.8→−3.0(离散图像 token 比扩散更伤文本)。
3) 注意力消融(0.76B,Table 5):linear 编码下 intra-image bidirectional attention 把 FID 从 61.3 降到 20.3(U-Net 因自带内部 bi-attn 差距较小)。
4) Patch size / 编码架构消融(Table 6/7):linear 编码下 patch 越大性能越差;U-Net 编码在图像任务上反而受益于大 patch(看到更多图与扩散噪声)。U-Net 对小模型增益巨大(如 1.4B+U-Net 的 CIDEr 超过 7B+linear),且增益随规模缩小但不消失(7B 上 U-Net 仍把 FID 18.6→16.0、CIDEr 27.2→33.7)。
5) 大规模 7B / 2T token(Table 9,与图像生成 SOTA 对比):
- GenEval 0.63(Table 9)> DALL-E 2 (0.52)、SDXL (0.55)、SD 2.1 (0.50)、SD 1.5 (0.43)、Chameleon (0.39);接近 DeepFloyd (0.61);略低于 SD 3 (0.68,但 SD 3 用了 backtranslation 合成 caption,对小规模即 +6.5% 绝对值 0.433→0.498,Transfusion 仅用自然数据)。(注:Parti 在 Table 9 仅报 FID 7.23,未报 GenEval;原页误把 SD 1.5 的 0.43 记在 Parti 名下,已订正。)
- MS-COCO FID 6.78(Table 9;DALL-E 2 10.39、DeepFloyd 6.66、Imagen 7.27、Parti 7.23;SDXL 与 SD 3 该表 FID 列未报 ”—”)。
- 文本 Llama Acc 66.1,与 Llama 1(66.1)/ Llama 2(66.3)/ Chameleon(67.1)同档——同一模型既能出图又能写文本,这是与所有纯图像生成模型的本质差异。
创新点与影响
- 核心贡献:首次证明可在单 transformer、单套权重上把”next-token(离散)+ diffusion(连续)“两种损失联合 from-scratch 预训练,无量化、无信息损失,且几乎零参数共享代价(文本能力只掉约 2% 准确率)。提出 intra-image bidirectional + 全局 causal 的混合注意力、image-level 扩散损失、image-noising 截断、U-Net patch 编码压缩等关键 recipe。
- 相对 Chameleon 的范式胜利:把图像留在连续空间、用扩散建模,比”VQ 量化成离散 token + 纯 LM”在同算力下全面更优(图像 FID 34× 效率、文本也更省),为”统一多模态该走连续扩散还是离散 AR”之争提供了强证据,深刻影响 bagel 等后续 understanding+generation 统一模型。
- 可扩展性 + 可迁移性:建立了跨单/跨模态 benchmark 的 scaling law;仅 8k 样例微调即解锁图像编辑,显示统一架构对新模态组合的泛化潜力。
- 已知局限:(1) 仍用经典 DDPM,未上 flow matching/rectified flow(明确留作 future work);(2) 未做 SFT/RLHF/偏好对齐,未做步数蒸馏;(3) 仅 256×256、未探更高分辨率;(4) 训练算力/工程细节与代码权重均未公开;(5) λ、CFG 等超参未细调;(6) 离散扩散用于文本生成尚未达 AR 规模,跨模态融合还有空间。
原始链接
- arxiv_abs: https://arxiv.org/abs/2408.11039
- arxiv_pdf: https://arxiv.org/pdf/2408.11039
- (注:Meta 未发布官方代码/权重仓库;facebookresearch/transfusion 返回 404,无官方 GitHub / HF / blog 一手源)
一手源存档(sources/)
- arxiv-2408.11039.pdf (arXiv 原文 PDF,不入 git)