一句话定位
BAGEL 是字节 Seed 开源的 统一多模态基础模型(7B 激活 / 14B 总参,Mixture-of-Transformer-Experts 架构),在 万亿级图文/视频/网页交错(interleaved)数据 上从 Qwen2.5-7B 续训,把”理解(next-token)“与”生成(rectified flow)“放进 同一个 decoder-only transformer、靠共享自注意力无瓶颈交互;最关键的发现是:随交错预训练规模放大,模型出现 能力涌现的相位转变——理解/生成最先收敛,基础编辑其次,自由形变编辑(free-form manipulation)与多模态推理涌现最晚(约 3.61T token 后才达 85% 峰值)。结果上:GenEval 0.88(带 rewriter,超 FLUX.1-dev 0.82 / Janus-Pro 0.80),WISE 0.52→0.70(带 CoT),自建 IntelligentBench 44.9→55.3(带 Self-CoT,远超开源 Step1X-Edit 的 14.9)。
背景与定位
统一理解+生成此前主要在 图文配对数据 上训练(Janus-Pro、Show-o、Transfusion 等),与 GPT-4o / Gemini 2.0 这类闭源系统差距明显。作者的核心论点是:闭合差距的关键不在于换架构,而在于”用结构化的多模态交错数据 scale up”——把文本、图像、视频、网页融合成交错序列,视频天然提供像素级/时序/物理连续性(“现实世界是最大的模拟器”),网页(图文教程、百科)提供跨模态对齐的世界知识。沿用 DeepSeek-R1 思路,再注入”推理增强”数据,让理解与生成之间发生知识迁移。
技术脉络上,BAGEL 属于 Integrated Transformer(把 LLM 与扩散统一进单个 transformer,如 Transfusion transfusion、LlamaFusion),区别于:
- Quantized AR(离散视觉 token 的 next-token,如 emu3、Janus)——生成质量与延迟差;
- External Diffuser(LLM + 外挂扩散模块经轻量 adapter,如 MetaQuery、SEED-X)——把 LLM 上下文压成少量 latent token,存在显式瓶颈、长上下文推理易丢信息。
作者选 Integrated Transformer 的理由:bottleneck-free,全层都能让理解/生成无损交互,更利于 scale、更适合后续 RL。生成走 Rectified Flow(对标 SD3 stable-diffusion-3 / FLUX flux-1),理解走 next-token(沿用 AR LLM 强项)。
模型架构
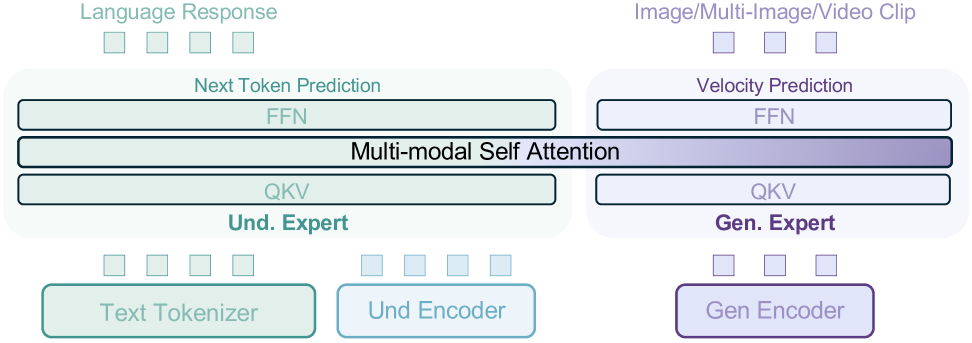
图源:BAGEL 论文 Figure 2《Emerging Properties in Unified Multimodal Pretraining》(arXiv:2505.14683)
Backbone:MoT(Mixture-of-Transformer-Experts),由 Qwen2.5 LLM 初始化的 decoder-only transformer。两个 transformer expert:
- 理解专家(Und. Expert):处理 text token 与 ViT token(沿用原 Qwen2.5 全部参数);
- 生成专家(Gen. Expert):复制 Qwen2.5 LLM 的全部可训练参数得到的全尺寸专家,专门处理 VAE token。
两专家在 每一层共享同一条 token 序列、做共享多模态自注意力(shared self-attention),只在 FFN/QKV 投影上按模态硬路由(hard routing)。这就是”无瓶颈”的来源:理解与生成只通过 attention 上下文耦合,不经任何压缩 connector。沿用 Qwen2.5 的 RMSNorm / SwiGLU / RoPE / GQA,并额外加 QK-Norm(来自图像/视频生成模型实践,稳定训练)。
双视觉编码器(“理解看语义、生成看像素”):
- 理解侧 ViT:SigLIP2-so400m/14,初始 384 分辨率,内插位置编码到最大 980×980,集成 NaViT 支持原生宽高比;接 2 层 MLP connector 对齐 LLM hidden。
- 生成侧 VAE:用 FLUX 的预训练 VAE(下采样 8×、latent 16 通道;HF model card 注明具体为 FLUX.1-schnell VAE),latent 经 2×2 patch embedding 降空间尺寸对齐 LLM 维度。VAE 全程冻结。
条件注入与 token 设计:ViT/VAE token 都先加 2D 位置编码再进 LLM;diffusion timestep 直接加到 VAE token 的初始 hidden states(而非传统 DiT 的 AdaLN),架构更干净且不掉点。一张待生成图准备三套 token:
- Noised VAE token(加扩散噪声,仅用于 RF 训练,MSE loss 算在这上面);
- Clean VAE token(无噪原 latent,作为后续 image/text 生成的条件);
- ViT token(来自 SigLIP2,统一交错输入格式,经验上提升交错生成质量)。
Generalized Causal Attention:同一 sample 的 token 按模态切成连续 split,后面的 split 可看前面所有 split;split 内部 文本用因果注意力、视觉用双向注意力。后续 image/text 只能 attend 到前图的 clean VAE + ViT token,看不到其 noised 版本。多图生成用 diffusion forcing(不同图加独立噪声等级,互为条件),并随机把连续图分组做组内 full attention 提一致性。用 PyTorch FlexAttention 实现,比 naive SDPA 快约 2×;推理时只缓存 clean VAE + ViT 的 KV,图生成完后把 noised token 替换成 clean 版以支持 KV cache。交错推理的 CFG:以 0.1 / 0.5 / 0.1 概率分别 drop text / ViT / clean-VAE token。
架构消融(在 1.5B Qwen2.5 上控制变量):对比 Dense / MoE(只复制 FFN)/ MoT(复制全部参数)。三者训练/推理 FLOPs 相同,MoE 与 MoT 总参约为 Dense 的两倍。结论:MoT 在生成 MSE loss 上一致最优、收敛最快、终值最低,理解 CE loss 也整体最好——说明把生成与理解的参数解耦能缓解模态间优化冲突。规模上提供 BAGEL-1.5B 与 BAGEL-7B(14B 总参)两档。
数据
训练语料覆盖 language / image / video / web 四类,统计如下(Table 1,注意是采样规模、非实际见到 token):
| 数据源 | 条数 | token 量 |
|---|---|---|
| Text-only | 400M | 0.4T |
| 图文对·理解(VLM I2T) | 500M | 0.5T |
| 图文对·生成(T2I) | 1600M | 2.6T |
| 交错·理解(interleaved understanding) | 100M | 0.5T |
| 交错·生成·视频 | 45M | 0.7T |
| 交错·生成·网页 | 20M | 0.4T |
- 图文对:VLM 侧来自 web alt-text/caption,经 CLIP 相似度过滤、分辨率/宽高比/文本长度约束、去重,并用 concept-aware 采样补长尾,加入 OCR/图表/grounding 的结构化监督;T2I 侧用高质量图文对 + 少量来自现有 T2I 模型的合成数据,覆盖艺术/文字/超现实等多种 caption 风格。
- 交错·视频:源于公开在线视频 + Koala36M + MVImgNet2.0;按 T2V 流程做分镜切片、去黑边/水印、按时长/分辨率/清晰度/运动稳定性过滤、CLIP 去重。构造方法:蒸馏一个基于 Qwen2.5-VL-7B 微调的轻量 captioner,描述相邻帧之间的视觉变化(运动/动作/场景切换),每段视频平均采 4 帧、对帧对生成 caption(caption 限 30 token 抑制幻觉),得 45M 时序锚定交错序列。
- 交错·网页:基于 OmniCorpus(Common Crawl 预处理),再叠加多个开源图像编辑数据集作为结构化交错数据。两阶段过滤:先用 LLM 标小批文档训 fastText 分类器做大规模 topic selection,再过 LLM 细筛(用 Qwen2.5-14B),加规则过滤(UI 去除、分辨率[150,20000]/宽高比[1/2,2]、清晰度算子、文本密度<100 OCR token、CLIP 相关性、LLM 去页眉页脚、文档保留 3–8 图)。构造:caption-first 策略——每图先用 Qwen2.5-VL-7B 生概要 caption 插在图前作”概念脚手架”;>300 token 的图间文本用 LLM 摘要压缩,得 20M 交错网页文档。
- 推理增强数据(500k):仿 O1 / DeepSeek-R1,构造”先语言推理再生成”的样本,分三类——(1) T2I:手写简短模糊 query + guidance,用 Qwen2.5-72B in-context 扩展出详细 prompt,喂 FLUX.1-dev 出图,得 (query, reasoning trace, image) 三元组;(2) 自由形变编辑:用 VLM + DeepSeek-R1 风格 reasoning,源/目标图对取自 OmniEdit 等编辑数据集与交错视频;(3) 概念编辑(conceptual edit):从网页交错数据用三阶段 VLM 流水线(选输入-输出对→生成问题→质量过滤)构造高阶概念推理 QA。
训练方法
训练目标双轨:文本 token 走 Next-Token-Prediction(CE loss),视觉 token 走 Rectified Flow(速度预测,MSE loss);loss 加权 CE:MSE = 0.25:1。优化器 AdamW(β=0.9/0.95,ε=1e-15),全程不加 weight decay,grad clip=1.0。
四阶段训练(Table 3):
- Alignment:仅训 MLP connector,冻结 SigLIP2 ViT 与 Qwen2.5 LLM,只用图文对做 captioning,图 resize 到 378×378;LR 1e-3,cosine,~4.9B token。
- Pre-training (PT):加 QK-Norm,除 VAE 外全部参数可训;2.5T token,含 text / 图文对 / 多模态对话 / web-交错 / video-交错;native-resolution 策略(限制长边最大、短边最小);LR 1e-4 constant,200K steps,EMA 0.9999,gen 分辨率 (512,1024)、und (224,980),diffusion timestep shift=4.0。
- Continued Training (CT):提高视觉输入分辨率(对生成与理解都关键),战略性提高交错数据采样比 强化跨模态推理;约 2.6T token,LR 1e-4,100k steps。
- SFT:生成侧从图文对/交错生成中筛高质量子集,理解侧从 LLaVA-OV / Mammoth-VL 指令数据筛子集;72.7B token,LR 2.5e-5,15K steps,EMA 0.995,分辨率拉到 (512,1024)/(378,980)。
数据采样比演进(PT→CT→SFT,交错数据占比持续上调):T2I 图文对 0.6→0.4→0.3,交错理解 0.1→0.15→0.2,交错视频 0.1→0.15→0.2,交错网页 0.05→0.15→0.2——印证”先打牢理解/生成、再加码交错推理”。
关键 trick / 消融:
- timestep embedding 直加 hidden(替代 AdaLN)不掉点且更简洁;
- VAE+ViT 双特征 比只用 VAE:对经典 GEdit 影响小,但对 Intelligent Edit 去掉 ViT token 掉 16%,证明语义上下文对复杂编辑/推理至关重要;
- diffusion timestep shift 从 1.0(Alignment)提到 4.0(PT/CT),适配高分辨率生成;
- 论文未做 RLHF/DPO,但在结论中明确指出 BAGEL 性能可经”加文字图像数据 / 扩模型 / 后训练阶段 RLHF”进一步提升(留作未来工作)。
Infra(训练 / 推理工程)
- 训练工程:Generalized Causal Attention 用 PyTorch FlexAttention 实现,较 naive SDPA ~2× 加速;采用 EMA(PT/CT 0.9999、SFT 0.995)。算力规模/GPU 卡数/GPU·时/并行策略(FSDP、TP/PP)/吞吐均未在论文披露。
- 推理加速:generalized causal 结构支持 KV cache(只存 clean VAE + ViT 的 KV,图生成完用 clean token 替换 noised token);交错推理用 CFG(drop 概率 0.1/0.5/0.1)。
- 部署形态(来自 GitHub README / HF):开源代码 + checkpoint(Apache-2.0),提供 Gradio WebUI 与 HF Space demo。VRAM 分档:32GB+(或多卡)跑全精度;社区贡献 NF4 量化(推荐 12–32GB VRAM)、INT8(22–32GB)、DFloat11 (DF11) 压缩版;有 Windows 安装/打包方案。模型由 Qwen2.5-7B-Instruct + SigLIP2-so400m + FLUX.1-schnell VAE 组合 finetune 得到,三者均 Apache-2.0。
评测 benchmark(把效果讲清楚)
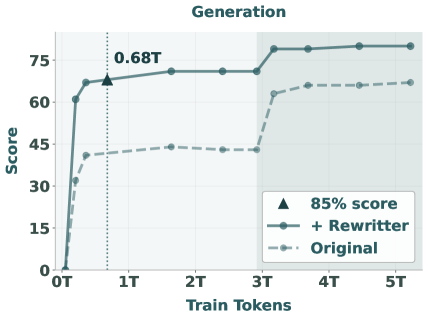
图源:BAGEL 论文 Figure 7(b)《Emerging Properties in Unified Multimodal Pretraining》(arXiv:2505.14683) —— GenEval 生成分随训练 token 增长,且 prompt rewriter 显著抬升上限
多模态理解(Table 4,BAGEL=7B 激活):MME-P 1687 / MME-S 2388,MMBench 85.0,MMMU 55.3,MM-Vet 67.2,MathVista 73.1,MMVP 69.3。相比 Janus-Pro-7B,MMMU/MM-Vet 分别 +14.3 / +17.1;在多数 benchmark 上还超过专用理解模型 Qwen2.5-VL-7B、InternVL2.5——说明 MoT 缓解任务冲突的同时保住了理解力。
T2I 生成:
- GenEval Overall 0.88(带 LLM rewriter),不带 rewriter 也有 0.82——超 FLUX.1-dev(0.82)、SD3-Medium(0.74)、Janus-Pro-7B(0.80)、MetaQuery-XL(0.80)。
- WISE(世界知识推理 T2I,Overall):非 CoT 0.52,带 Self-CoT 0.70——开源最强(前 SOTA MetaQuery-XL 0.55),仅次于 GPT-4o 的 0.80。
图像编辑(GEdit-Bench,GPT-4.1 评分,higher better):BAGEL EN 子集 G_SC 7.36 / G_PQ 6.83 / G_O 6.52,CN 子集 7.34 / 6.85 / 6.50——与专用编辑 SOTA Step1X-Edit(EN G_O 6.70)持平,并超过 Gemini 2.0(G_O 6.32)。
Intelligent Editing(自建 IntelligentBench,350 例,GPT-4o-2024-11-20 评 0–2 分归一到 100):BAGEL 44.9,带 Self-CoT 55.3——大幅领先开源 Step1X-Edit 的 14.9(+30);GPT-4o 78.9 / Gemini 2.0 57.6(注:私有模型仅在其回答的子集上评分)。(HF model card 表记为 44.0,应为版本微调差异,以论文 44.9 为准。)
Thinking 增益:CoT 一致提分——WISE 0.52→0.70(+0.18)、IntelligentBench 44.9→55.3、RISEBench 6.1→11.9、KRIS-Bench 56.21→60.18。
涌现曲线(Emerging Properties,Fig.7)——以”达 85% 峰值所需 token”为指标:理解 ~0.18T、生成 ~0.68T 早早饱和;经典编辑需 ~2.64T;Intelligent Edit 需 ~3.61T,且在 3T token 后从 15 飙到 45(约 3×),呈典型相位转变。loss 曲线本身看不出这种跃变,必须靠历史 checkpoint 评测才能观察到。
消融:MoT > MoE > Dense(生成 loss 差距最大);数据比 1g1u/2g1u/3g1u/4g1u 与 LR 扫描均在 1.5B 上做;去 ViT token 使 Intelligent Edit 掉 16%。
创新点与影响
核心贡献:
- 提出并验证统一多模态预训练的 “能力涌现/相位转变” 现象——不同能力在不同 token 规模分阶段出现,且 loss 不可预测,须靠下游评测追踪;
- bottleneck-free 的 MoT 统一架构:双 expert + 双视觉编码器(SigLIP2 理解 / FLUX-VAE 生成)+ 共享自注意力,理解走 next-token、生成走 rectified flow,规避了 external-diffuser 的 latent 压缩瓶颈;
- 一套 可扩展的多模态交错数据协议(视频帧间 caption + 网页 caption-first + 推理增强 500k),把”世界建模”信号引入训练;
- 首个把统一模型推到”世界建模”任务(自由形变编辑、多视角合成、世界导航、未来帧预测、3D 旋转),并提出 IntelligentBench 评测复杂推理式编辑;
- 完整开源(论文 + 代码 + checkpoint + 数据创建协议 + 1.5B/7B 两档),Apache-2.0。
影响:BAGEL 是 2025 年开源统一多模态的标杆之一,把”统一模型靠交错数据 scale 出涌现”这一范式做实,直接推动了字节后续 emu3-5 等工作与社区对”理解-生成统一 + 世界建模”的探索;社区迅速产出 NF4/INT8/DFloat11 量化与多平台部署。
已知局限:特殊 IP 生成、复杂文字渲染、密集人体姿态、多实例同时生成仍困难;编辑中”交换物体位置 / 同时改大量实例”易失败;复杂场景下 BAGEL 与 Gemini 2.0 都难严格遵循指令,GPT-4o 仍最稳。作者点名后续可用 RLHF / 扩数据 / 扩容量 改进,且 训练算力/并行/吞吐等 infra 细节论文未披露。
原始链接
- arxiv_abs: https://arxiv.org/abs/2505.14683
- arxiv_pdf: https://arxiv.org/pdf/2505.14683
- github: https://github.com/bytedance-seed/BAGEL
- hf: https://huggingface.co/ByteDance-Seed/BAGEL-7B-MoT
- project_page: https://bagel-ai.org/
一手源存档(sources/)
- arxiv-2505.14683.pdf (arXiv 原文 PDF,不入 git)
- arxiv-2505.14683.txt
- readme.md
- hf-modelcard.md
- project-page.md