一句话定位
SiT(Scalable Interpolant Transformers)把 dit-scalable-diffusion-transformers 的 transformer 主干放进随机插值(stochastic interpolant)理论框架,让同一套架构可在「离散/连续时间 × score/velocity 目标 × VP/Linear/GVP 插值 × ODE/SDE 采样」之间自由切换,做了一次彻底的设计空间消融;在完全相同的参数量、结构与 GFLOPs 下逐尺寸碾压 DiT,ImageNet 256×256 取得 FID-50K 2.06、512×512 FID 2.62(均 cfg=1.5)。它由此成为后续 REPA / RAE 这条「表征对齐」研究线的标准 backbone 与 baseline。
背景与定位
2023 年 dit-scalable-diffusion-transformers(Peebles & Xie)证明了「把 U-Net 换成纯 transformer」可使扩散模型随算力良好 scaling。SiT 想回答一个更基础的问题:DiT 相对早期扩散模型的性能增益,究竟来自哪一部分设计? 论文把生成模型拆成四个正交的设计旋钮,逐一从「典型 DDPM」过渡到「插值模型」:
- 时间离散化:离散时间(DDPM 把训练时间网格与采样网格绑死)→ 连续时间;
- 学习对象(model prediction):预测噪声 / score
s(x,t)/ 速度场v(x,t); - 插值路径(interpolant):连接数据分布与高斯的
α_t, σ_t选择; - 采样器:确定性 ODE(probability-flow)vs 随机 SDE(reverse-time),以及 SDE 的扩散系数
w_t。
理论根基是 Albergo–Vanden-Eijnden 的随机插值框架(arXiv:2303.08797,统一 flow 与 diffusion)。该框架的关键松绑:标准 score-based 扩散(如 score-sde 的 VP-SDE)只在 t→∞ 才收敛到 N(0,I)、且 α_t/σ_t/w_t 都被前向 SDE 绑定;插值则在 t∈[0,1] 上令 x_t = α_t·x* + σ_t·ε 无偏精确地从数据插到高斯(α_0=σ_1=1, α_1=σ_0=0),三个系数互相解耦、且可在训练后再选。SiT 把这套理论第一次系统地落到 ImageNet 大规模 latent 生成上,证明每一步「离开扩散、走向插值」的移动都能稳定降 FID。相关前置工作:ddpm、score-sde、latent-diffusion-ldm(LDM/Stable Diffusion VAE)、Flow Matching(Lipman 2023)、Rectified Flow(Liu 2023)。
模型架构
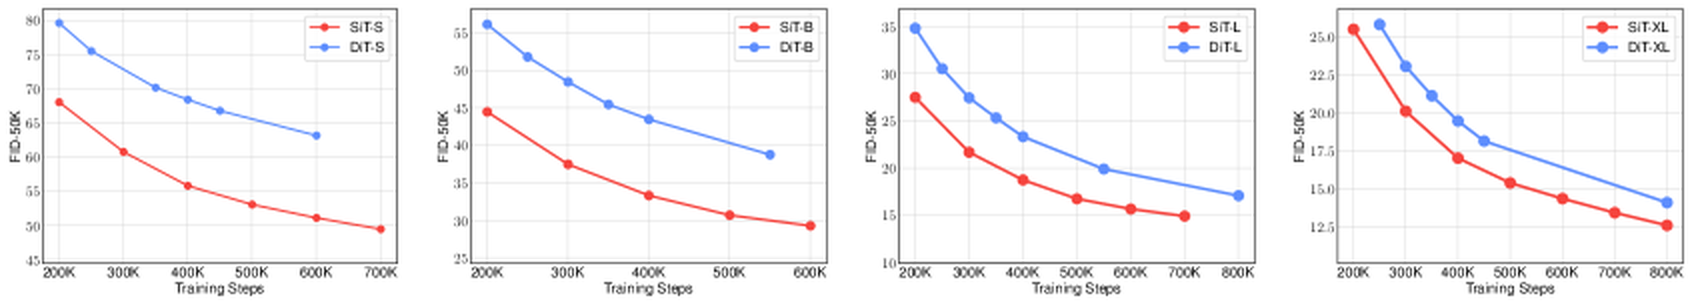
图源:SiT 论文 Figure 2(arXiv:2401.08740)。SiT(红)严格沿用 DiT(蓝)架构,四档尺寸 S/B/L/XL 下 FID-50K 随训练步全面更低、收敛更快——SiT 无独立框架图,此图最能体现其”同架构下的设计空间改动效果”。
严格沿用 DiT,不动一处结构,以排除任何 backbone 混淆因素——这是 SiT 论文方法论的核心约束(“exact same model structure, number of parameters, and GFLOPs”)。
- Backbone:DiT 式纯 transformer(ViT 风格),AdaLN-Zero 条件块注入时间
t与类别标签y;patch size 固定为 2(论文称 p=2 样本质量最好)。 - Latent 空间:与 LDM/Stable Diffusion 一致——用其预训练 VAE 把 256×256×3 图编码为 32×32×4 的 latent
z,在z上做生成,再 decode 回像素。SiT 本身不训练 VAE。 - Patchify + 位置编码:把 latent 切成 T 个 token,线性嵌入到维度 d,加标准 ViT 正弦位置编码,过 N 个 SiT block。
- 四档配置(与 DiT 完全对齐;层/宽/头见论文 Table 9,参数量见 Table 1):
- SiT-S:12 层 / hidden 384 / 6 头 / 33M 参数
- SiT-B:12 层 / hidden 768 / 12 头 / 130M
- SiT-L:24 层 / hidden 1024 / 16 头 / 458M
- SiT-XL:28 层 / hidden 1152 / 16 头 / 675M
- GFLOPs(官方 README):SiT-XL/2 @256 为 119 GFLOPs,@512 为 525 GFLOPs,与同名 DiT 配置一致。
- 关键设计选择:默认学习速度场
v(x,t)(而非 score),采样需要 score 时用解析关系s(x,t)=σ_t^{-1}·(α_t·v − α̇_t·x)/(α̇_t·σ_t − α_t·σ̇_t)反推(论文 Eq.9)。学v可规避σ_t→0在t=0处的σ_t^{-1}奇异,数值更稳。
数据
- 数据集:ImageNet-1K(class-conditional),分别在 256×256 与 512×512 分辨率训练。未使用任何额外数据。
- 预处理 / 增强:仅 0.5 概率随机水平翻转;论文明确「未用任何额外数据增强、未用梯度裁剪」。
- 配比 / 清洗 / re-caption / 合成数据:不适用——这是一个 class-conditional(标签条件、非文本条件)的方法学研究,无图文对、无 caption、无美学/安全过滤管线。数据维度对本工作而言极简,与同期 t2i 基础模型不可同日而语。
训练方法
目标函数(连续时间,T=1,无偏):
- 速度回归
L_v(θ)=∫₀¹ E‖v_θ(x_t,t) − α̇_t·x* − σ̇_t·ε‖² dt(Eq.7); - 或 score 回归
L_s(θ)=∫₀¹ E‖σ_t·s_θ(x_t,t) + ε‖² dt(Eq.6);可加时间权重λ(t)得加权 scoreL_{sλ}。 - 因为
T=1且插值无偏,不像大 T 的扩散那样依赖权重函数;权重在此反而可能引入数值不稳。
三种插值路径(Eq.11–12):
- SBDM-VP(复刻标准扩散):
α_t=e^{−½∫β_s ds},σ_t=√(1−e^{−∫β_s ds}); - Linear(rectified-flow 式):
α_t=1−t,σ_t=t; - GVP(generalized VP,全程恒定方差):
α_t=cos(½πt),σ_t=sin(½πt)。
逐步消融的核心结论(SiT-B、256、固定 400K 步,FID 越低越好):
| 移动 | 设置 | FID |
|---|---|---|
| 离散 DDPM 噪声目标 | baseline | 44.2 |
| 连续时间 + score | SBDM-VP, L_s | 43.6 |
| 加权 score | SBDM-VP, L_{sλ} | 39.1 |
| 改学速度 | SBDM-VP, L_v | 39.8 |
| 换 Linear 插值 | Linear, L_v | 34.8 |
| 换 GVP 插值 | GVP, L_v | 34.6 |
| 再换 SDE 采样 | GVP, L_v, SDE(w_t^KL) | 32.9 |
即:连续时间→加权→速度→线性/GVP 插值→SDE 采样,整体从 44.2 一路压到 32.9。绝大多数步骤都降 FID,但并非严格单调——加权 score(39.1)→改学速度(39.8) 这一步 FID 反而略升(论文只称
L_{sλ}/L_v相对裸L_s=43.6「显著提升」,未声称速度优于加权 score);改学速度的真正意义在于规避t=0处σ_t→0奇异、便于后续换插值与 SDE。降幅最大的两步是「换插值」(路径变直,transport cost / ODE 轨迹曲率下降,离散化误差小,从 39.8→34.8/34.6)与「换 SDE 采样」(34.6→32.9)。
可在训练后再调的扩散系数 w_t(SiT 的一大卖点):w_t 不影响 v/s,故无需重训即可改采样。论文给出 4 种选择并证明 w_t^{KL}=2(σ̇_t·σ_t − α̇_t·σ_t²/α_t) 能最小化 D_KL(p‖p_0) 上界(Eq.13);对 Linear 插值因 w_t^{KL}→∞ 改用代价正则版 w_t^{KL,η}(Eq.14)。SiT-XL 的最优组合:velocity + Linear 插值 + w_t^{KL,η} SDE 采样。
Classifier-Free Guidance:把 guidance 推广到速度场——v^ζ = ζ·v(x,t;y) + (1−ζ)·v(x,t;∅),论文证明等价于采样 tempered 分布 p(x_t)·p(y|x_t)^ζ(与 score 模型 CFG 同源,附录 C)。XL 模型用 cfg 后 FID 从 8.3 级跃到 2.06。
训练超参(论文 Table,完全照搬 DiT、不调参):
- 优化器 AdamW,恒定学习率 1e-4,batch size 256;
- 无 warmup/decay 调度调整、无梯度裁剪、无 weight decay 调参;
- EMA 衰减 0.9999,所有指标均从 EMA 权重采样;
- SiT-XL/2 @256 训 7M 步,@512 训 3M 步(与 DiT 同设定)。
- 未涉及蒸馏 / consistency / LCM / 步数蒸馏 / 偏好对齐 / RLHF——这是纯学术 backbone 研究,不含这些工程加速。
Infra(训练 / 推理工程)
- 训练硬件:原始模型用 JAX 在 TPU 上训练。SiT-XL 在 TPU v4-64 pod 上约 6.8 iters/sec,论文称在相同配置下「略快于」DiT-XL 的 6.4 iters/sec(原文仅给数字、未解释提速来源——不宜臆测为「省掉协方差预测」)。具体总 TPU·小时未单列。
- 代码实现:训练用 JAX(参照 DiT PyTorch 代码移植),SDE 采样器参考 stochastic-interpolants / score_sde / CLD-SGM;ODE 的 Heun 二阶积分器直接用 JAX 库 diffrax。
- 官方 PyTorch 移植(github.com/willisma/SiT):用 PyTorch DDP 训练(
torchrun),权重从 JAX 直接 port;ODE 走torchdiffeq。README 注明 TPU 采样比 GPU 略差(TPU 2.15 vs GPU 2.06 FID)。增强项(Flash-Attention、torch.compile、AMP/bf16)在 README 里仍是 TODO,说明发布版未做这些推理加速。 - 采样推理:ODE 用二阶 Heun,SDE 用一阶 Euler-Maruyama;主实验 NFE=250(与 DDPM 250 步对齐做公平比较)。SDE 在
t=0附近做h=0.04的时间区间裁剪 + 单个长 last step,显著提升性能。ODE 在低 NFE 区收敛更快,SDE 在大算力预算下能到更低 FID(Fig.5)。
评测 benchmark(把效果讲清楚)
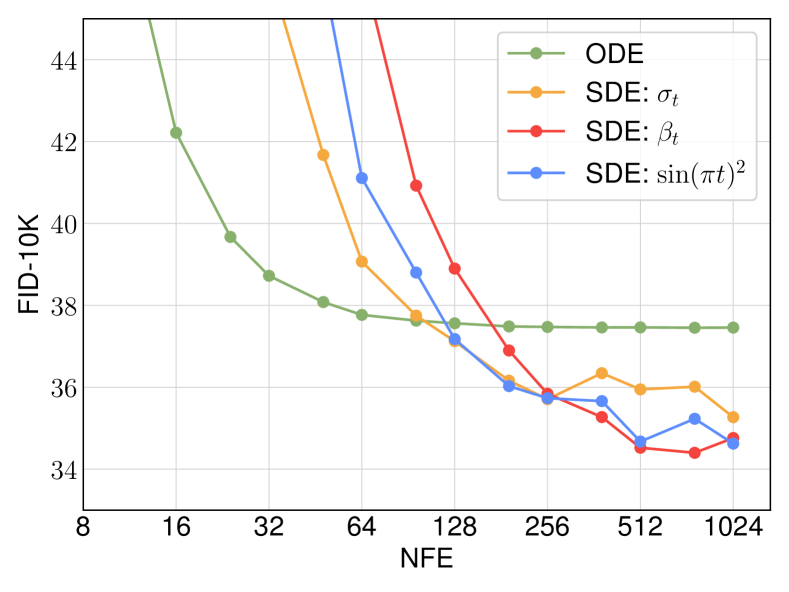
图源:SiT 论文 Figure 5(arXiv:2401.08740)。SiT-B + Linear 插值下,ODE(Heun)vs SDE(三种扩散系数 σ_t/β_t/sin²)的 FID-10K vs NFE:ODE 在低 NFE 收敛更快,SDE 在大算力预算下能到更低 FID。
全部数字来自论文正文 Table 1/7/8 与官方 README,ImageNet class-conditional、FID-50K(ADM TensorFlow 评测套件、GPU 采样)。
与 DiT 逐尺寸对比(400K 步,无 cfg,Euler-Maruyama 250 步):
| 模型 | 参数 | DiT FID | SiT FID |
|---|---|---|---|
| S | 33M | 68.4 | 57.6 |
| B | 130M | 43.5 | 33.0 |
| L | 458M | 23.3 | 18.8 |
| XL | 675M | 19.5 | 17.2 |
全量训练 + CFG(最终结果):
- ImageNet 256×256(SiT-XL,cfg=1.5,7M 步):
- ODE:FID 2.15 / sFID 4.60 / IS 258.09 / Prec 0.81 / Rec 0.60
- SDE:FID 2.06 / sFID 4.49 / IS 277.50 / Prec 0.83 / Rec 0.59
- 对照 DiT-XL(cfg=1.5):FID 2.27 / sFID 4.60 / IS 278.24。SiT-SDE 2.06 < DiT 2.27。
- 同期参考:VDM++ 2.12、StyleGAN-XL 2.30、ADM-G/U 3.94。
- ImageNet 512×512(SiT-XL,cfg=1.5,3M 步,SDE):FID 2.62 / sFID 4.18 / IS 252.21 / Prec 0.84 / Rec 0.57;对照 DiT-XL FID 3.04、VDM++ 2.65。SiT 在 512 上同样领先 DiT。
ODE vs SDE(Table 8,无 cfg):同一模型 SDE 全面优于 ODE(XL@7M:ODE 9.35 / SDE 8.26 FID),与理论「SDE 更好控制 KL」一致;SiT-XL@400K:ODE 18.04 / SDE 17.19。
官方发布 checkpoint(README):SiT-XL/2 @256,FID 2.06 / IS 270.27 / 119 GFLOPs(公开下载)。
关键消融结论汇总:(1) 性能增益主要来自插值路径变直(Linear/GVP 把 transport cost 与 ODE 轨迹曲率降下来)+ SDE 采样,而非架构;(2) 最优 w_t 同时依赖 model prediction 与插值类型,无单一最优;(3) 学速度优于学 score(避开 t=0 奇异)。
创新点与影响
核心贡献:
- 方法论拆解:把「DiT 为何强」拆成四个正交旋钮逐一消融,定量回答增益来源——这是少见的、对扩散/flow 设计空间的系统性实证研究。
- 随机插值首次大规模落地:在 ImageNet latent 生成上证明插值框架(连续时间、无偏
[0,1]路径、解耦的α/σ/w)优于经典 VP 扩散。 - 训练-采样解耦:
w_t与采样器可在训练后再选,无需重训即可换 ODE/SDE、调扩散系数、控 KL 上界,工程上极灵活。 - 零额外成本超越 DiT:同结构/同参/同 FLOPs 下 FID 全面更优,且收敛更快(Fig.2)。
影响:SiT 成为后续表征对齐研究线的事实标准 backbone 与 baseline——REPA(用外部视觉表征对齐加速 DiT/SiT 训练)、RAE 等都直接构建在 SiT 之上;其「velocity + Linear/GVP 插值 + SDE」配方也被大量后续 latent flow-matching 生成器沿用。它把「flow matching vs diffusion 谁更好」的争论落到可复现的同架构对照实验上,是连接扩散与 flow 两条技术线的关键桥梁工作。
已知局限:
- 仅在 ImageNet class-conditional 上验证,未做文本条件 t2i,无 caption/数据管线层面的贡献;
- 默认 NFE=250,未做步数蒸馏/一致性模型等推理加速(增益靠采样器与插值,而非更少步数);
- VAE 沿用 SD 现成件,未触及 tokenizer;512 分辨率训练步数(3M)少于 256(7M),两分辨率算力不完全对等;
- 发布实现未含 Flash-Attention / bf16 /
torch.compile(仍是 README TODO)。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2401.08740
- pdf: https://arxiv.org/pdf/2401.08740
- code (official PyTorch): https://github.com/willisma/SiT
- project page: https://scalable-interpolant.github.io/
- 理论基础: Stochastic Interpolants (Albergo et al., arXiv:2303.08797)
一手源存档(sources/)
- arxiv-2401.08740.pdf (arXiv 原文 PDF,不入 git)
- readme.md