一句话定位
Ming-Omni 是蚂蚁 Inclusion AI 的统一全模态模型:以 MoE LLM ling(Ling)为中枢,加”模态专属 router”,单模型同时感知 图像/文本/音频/视频并生成 文本/实时语音/图像;作者称其为”已知首个在模态支持上对齐 GPT-4o 的开源模型”。开源轻量版 Ming-Lite-Omni 仅激活 2.8B 参数即在图像理解上比肩 Qwen2.5-VL-7B,语音理解超 Qwen2.5-Omni / Kimi-Audio,图像生成 GenEval 0.64 / FID 4.85(FID 号称当时新 SOTA)。
背景与定位
构建统一 Omni-MLLM 的两大拦路虎:① 各模态表征空间不一致(representational disparity);② 各模态收敛速率不同(divergent convergence rates),联合训练时互相打架。Ming-Omni 的回答是:
- 用 MoE 而非 dense 做语言中枢,给不同模态各配一套 router(T/V/A-Router),让 token 流向各自擅长的专家,从架构层面缓解任务冲突。
- 借鉴 M2-omni(Guo et al., 2025)的平衡策略:预训练用 step-wise balance、指令微调用 dynamic adaptive balance(按各模态收敛速率动态调 loss 权重)来对齐训练进度。
- 感知与生成解耦:先把感知(理解)练扎实,再”冻结 MLLM 主体、只训生成模块”地接上语音 decoder 和图像 DiT,避免生成任务回头污染理解能力。
技术脉络上,它站在三条线交汇处:MoE LLM(Ling)、统一图像理解-生成(对标 janus-pro / Janus / TokenFlow / Emu3,但走”冻结 MLLM + 轻量桥接”而非共享视觉 token 空间路线)、端到端语音(沿用 Whisper 编码 + CosyVoice 式自回归 audio decoder)。图像生成部分直接复用同门工作 Ming-Lite-Uni,与 latent-diffusion-ldm 系 DiT 解码器对接。
模型架构
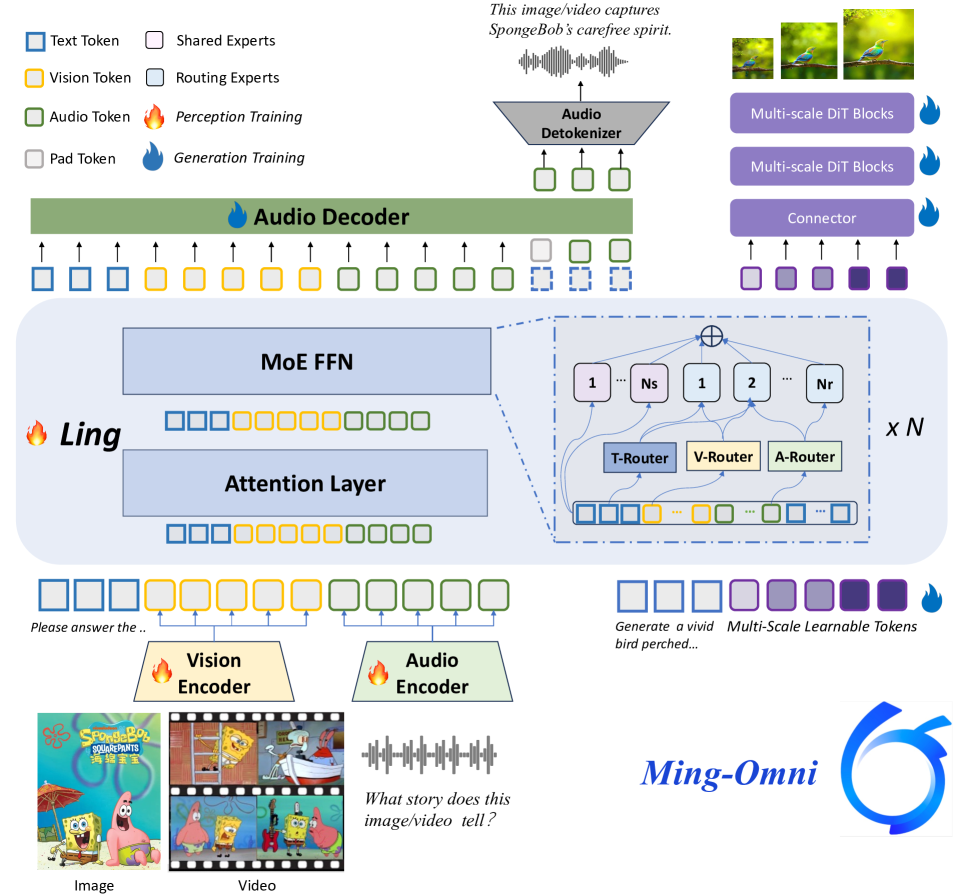
图源:Ming-Omni 论文 Figure 2 “The overall framework of Ming-Omni”(arXiv:2506.09344)
整体是”专属编码器 → Ling(MoE) → 专属生成解码器”的端到端框架(论文 Fig.2)。
语言中枢 Ling(MoE) — 据 HF config.json(bailing_moe):hidden 2048、28 层、注意力头 16、词表 126464;64 个 routing experts + 2 个 shared experts,每 token 激活 6 个 routing expert(num_experts_per_tok=6),first_k_dense_replace=0(全层 MoE)。轻量版基座为 Ling-lite,对外口径”2.8B 激活参数”(Ling-lite 公开为 ~16.8B 总参 / ~2.75B 激活的 MoE)。
- 模态专属 router:在标准 MoE router 之外,按 token 类型(文本 T / 视觉 V / 音频 A)走不同的路由分布,让每种模态 token 被送到专门化的专家,提升路由精度与效率——这是论文主打的架构创新点。
视觉编码器 — 采用 Qwen2.5-VL 的 vision backbone(config.json 中 qwen2_5_vit,hidden 1280,约 675M 参数),支持任意分辨率、图像与视频统一处理;理解侧保留其结构但在图文/视频上联合重训。视觉 embedding 经投影对齐到 Ling 维度后,与文本 token 拼接送入 LLM。
音频编码器 — 沿用 Whisper(Radford et al., 2023),后接一个 linear + 卷积下采样层把音频特征投到 Ling 隐空间。
语音生成(audio decoder) — follow CosyVoice,接在 LLM 输出端,是自回归架构,生成由 audio tokenizer 抽取的离散音频 token,再经 audio detokenizer 还原波形。两点关键设计:
- 不直接以离散音频 token 为目标,而是对其再做 BPE:把 token 帧率从 50Hz 压到 ~32Hz(长度压缩 36%),可逆无损,既提效又因学到组合信息而改善韵律(prosody);
- follow Qwen2.5-Omni,把 MLLM 对原始输入的 hidden state 喂给 audio decoder,让语音捕获情绪/环境等副语言信息。
图像生成(DiT 桥接) — 不走”共享视觉 token 空间”,而是保持 MLLM 冻结、用一个轻量桥接框架由粗到细生成:
- Multi-Scale Learnable Tokens:预设若干尺度 S(如 4×4 / 8×8 / 16×16),每个尺度配一组可学习 query token,分别负责全局布局与配色、主要物体与中层结构、精细纹理;每个尺度加可学习的 start/end 边界标记与尺度专属位置编码,拼接后进 transformer encoder。
- Multi-Scale Representation Alignment:把 DiT backbone 的中间 hidden state 与最终语义表征做 MSE 对齐,在 native-resolution 优化下实现理解-生成的隐式统一。
- 一个专用 connector 把 MLLM 产出的 latent 与 diffusion decoder 打通,让生成借用 MLLM 的语义理解。细节归并到同门 Ming-Lite-Uni。支持原生分辨率 T2I、指令式编辑(编辑/增删物体/换色/换动作)与风格迁移。
数据
论文 Sec.3 与 Fig.6 给出逐阶段配比(罕见地公开了量级),分预训练(PT)三段 + 指令微调(IT)三段:
| 阶段 | Image-Text | Audio-Text | Text | Video-Text / 其他 |
|---|---|---|---|---|
| PT-Stage-1 | 885M | 389k 小时 | — | — |
| PT-Stage-2 | 576M | 389k 小时 | 494M | — |
| PT-Stage-3 | 613M | 266k 小时 | 494M | Video-Text 9M |
| IT-Stage-1 | 31.7M | 330k 小时 | 14.6M | — |
| IT-Stage-2 | 35.7M | 400k 小时 | 15.5M | Video-Text 4.3M |
| IT-Stage-3 | 36.3M | 521k 小时 | 15.5M | Video 4.3M, Audio-QA 8.3M |
图像理解数据(多管线自造 + 公开集):
- Caption:聚合 Wukong / LAION / DenseFusion / ZERO-250M / COYO-700M 等 + 自有。提出 iterative self-evolving 数据精炼框架(受 DiverseEvol / ASK-LLM 启发):把全量切成 T 份,用上一轮模型给新切片打分,超阈值样本再经 MLLM 质量评定保留,逐轮扩充数据池并重训——在提质的同时显著减量。
- Structured(受 InfoSeek 启发):抽实体→linking 模型组织知识库→按知识三元组合成信息检索式 QA,注入细粒度知识。
- Encyclopedia:覆盖 8 个领域(植物/动物/名人/动漫/艺术品/食材/菜肴/车辆),学术库+机构站取实体→搜图→CLIP 一致性+MLLM 二分校验+人工精修的渐进过滤。
- GUI:AitW / GUICourse / AndroidControl,并用 MLLM 优化每步推理过程再交叉复核。
- Reasoning:文本 CoT 来自 Ling,多模态 CoT 来自 R1-Onevision。
- Preference(对齐阶段):来自 App 对话/搜索 query/高质量指令集,含 9 大域 41 个子类。
图像生成数据:follow Ming-Lite-Uni,来自公开生成/编辑集(InstructPix2Pix-clip-filtered、SEED-Data-Edit-part2/3、UltraEdit 等)+ 风格迁移数据(StyleBooth、WikiArt 采样)。
音频数据:开源集 + 自有 web/合成。Web 数据走”关键词扩展爬取 → VAD 切短 clip → 迭代训练 audio labeler 打标”的管线。消融发现:英文 clip 多于中文可显著提升英文理解而不损中文;方言数据仅占 ~2%,再加方言数据收益即饱和。
视频数据:VideoGPT+ / Vript / Openvid-1M / Youku-mPLUG-10M 等 + 中英网站,follow LLaVA-Video 用分层标注渐进生成 dense caption、开放式 QA、多选 QA。
文本数据:来自 Ling 与 M2-omni。
训练方法
两大阶段:感知训练(perception)→ 生成训练(generation)。
感知训练(与 M2-omni pipeline 一致)= 预训练 + 指令微调 + 对齐微调;预训练与指令微调各自再分 3 个子阶段,每子阶段增量引入更多任务(见上表配比)。平衡策略:预训练 step-wise balance、指令微调 dynamic adaptive balance(按收敛速率动态调 loss 权重);对齐阶段用 preference 数据。语音理解上还有两个 trick:把场景/环境等 metadata 选择性写进指令 prompt 提供上下文线索;让模型先预测输入音频的 language id 再做下游 ASR——显著提升方言识别。
生成训练(冻结多模态感知 LLM,只训新增生成组件,两条并行任务):
- 图像生成:只训新增的 connector + multi-scale learnable queries + DiT blocks;目标含 multi-scale representation alignment 的 MSE 对齐损失(具体扩散/flow 目标归并到 Ming-Lite-Uni,本报告未单列)。
- 语音生成(TTS):只训 audio decoder。两阶段策略——第一阶段练理解、第二阶段专攻生成质量,避免理解与生成互相干扰(论文明确指出 Qwen2.5-Omni 式联合训练会让两者难同时优化,故此处冻结 MLLM 主体)。用 TTS 数据 + 多模态上下文感知三元组数据训练。
(蒸馏/一致性加速等:本报告未报告。)
Infra(训练 / 推理工程)
未披露训练算力规模、GPU·时、并行/分布式与吞吐等具体数字。可确认的工程信息来自 HF 模型卡:
- 推理硬件:在 NVIDIA H800-80GB / CUDA 12.2 上测试;以 bfloat16 加载约占 40,890MB 显存(约 40GB,单卡可跑)。
- 依赖
diffusers==0.33.0、matcha-tts、transformers(自定义BailingMMNativeForConditionalGeneration/bailingmm)。 - 语音侧的 BPE(50Hz→~32Hz,长度 -36%)属推理/训练双向提效的工程手段,可逆无损。
- 部署形态:HF + ModelScope 开放权重(MIT 许可),自带图像生成/编辑的
generate接口。
评测 benchmark(把效果讲清楚)
评测对象为轻量版 Ming-Lite-Omni(2.8B 激活),覆盖 50+ 公开 benchmark,对手多为 <10B MLLM。数字均取自已抓取的一手源(论文 Table 1–12 与 HF 模型卡表格)。
图像理解(OpenCompass 图文,Table 1):AI2D 83.1 / HallusionBench 55.0 / MMBench-V11 80.8 / MMMU 56.3 / MMStar 64.7 / MMVet 71.3 / MathVista 71.6 / OCRBench 88.4;均值 71.4,基本与 Qwen2.5-VL-7B(71.5)打平,MathVista、OCRBench、HallusionBench 反超。
- Grounding(Table 2):RefCOCO/+/g 平均 87.3,与 Qwen2.5-Omni-7B(87.7)/Qwen2.5-VL-7B(86.6) 同档。
- GUI(Table 3):ScreenSpot 82.1、ScreenSpot-V2 84.1、AITZ(EM) 66.6——比 InternVL3-8B +2.6/+2.7,AITZ 比复现的 Qwen2.5-VL-7B +9.0。
- Info-Seeking(Table 4,InfoSeek):H-mean 27.7、unseen-question 30.4、unseen-entity 25.4,比 Qwen2.5-VL-32B 等更大模型仍 +7~10(但低于 GPT-4o 的 36.05)。
- OCR(Table 6):ChartQA 85.1、DocVQA 93.0、TextVQA 82.8、OCRBench-v2 53.3/52.0(en/zh);略逊 Qwen2.5-VL-7B。
- Encyclopedia(自建,Table 7):均值比 Qwen2.5-VL-7B +5.2(模型卡口径含 General 后均值 58.54 vs 54.43)。
- Human Preference(自建,Table 9):均分 4.296 略高于 Qwen2.5-VL-7B(4.274)。
图像生成(Table 5 / 模型卡 “Unified Generation”):
- GenEval 总分 0.64(模型卡最终值;论文 Table 5 含逐项:single 0.99 / two 0.77 / count 0.68 / colors 0.78 / position 0.31 / color-attr 0.29);与 JanusFlow(0.63)/JanusPro-7B 同档,略高于 SDXL(0.55)。
- DPG-Bench 81.72;FID 4.85(↓越好),优于 SDXL(8.76)、Janus(10.10)、JanusFlow(9.51)、Emu3-Gen,论文称当时新 SOTA。
- 作者说明 GenEval 略低于 JanusPro 是因后者用了 prompt rewrite,而本文用原始 prompt;并强调统一框架带来的编辑/风格迁移泛化是纯生成基线不具备的。
语音理解(Table 10,WER↓):中文均值 3.89、英文均值 4.08,整体优于 Qwen2.5-Omni(中 4.05 / 英 5.04);在内部多方言/多领域测试集上均值 5.45 远低于 Qwen2.5-Omni(14.79)/Kimi-Audio(23.24),方言鲁棒性突出。公开 13 项中拿下 6 项 SOTA。
- 语音 QA(Table 11):综合均分 4.34(AlpacaEval 4.63 / CommonEval 4.06),居全表第一,超 Kimi-Audio(4.215)、Qwen2.5-Omni(4.21);但 MMSU(47.53)/OpenBookQA(61.98) 等知识型不及 Kimi-Audio。
语音生成(Table 12,Seed-TTS-Eval):Zh-WER 1.69 / Zh-sim 0.68 / En-WER 4.31 / En-sim 0.51;与 SeedTTS/CosyVoice2/F5-TTS 等专用 TTS 同档(WER 略高、sim 略低),属”统一模型也能做 TTS”的可用水平。
视频理解(Table 8,128 帧):MVBench 67.7 / VideoMME 67.0 / VideoMMMU 46.3 / LongVideoBench 56.6;均值 59.4,微超 Qwen2.5-VL-7B(59.2),LongVideoBench +1.9 长视频占优。
关键消融结论:① audio decoder 与 MLLM 联合训会两难,故冻结 MLLM 单训 decoder;② 音频 BPE 压 36% 无损提效且改善韵律;③ ASR 前先预测 language id 显著提升方言;④ caption 自演化精炼可减量提质;⑤ 英文 clip 多于中文不损中文、方言 2% 即饱和。
创新点与影响
核心贡献:
- 模态专属 router 的 Omni-MoE:在 MoE LLM 上按模态分流 token,从架构层面缓解多模态任务冲突与收敛速率差异(配合 step-wise / dynamic-adaptive 平衡)。
- 首个对齐 GPT-4o 模态支持的开源 Omni 模型(作者口径):输入图/文/音/视、输出文/实时语音/图,全开源代码+权重(MIT)。
- “冻结 MLLM + 轻量桥接”的统一生成路线:图像侧 multi-scale learnable token + 表征对齐 + connector 接 DiT,避免共享视觉 token 空间常见的”提升一头损另一头”,保住理解能力的同时拿到 FID 4.85;语音侧 BPE 压帧率 + 两阶段冻结训练。
- 极致性价比:仅 2.8B 激活即逼近 7B dense 全模态对手。
影响:开源 Omni 阵营继 Qwen2.5-Omni 之后又一重要参考实现,提供了”MoE 中枢 + 模态 router + 解耦生成”的可复现范式;后续蚂蚁迭代出 Ming-lite-omni v1.5(2025.07)与 Ming-flash-omni 2.0(基于 Ling-2.0,100B 总参 / 6B 激活),印证该架构的可扩展性。
已知局限:① 真正”共享特征空间”的理解-生成统一仍未解决,本版坦言用冻结+桥接是折中,留待 future version;② 训练 infra/算力细节未披露,难评估复现成本;③ OCR、TTS 自然度、语音知识型 QA 等仍略逊各自专用 SOTA;④ 图像生成的扩散目标/步数等细节外包给 Ming-Lite-Uni,本报告未自洽给全。
原始链接
- arxiv_abs: https://arxiv.org/abs/2506.09344
- arxiv_pdf: https://arxiv.org/pdf/2506.09344
- github: https://github.com/inclusionAI/Ming
- hf_model_card: https://huggingface.co/inclusionAI/Ming-Lite-Omni
- modelscope: https://www.modelscope.cn/models/inclusionAI/Ming-Lite-Omni
- project_page: https://lucaria-academy.github.io/Ming-Omni/
一手源存档(sources/)
- arxiv-2506.09344.pdf (技术报告全文,已精读;PDF 不入 git)
- hf-modelcard.md (HF Ming-Lite-Omni 模型卡,含完整 benchmark 表 + 用法)
- github-readme.md (inclusionAI/Ming 仓库 README,现为 Ming-flash-omni 2.0,含版本时间线)
- project-page.md (项目主页快照)
- HF
inclusionAI/Ming-Lite-Omni的config.json(直接拉取自 https://huggingface.co/inclusionAI/Ming-Lite-Omni/resolve/main/config.json 核对):llm_config=bailing_moe,hidden 2048 / 28 层 / 16 头 / vocab 126464 / num_experts 64 / num_shared_experts 2 / num_experts_per_tok 6 / first_k_dense_replace 0;vision_config=qwen2_5_vit(hidden 1280)——结论已写入正文(未单独落盘,可按上述 URL 复现)