一句话定位
MAR(Masked Autoregressive)用一个小 MLP 上的逐 token 扩散过程(Diffusion Loss)取代了自回归图像生成里的 VQ 量化器与 cross-entropy 分类头,证明”自回归 ≠ 必须离散 token”,在连续值 token 空间做”下一组 token 预测”,于 ImageNet 256×256 达到 FID 1.55(MAR-H, w/ CFG)、并能 <0.3 秒/张 且 FID <2.0,开创了”连续 token 自回归”范式。
背景与定位
长期以来主流认知是:把语言模型那套自回归(next-token prediction)搬到图像,必须先用向量量化(VQ)把图像离散成有限词表的 token(VQ-VAE/VQ-GAN,vq-vae taming-transformers-vqgan),才能用 categorical 分布 + 交叉熵建模。但 VQ tokenizer 难训、对梯度近似策略敏感、重建质量逊于连续值 tokenizer(如 latent-diffusion-ldm 的 KL-16)。
本文提出的核心问题:自回归是否必须绑定向量量化? 作者指出自回归的本质是”基于已知 token 预测下一个 token 的概率分布”,这与 token 取值是离散还是连续正交。需要的只是两件事——(i) 一个能度量预测分布与真实分布差异的损失函数;(ii) 一个能从该分布采样的采样器。离散 token 用 categorical 分布天然满足这两点,但并非概念上必需。
作者的答案:用扩散过程来建模每个 token 的条件分布 p(x|z),从而把自回归直接搬到连续值域,彻底去掉 VQ。这与 latent-diffusion-ldm/dit-scalable-diffusion-transformers 这类”用一个扩散过程建模所有 token 的联合分布”形成鲜明对照——MAR 把”token 之间的依赖”交给自回归、把”每个 token 自身的分布”交给扩散,二者分工。相关同期工作 GIVT 也做连续 token 序列模型,但用固定数目的高斯混合(GMM)建分布,表达力受限;MAR 用扩散建任意分布。技术脉络上 MAR 是 MAE/MAGE(掩码生成,作者前作)与 DDPM/DiT(扩散)的合流。
模型架构
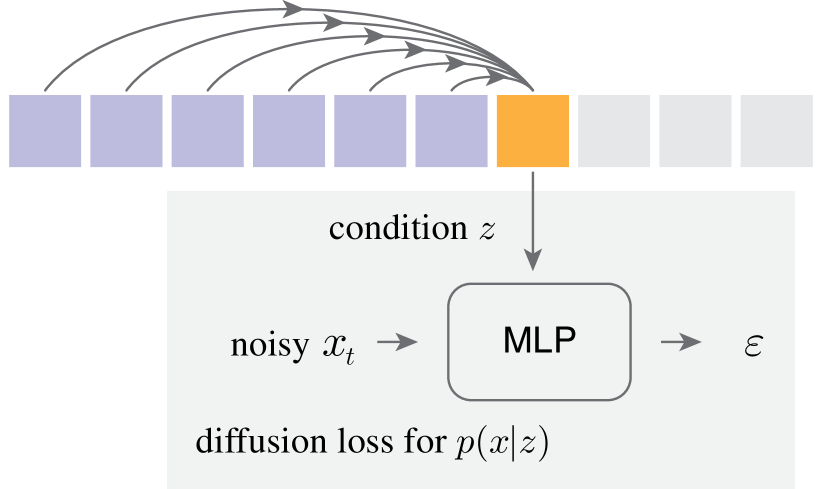
图源:Figure 1 “Diffusion Loss”, Li et al., Autoregressive Image Generation without Vector Quantization (arXiv:2406.11838)
三件套:连续值 tokenizer + 自回归/掩码自回归 Transformer + 小扩散 MLP(Diffusion Loss head)。
- Tokenizer / VAE:直接用 LDM 公开的 KL-16(连续值,KL 正则的 VAE,stride 16,无量化);对照实验也用其 VQ-16、KL-8、OpenAI Consistency Decoder。256×256 图经 KL-16 得 16×16=256 个 token,每 token 是 16 维连续向量。不自训 tokenizer——这也是论文承认的局限(系统质量受限于现成 tokenizer)。
- 主干 Transformer:沿用 ViT 实现。默认 -L(32 块、宽 1024,约 400M / 正文给 407M)。三档规模见下表。
- 统一 AR 与掩码生成(关键设计):论文论证”双向注意力也能做自回归”。
- AR 基线:causal 注意力 + 三角 mask(GPT 式),推理用 kv-cache 加速。
- MAR(默认):MAE 式双向注意力——encoder 先编码已知 token,再拼接带位置嵌入的 mask token,过 decoder,仅在未知位置算 loss。允许全注意力跨 token 通信,质量远好于 causal;代价是不能用 kv-cache,但可一步预测多 token 来换速度。
- 推理时 MAR 做”下一组 token 预测”:按 cosine 调度把掩码比从 1.0 降到 0,默认 64 步;始终用完全随机顺序(区别于 MaskGIT/MAGE 的 on-the-fly 置信度选位),从而训练/推理顺序分布一致,并支持逐 token 的 temperature 采样(像 GPT)。
- 实现细节:训练时掩码比在 [0.7, 1.0] 随机采;encoder 序列前固定 pad 64 个 [cls] token 提升稳定性与容量;为简洁 encoder/decoder 同尺寸、各占一半 block(MAR-L 各 16 块)。
- Diffusion Loss head(核心创新):一个小 MLP(默认 3 个残差块、宽 1024,约 21M,仅占 MAR-L ~5% 参数)。每块顺序为 LayerNorm → Linear → SiLU → Linear + 残差。MLP 以自回归网络输出的条件向量 z 为条件(z 加到扩散时间步 t 的 time embedding 上,经 AdaLN 注入),输入噪声化 token x_t,预测噪声 ε。这个小 MLP 概念上”就是一个可学习的损失函数”,与自回归主干联合反向传播训练。
三档规模(Table 4 设置,800 epochs):
| 模型 | Transformer 块/宽 | DiffLoss MLP 块/宽 | 参数量 |
|---|---|---|---|
| MAR-B | 24 / 768 | 6 / 1024 | 208M |
| MAR-L | 32 / 1024 | 8 / 1280 | 479M |
| MAR-H | 40 / 1280 | 12 / 1536 | 943M |
数据
- 训练数据:ImageNet(ImageNet-1K),类条件生成,分辨率 256×256(另有 512×512、64×64 实验)。纯学术数据集,无文本,无网络规模图文对。
- 数据增强极简:仅中心裁剪 + 随机翻转;正因增强简单,VAE latent 可预先缓存(caching VAE latents)加速训练。
- 论文明确把”在受控学术数据(ImageNet)上训练”列为局限:与海量数据训练的商用模型相比视觉质量仍有差距。无 re-captioning / 合成数据 / 美学或安全过滤等大规模文生图常见流程(本工作不是 T2I)。
训练方法
- 训练目标 = Diffusion Loss:L(z,x) = E_{ε,t}‖ε − ε_θ(x_t|t,z)‖²,即对每个 token 的去噪准则(DDPM 式,预测噪声 ε)。扩散过程跟随 improved-DDPM:cosine 噪声调度、训练 1000 步;可选加 variational lower bound 项 L_vlb。自回归主干的梯度由该 loss 反传到 z。
- t 多次采样 trick:因去噪 MLP 很小,对同一个 z 在训练时采样 t 共 4 次(
diffusion_batch_mul 4),不重算 z 就提高 loss 利用率。 - 采样器 + temperature:推理用反向扩散;temperature τ 通过缩放采样噪声 σ_t·δ 实现(采用 Karras 式做法),τ 像离散 AR 的温度一样显著影响 FID/IS(消融见 Fig.5),是 fidelity/diversity 关键旋钮。
- CFG(classifier-free guidance):训练时 10% 样本把类条件换成 dummy token;推理时跑 z_c 与 z_u 两路,按 ε = ε_θ(x_t|t,z_u) + ω·(ε_θ(x_t|t,z_c) − ε_θ(x_t|t,z_u)) 修正噪声,并用 Muse 式 CFG 调度(默认 linear schedule,逐模型 sweep 最优 ω 与 τ)。MAR-B/L/H 评测 cfg 分别约 2.9 / 3.0 / 3.2。
- 优化器/超参:AdamW(wd 0.02,β=(0.9, 0.95));batch size 2048,lr 8e-4,100 epoch 线性 warmup 后恒定 lr(DiffLoss 版用恒定调度,cross-entropy 对照用 cosine 更好);EMA 动量 0.9999。默认 400 epochs,Table 4 系统级结果训到 800 epochs,256 步自回归取最优。
- 无蒸馏/无 consistency/LCM/ADD 步数蒸馏——加速主要靠”一步多 token + 推理少步扩散”,不靠蒸馏。
- 关键消融/负面结果:直接对连续 token 用 L2/MSE 损失会崩(FID >100),因为 raster-AR 无随机性、MAR 仅顺序带来随机性、单点预测确定性 → 无法生成多样样本;必须用能建分布的 Diffusion Loss。
Infra(训练 / 推理工程)
- 算力:主训练在 16 台服务器 × 8× V100 GPU(共 128 卡 V100)。训练 400-epoch MAR-L 约 2.6 天;同集群同 epoch 数下 DiT-XL/2 需 4.6 天、LDM-4 需 9.5 天——MAR 训练显著更省。
- GitHub README 给出 H100 数据:默认 MAR-L(DiffLoss MLP 3 块/1024,400 epoch)约 1 天 7 小时 / 32× H100(batch 64);用缓存 VAE latent 后约 1 天 11 小时 / 16× H100(batch 128,近 2× 提速)。可选 gradient checkpointing 省显存。代码基于 MAE + MAGE + DiT,PyTorch DDP。
- 推理工程:去噪 MLP 极小,推理时扩散采样器只占整机 ~10% 时间;增大 MLP 宽度几乎无额外耗时(瓶颈在显存通信而非算力)。100 步扩散采样即足够(Fig.4),MAR-L 全程约 0.286–0.291 秒/张(A100,batch 256)。可把自回归步数从 256/64 降到 8–128 换更快推理。
- 速度/精度权衡:MAR(即便不用 kv-cache)比带 kv-cache 的 causal-AR 权衡更好;对比 DiT-XL(靠扩散步数控速)MAR 更快且更准——<0.3 秒/张 + FID <2.0。
评测 benchmark(把效果讲清楚)
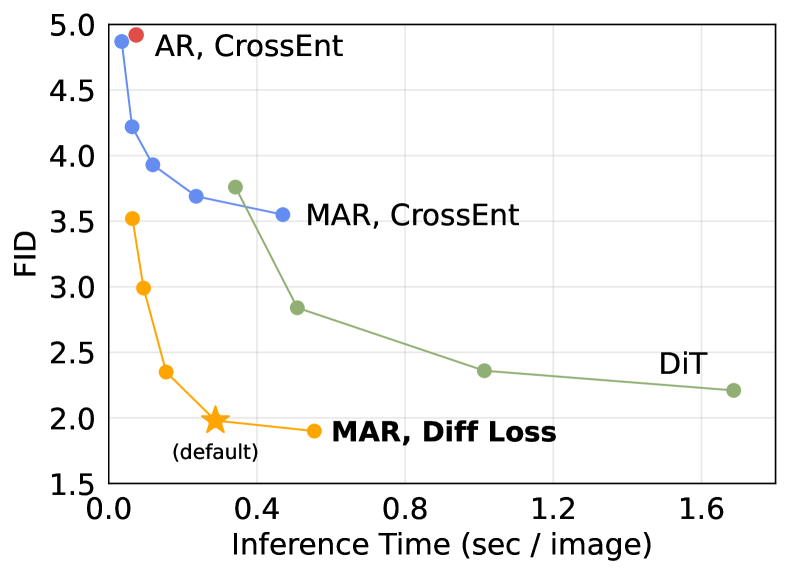
图源:Figure 7 “Speed/accuracy trade-off”(FID vs 推理耗时,MAR+DiffLoss 同时更快更准,优于 AR/MAR CrossEnt 与 DiT),arXiv:2406.11838
(1) Diffusion Loss vs Cross-entropy(Table 1,AR/MAR-L ~400M,400ep,256×256,w/ CFG)
- AR raster causal:CE 4.92 → DiffLoss 4.69 FID
- MAR rand causal:CE 4.36 → DiffLoss 4.07
- MAR rand bidirect 单 token:CE 3.50 → DiffLoss 1.84
- MAR 默认(>1 token/步,64 步):CE 3.69 → DiffLoss 1.98(IS 290.3)
- 默认 MAR 上 DiffLoss 相对 CE 降 FID ~50%–60%。
(2) 架构消融(w/o CFG,Table 1):raster→random order:FID 19.23→13.07;causal→bidirectional:13.07→3.43(巨大增益,证明全注意力价值)。
(3) tokenizer 灵活性(Table 2,MAR-L 400ep,w/ CFG):VQ-16(取量化前 latent)3.64;KL-16 1.98;KL-8(2×2 group)2.05;Consistency Decoder 3.23;自训 KL-16 1.97。同一 DiffLoss 下 VQ-16 因 rFID 5.87 远差于 KL-16 的 1.43,生成 FID 也差(7.82 vs 3.50 w/o CFG)。
(4) DiffLoss MLP 规模(Table 3,MAR-L 400ep,w/ CFG):宽 256/512/1024/1536 → FID 2.45/2.11/1.97/1.91,推理 0.286–0.291 秒/张——2M 的极小 MLP 已有竞争力。
(5) 系统级对比 ImageNet 256×256(Table 4,800ep):
- MAR-B(208M):FID 2.31(w/ CFG)/ 3.48(w/o),IS 281.7
- MAR-L(479M):FID 1.78 / 2.60,IS 296.0
- MAR-H(943M):FID 1.55 / 2.35,IS 303.7,Precision 0.81 / Recall 0.62
- 对照:DiT-XL/2 2.27、MDTv2-XL/2 1.58、MAGVIT-v2 1.78、LDM-4 3.60、GIVT 3.35。MAR-H 1.55 与最强系统持平/领先,且 w/o CFG 的 2.35 大幅超越其他 token-based 方法。
(6) ImageNet 512×512(Table 6,MAR-L,cfg 4.0):FID 2.74(w/o CFG)/ 1.73(w/ CFG),IS 279.9,竞争力强(对照 DiT-XL/2 3.04、EDM2-XXL 1.81、MaskGIT 7.32)。因资源未训 MAR-H。
(7) 像素空间无 tokenizer(附录 D.1):ImageNet 64×64,4×4 像素组成一 token,MAR-L 400ep 得 FID 2.93——证明可彻底去 tokenizer,但高分辨率像素直建计算昂贵。
(8) vs MAGE(附录 C):把 MAR 推理改成 MAGE 的 on-the-fly 置信度选位与简单随机顺序结果相近(CE 8.72 vs 8.79);但随机顺序 + 逐 token 温度采样使训练/推理一致,是 MAR 相对 MAGE 的概念优势。
(9) Fig.4/5/6:100 扩散步足够;温度 τ 显著影响 FID/IS;MAR+DiffLoss 在速度/精度曲线上优于 AR(kv-cache) 与 DiT。
创新点与影响
- 核心贡献:(1) Diffusion Loss——用小 MLP 上的逐 token 扩散过程作为可学习损失,建模连续 token 的任意条件分布,取代 categorical+CE,彻底去掉 VQ 量化器;(2) 统一 AR 与掩码生成为广义自回归(MAR)——双向注意力 + 完全随机顺序 + 一步多 token,兼得质量与速度;(3) 实证 ImageNet SOTA 级 FID(1.55)且训练/推理都比 DiT/LDM 省。
- 影响:开创”连续 token 自回归”范式,直接催生大量后续工作(如 var 之外的连续 token 路线、Fluid 把 MAR 扩到文生图、各类 unified 多模态生成把 DiffLoss/MAR 思路用于图像分支);为去 VQ、统一”理解+生成”的统一多模态模型提供了一条不依赖离散码本的技术路线。NeurIPS 2024 Spotlight。
- 已知局限(论文自陈):仍会产生明显伪影(Fig.8,与现有方法同);依赖现成 tokenizer,质量受其上限制约,未自训更好 tokenizer;受算力所限主要只在 ImageNet 验证,更大规模/真实世界场景(文生图、文生视频)的可扩展性与鲁棒性待验证。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2406.11838
- paper PDF: https://arxiv.org/pdf/2406.11838
- code (GitHub): https://github.com/LTH14/mar
- HuggingFace (社区移植 model card + demo): https://huggingface.co/jadechoghari/mar
一手源存档(sources/)
- arxiv-2406.11838.pdf (arXiv 原文 PDF,不入 git)
- readme.md