一句话定位
REPA(REPresentation Alignment)是一个极简的正则项:训练扩散/流匹配 transformer(DiT/SiT)时,把模型前几层的中间隐状态(来自含噪输入)通过一个小 MLP 投影后,去对齐一个预训练自监督视觉编码器(DINOv2)对干净图像的特征。仅此一项,就让 SiT-XL/2 训练提速 >17.5×(400K 步即达到 vanilla SiT 7M 步的无 CFG 水平),并把 ImageNet 256×256 的最终 FID 从 2.06 推到 1.42(带 CFG + guidance interval,SOTA)。
背景与定位
论文的核心观察是:扩散模型训练大模型的主要瓶颈,其实是”学不好表征”。
- 已有工作(Xiang et al. 2023 等)发现扩散 transformer 的隐状态里确实存在判别性表征(线性探测 acc 在中间层达到峰值),“更好的扩散模型学到更好的表征”。但作者用 CKNNA(一种基于互近邻的核对齐指标,Huh et al. 2024 提出,与 CKA 相关)量化后发现:SiT 学到的表征与 SOTA 自监督编码器 DINOv2 之间存在显著语义鸿沟,且二者对齐度很弱——即便训练到 7M 步、放大模型,对齐度提升仍缓慢、远低于其它自监督方法(如 MoCov3 vs DINOv2)之间的对齐水平。
- 由此引出动机:与其让扩散模型独立地慢慢学表征,不如直接把高质量外部表征”喂”进去。这接续了把扩散/去噪当作自监督表征学习(denoising score matching,Vincent 2011;Bengio et al. 2013)的视角,但指出”重建像素”这个任务本身不利于学好表征(无法剔除冗余细节,呼应 LeCun 2022 / JEPA 思路)。
- 在技术脉络中,REPA 站在 dit-scalable-diffusion-transformers(Peebles & Xie 2023)和 SiT(Ma et al. 2024,stochastic-interpolants 视角统一 flow/diffusion)之上,与”用外部表征加速扩散”的 Würstchen、RCG 等同属一脉,但不需要额外再训练一个表征生成模型——只是一个训练期正则,推理时投影头可丢弃。它也是后续 REPA-E(端到端联合训 VAE+对齐)以及 RAE(Representation Autoencoders)等工作的概念母版。
直接对接前置工作:ddpm、latent-diffusion-ldm(用其 SD-VAE 做 latent 压缩)、dit-scalable-diffusion-transformers、dinov2。
模型架构
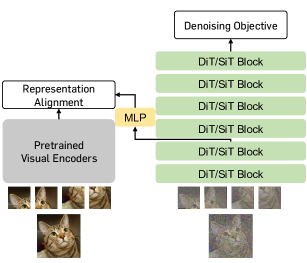
图源:REPA 论文 Figure 1(左),arXiv:2410.06940 “Representation Alignment for Generation: Training Diffusion Transformers Is Easier Than You Think”
REPA 不改 backbone 架构,严格沿用 DiT/SiT 的结构,只外挂一个对齐分支:
- Backbone:标准 DiT / SiT 纯 transformer(pure ViT-style,patch size = 2,无 U-Net skip)。三种配置(Table 1):
- B/2:12 层,hidden 768,12 heads(130M 参数)
- L/2:24 层,hidden 1024,16 heads(458M 参数)
- XL/2:28 层,hidden 1152,16 heads(675M 参数)
- Latent / VAE:用 Stable Diffusion 的 KL-VAE(
stabilityai/sd-vae-ft-ema),256×256 图像 →32×32×4latent;512×512 →64×64×4latent。REPA 操作在 latent 扩散上。 - 对齐目标编码器 f:预训练自监督视觉编码器,对干净图像 x*(不是含噪 latent)提取 patch 级特征
y* = f(x*) ∈ R^{N×D}。主用 DINOv2(B/L/g 均试),也验证了 MAE、MoCov3、I-JEPA、CLIP、SigLIP、DINO 等。注意:DINOv2 吃的是像素域干净图,需对位置编码做插值以匹配扩散 transformer 的 patch 数(论文仅明确:512 分辨率实验里把图 resize 到 448×448 喂 DINOv2;256 分辨率下喂 DINOv2 的具体输入分辨率论文未明示,只说做了位置编码插值)。 - 投影头 hϕ:一个 3 层 MLP + SiLU 激活,把扩散 transformer 第 8 层的隐状态
ht = fθ(zt)投影到与y*同维度R^{N×D},再逐 patch 对齐。该投影头只在训练用,推理时丢弃,故不增加推理成本。 - 关键架构洞察——只对齐前几层:REPA loss 只挂在前 8 层(实验扫了 6/8/10/12/14/16,挂 6 或 8 层 FID 最好)。作者解释:前几层负责把含噪输入对齐到语义丰富的外部表征,从而腾出后面的层去专注捕捉高频细节,反而提升生成质量。这是 REPA 一个反直觉但很重要的设计点。
- 条件注入:类别条件沿用 DiT/SiT 原生 adaLN 方式(论文未额外改动);text-to-image 实验改用 MMDiT(Esser et al. 2024,SD3 同款 joint attention)+ CLIP text encoder(hidden 768、24 层)。
数据
REPA 是方法类工作,不引入新数据集,也不做 re-captioning / 合成数据:
- 主实验:ImageNet-1K(Deng et al. 2009),256×256,按 ADM(Dhariwal & Nichol 2021)的预处理协议。每张图先用 SD-VAE 预编码成 latent 并预先缓存。
- 512×512 实验:ImageNet 512×512,latent
64×64×4。 - Text-to-image 实验:从头在 MS-COCO train split 上训练,val split 评测,沿用 U-ViT(Bao et al. 2023)的数据协议。
- 数据增强:因为 latent 是预计算缓存的,不做任何数据增强——作者指出这与 EDM2(Karras et al. 2024)的观察一致,影响很小。
- 配比 / 清洗 / 美学过滤 / 安全过滤:N/A(用的是标准公开数据集,无额外披露)。
训练方法
- 训练目标:保持原 backbone 目标不变,叠加 REPA 正则。
- SiT:linear stochastic interpolant + velocity prediction(
αt=1−t, σt=t,T=1)。 - DiT:Improved DDPM(Nichol & Dhariwal 2021)目标。
- 总损失:
L = L_velocity(或 L_diffusion) + λ · L_REPA。
- SiT:linear stochastic interpolant + velocity prediction(
- REPA 损失(式 8):逐 patch 最大化预训练表征
y*与投影后隐状态hϕ(ht)的相似度:L_REPA = −E[ (1/N) Σ_n sim(y*[n], hϕ(ht)[n]) ]。- 相似度函数对比了 NT-Xent(归一化温度交叉熵,对比学习式)和 负余弦相似度:NT-Xent 在早期(50–100K 步)略有优势,但后期差距消失,故最终用更简单的 cos. sim.。
- 关键超参 / trick(Appendix D):
- 优化器 AdamW,常数学习率 1e-4,(β1,β2)=(0.9,0.999),无 weight decay。
- 混合精度 fp16 + 梯度裁剪。
- batch size 256(与 DiT/SiT 对齐做公平比较)。
- λ = 0.5(默认);Table 5 消融显示对 λ 很鲁棒,0.25→1.0 FID 在 8.6→7.8 之间,λ≥0.5 后基本饱和。
- 对齐深度固定第 8 层;DINOv2 各尺寸(B/L/g)效果差别很小(作者归因于它们都从 DINOv2-g 蒸馏而来,表征相近)。
- 目标编码器质量 ↔ 生成质量强正相关:对齐到线性探测 acc 更高的编码器,FID 也更低(Table 2:MAE-L 12.5 → SigLIP-L 10.2 → DINOv2-B 9.7,对应 acc 57.3→68.8→65.7)。
- 采样器:SDE Euler-Maruyama(
wt=σt),默认 NFE=250;最后一步设 0.04(沿用 SiT 技巧,有明显提升)。 - 蒸馏 / 步数加速:REPA 本身不涉及 consistency/LCM/ADD 等步数蒸馏,正交于这类加速方法。
Infra(训练 / 推理工程)
- 算力:8× NVIDIA H100 80GB 即可完成全部实验(这是 REPA 一大卖点——把”训 SOTA DiT”的门槛大幅拉低)。
- 吞吐:batch size 256 下约 5.4 step/s;作者指出还可通过预计算预训练编码器特征进一步提速(论文里编码器特征是 on-the-fly 算的)。
- 混合精度:训练 fp16 + 梯度裁剪;评测时用 tf32(H100 或 4090Ti),与 fp32 差异可忽略。
- 代码栈:基于 SiT 官方实现,构建在 DiT / SiT / EDM2 / RCG 仓库之上;用 HuggingFace
accelerate启动,torchrun多卡生成(8 卡 × per-proc batch 64 出 50K 评测样本)。 - 推理成本:零额外开销——投影头 hϕ 与 DINOv2 仅训练期使用,推理时只跑原 backbone。
- 并行 / 分布式细节:除”8×H100、accelerate、batch 256”外未披露更细的并行策略(数据并行即可,模型本身不大)。
评测 benchmark(把效果讲清楚)
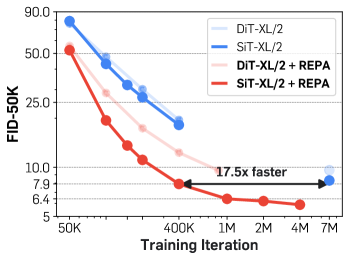
图源:REPA 论文 Figure 1(右),arXiv:2410.06940 —— FID-50K vs 训练迭代,SiT-XL/2+REPA 比 vanilla 快 17.5×
全部数字来自论文(Table 2/3/4/11/12),ImageNet 256×256,FID-50K,SDE Euler-Maruyama NFE=250:
1) 收敛加速与无 CFG FID(Table 3)
| 模型 | 参数 | 迭代 | FID↓ |
|---|---|---|---|
| SiT-XL/2 (vanilla) | 675M | 7M | 8.3 |
| SiT-XL/2 + REPA | 675M | 400K | 7.9 |
| SiT-XL/2 + REPA | 675M | 1M | 6.4 |
| SiT-XL/2 + REPA | 675M | 4M | 5.9 |
| DiT-XL/2 (vanilla) | 675M | 7M | 9.6 |
| DiT-XL/2 + REPA | 675M | 850K | 9.6 |
| SiT-L/2 + REPA | 458M | 400K | 9.7(vanilla 18.8) |
| SiT-B/2 + REPA | 130M | 400K | 24.4(vanilla 33.0) |
→ SiT-XL/2 仅 400K 步(FID 7.9)就超过 vanilla 跑 7M 步(8.3)的效果,即 >17.5× 加速。各尺寸全面改进,且模型越大相对收益越大(Fig 5b)。
2) 带 CFG 的 system-level SOTA(Table 4,ImageNet 256)
| 模型 | Epochs | FID↓ | sFID↓ | IS↑ | Pre↑ | Rec↑ |
|---|---|---|---|---|---|---|
| SiT-XL/2 (vanilla) | 1400 | 2.06 | 4.50 | 270.3 | 0.82 | 0.59 |
| SiT-XL/2 + REPA | 200 | 1.96 | 4.49 | 264.0 | 0.82 | 0.60 |
| SiT-XL/2 + REPA | 800 | 1.80 | 4.50 | 284.0 | 0.81 | 0.61 |
| SiT-XL/2 + REPA* | 800 | 1.42 | 4.70 | 305.7 | 0.80 | 0.65 |
→ 仅 200 epoch(vs vanilla 1400)就把 FID 压到 1.96,7× 更少 epoch 即超过原模型;800 epoch 达 1.80(CFG w=1.35);加 guidance interval 调度(Kynkäänniemi et al. 2024,* 标记)达 SOTA FID=1.42。对比 MDTv2-XL/2* 1.58、DiT-XL/2 2.27。
3) 512×512(Table 11,CFG w=1.35)
- SiT-XL/2 + REPA:200 epoch → FID 2.08(vanilla SiT-XL/2 600 epoch 才 2.62);100 epoch 已 2.32、80 epoch 2.44,即 >3× 更少迭代就在 FID/sFID/IS/Prec 四项超过 vanilla。
4) Text-to-image(MS-COCO,Table 12,从头训 150K 步,MMDiT depth-24 hidden-768 + CLIP text enc)
- ODE NFE=50:MMDiT 6.05 → +REPA 4.73;SDE NFE=250:5.30 → +REPA 4.14。证明即使已有 text 表征注入,对齐视觉表征仍有效。
关键消融结论
- 目标编码器越强 → FID 越低、线性探测 acc 越高(强正相关,Fig 5a)。
- 只挂前 8 层最优;挂更深层反而变差(Table 2:层 8 FID 10.0 → 层 16 FID 12.1)。
- DINOv2-B/L/g 差异微小;NT-Xent 仅早期略优,最终用 cos sim。
- λ 鲁棒(0.25–1.0),λ=0.5 后饱和。
- REPA 显著缩小所有噪声尺度(t=0/0.25/0.5)下的语义鸿沟、提高 CKNNA(Fig 7),且对 MAE/MoCov3 等多种目标编码器都能提升对齐(Fig 8)。
- 特征图 PCA 可视化(Fig 38):REPA 呈现 coarse-to-fine 结构,vanilla 在大 t 时特征图噪声大。
创新点与影响
核心贡献
- 诊断:“扩散 transformer 训练慢”的本质是中间层表征学得差、与 SOTA 自监督表征对齐弱——用 linear probing + CKNNA 给出量化证据。
- 方法:REPA——一个几乎零成本的训练期正则,逐 patch 把含噪隐状态投影对齐到 DINOv2 等干净图像表征;推理无额外开销。
- 反直觉设计:只对齐前几层(8 层)即足够,且让后层专注高频细节反而更好。
- 强结果:>17.5× 训练加速,ImageNet 256 SOTA FID 1.42,并在 512 与 T2I 上验证可扩展。
影响
- 直接催生 REPA-E(把 VAE 与对齐端到端联合训)、以及把”用表征引导生成”推向极致的 RAE(Representation Autoencoders)(本知识库索引中 RAE 页的概念父级)等一系列后续工作。
- 把”训出竞争力 DiT”的算力门槛拉到 8×H100 级别,对学术界友好;并为”统一判别与生成表征”提供了一个简单可复现的支点。
- 提供了一个通用插件式思路:任何强自监督编码器都能作为生成模型的”表征教师”。
已知局限
- 仅在 ImageNet / MS-COCO 类中等规模上验证;大规模、大数据 T2I 尚未验证(作者自己列为 future work)。
- 依赖一个外部预训练编码器(DINOv2),引入对该编码器质量的依赖;目标编码器需对位置编码插值以匹配 patch 数。
- 作者在 README 注明:开源代码因清理过程可能无法完全复现论文数字,会补 sanity-check。
- 不解决采样步数问题(正交于蒸馏类加速)。
原始链接
- paper (arXiv abs): https://arxiv.org/abs/2410.06940
- paper PDF: https://arxiv.org/pdf/2410.06940
- github: https://github.com/sihyun-yu/REPA
- project page: https://sihyun.me/REPA
- 会议: ICLR 2025(camera-ready)
一手源存档(sources/)
- arxiv-2410.06940.pdf (arXiv 原文 PDF,不入 git)
- readme.md