一句话定位
Chameleon 是 Meta FAIR 的早融合(early-fusion)、纯 token 化混合模态基座模型族(7B / 34B):把图像量化成离散 token,与文本 token 拼成同一序列,用单一从头训练的自回归 Transformer 端到端建模任意交错的图文文档,统一「理解 + 生成」。核心创新是用 QK-Norm + LayerNorm 重排 + z-loss 解决多模态共享权重下的训练发散问题;最亮眼结果是在新设计的「长文本混合模态开放生成」人评中,对 Gemini-Pro 取得 60.4%、对 GPT-4V 取得 51.6% 的胜率(增强基线下),图像描述(COCO/Flickr30k)达到 SOTA。
背景与定位
当时主流多模态模型(flamingo 式 late-fusion、llava 式独立视觉编码器、dall-e-2/dall-e-3 式独立图像解码器)都把模态分开建模——用 modality-specific encoder/decoder,再在后段融合。这限制了跨模态信息整合,也无法生成「任意交错图文」的完整多模态文档。
Chameleon 走的是早融合 + token-based 路线:所有模态(图像、文本、代码)从一开始就投影进同一表示空间,用同一套 Transformer 权重处理。技术脉络上它直接承接 token 化图像生成的谱系——dall-e-1(离散 token 自回归生成图像)→ CM3(causal-masked 混合模态)→ chameleon-cm3leon(CM3Leon,把该思路 scale 到自回归 T2I)→ Chameleon(把规模和稳定性进一步推到 34B / ~10T token,且是端到端 dense 模型,无路由)。
与最相似的 Gemini 相比:Gemini 也是早融合 token-based,但使用独立的图像解码器;Chameleon 是端到端 dense、无任何路由组件,因此对「理解」和「生成」两类任务更通用。代价是早融合带来严重的优化稳定性与表示学习挑战,这正是本文工程贡献的重点。
模型架构
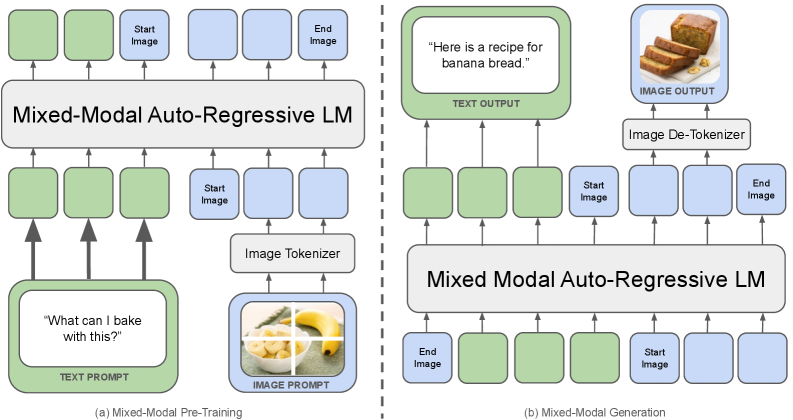
图源:Chameleon: Mixed-Modal Early-Fusion Foundation Models, Figure 1 (arXiv:2405.09818) https://arxiv.org/abs/2405.09818
- Backbone:自回归 decoder-only Transformer,架构主体沿用 llama-2(RMSNorm、SwiGLU 激活、RoPE 旋转位置编码)。两个规模:Chameleon-7B 与 Chameleon-34B,上下文长度 4k,未使用 GQA(见 Table 1)。
- 统一 token 空间:无独立的图像/文本编码器,也无 domain-specific 解码器;图像和文本 token 共享同一套 Transformer 权重,混在一条序列里做 next-token 自回归。
- 图像 tokenizer(visual tokenizer):基于 Make-A-Scene(Gafni et al., 2022)的 VQ 式 tokenizer,把 512×512 图像编码成 1024 个离散 token,codebook 大小 8192。训练 tokenizer 只用授权图像;因人脸生成重要,预训练时把含人脸图像上采样 2 倍。已知弱点:对含大量文字的图像重建差,这从根本上限制了模型的重 OCR 类能力。
- 文本/统一 tokenizer:在训练数据子集上新训一个 BPE tokenizer(sentencepiece),词表 65,536,其中包含 8192 个图像 codebook token。于是一条序列里图文 token 共用一个词表、一个 embedding 表、一个输出 softmax。
- 条件注入:没有 cross-attention,没有 adapter——条件即「上文 token」。图像生成由特殊的
<start-image>/<end-image>边界 token 触发,模型在这两者之间自回归吐出固定长度(1024 个)图像 token,再由 image de-tokenizer 还原成像素。 - 关键架构设计(稳定性核心):
- QK-Norm:对 attention 内 query/key 向量做 LayerNorm,直接抑制进入 softmax 的 norm 增长。论文发现共享权重下不同模态熵差异大,softmax 的平移不变性导致各模态「竞争」抬高 norm,最终在 bf16 表示范围外发散(即 logit drift 问题)。QK-Norm 是 7B/34B 都不可或缺的。
- Norm 重排(Swin 式 post-norm):Chameleon-34B 把 LLaMa 的 pre-norm 改成对子层输出做 norm 的形式——
h = x + attention_norm(attention(x))、output = h + ffn_norm(feed_forward(h))(对比 LLaMa-2 的x + attention(attention_norm(x)))。这能约束 SwiGLU(乘性)带来的 FFN 块 norm 增长。该重排与 dropout 不兼容,故 34B 不用 dropout。 - z-loss:对最终 softmax 的配分函数 Z 加
1e-5·log²Z正则,治理最终 softmax 的 logit shift(QK-Norm 只管内部 softmax)。
数据
预训练约 10T token(混合模态交错数据),分两阶段,前 80% 为第一阶段、后 20% 为第二阶段;对所有 text-image 对,50% 概率图在文前(即 captioning 方向)。
- 第一阶段(大规模无监督):
- Text-only:LLaMa-2 + CodeLLaMa 的预训练数据组合,共 2.9T 纯文本 token。
- Text-Image:公开来源 + 授权数据,图像 resize 并中心裁剪到 512×512 后 token 化;共 14 亿(1.4B)图文对,产出 1.5T 图文 token。
- Text/Image 交错:来自公开网络(明确不含 Meta 产品/服务数据),仿 OBELICS(Laurençon et al., 2023),共 400B 交错图文 token,图像过滤与 T2I 一致。
- 第二阶段:把第一阶段数据权重下调 50%,混入更高质量数据集(含一批指令微调集的过滤子集),同时维持相近的图文 token 比例。
- 清洗/过滤:图像统一 512×512 中心裁剪;tokenizer 训练只用授权图像;人脸图像上采样 2×。
SFT 数据(对齐阶段,见 Table 3) 分六类:Text(1.6M 样本 / 940M token,承自 LLaMa-2)、Code(14.1K / 1.1M,承自 CodeLLaMa)、Visual Chat(15.6K / 19.4M / 16.7K 图)、Image Generation(64.3K / 68.0M / 64.3K 图,从授权图按美学分类器(LAION 美学,Schuhmann et al.)筛分≥6 再取最接近 512×512 的 top-64K)、Interleaved Generation(16.9K / 35.8M / 30.7K 图)、Safety(95.3K / 38.6M / 1.6K 图,覆盖暴力、管制物品、隐私、色情等,含 LLaMa-2-Chat、Rainbow Teaming 合成、Pick-A-Pic 安全图、CyberSecEval 等)。Visual Chat 与 Interleaved 用第三方供应商高质量采集,明确不含 Meta 用户数据。
训练方法
- 训练目标:单一 next-token 自回归交叉熵(图文 token 同一目标)——非 diffusion、非 flow matching、非 masked-token。任意图文顺序(纯文本 / 单图文对 / 全交错文档)都用同一目标。
- 多阶段:预训练(两阶段数据配比,2.1 个 epoch,共看到 ~9.2T token)→ 轻量级 SFT 对齐(仿 LIMA,少量高质量数据)。论文未做 RLHF/DPO 等偏好对齐(只提到「进一步 RLHF/RLAIF 可继续加固安全」,未在本工作实施)。
- SFT 关键 trick:
- 模态平衡(Data Balancing):SFT 阶段若模态配对严重失衡,模型会学到「无条件先验地生成某模态」,导致某模态被压制或过度触发——故须刻意平衡。
- prompt token 上 mask loss、只在 answer token 上优化(略有增益);prompt 内图像 resize + 边框 padding(保信息),answer 内图像中心裁剪(保生成质量);cosine LR、初始 1e-5、weight decay 0.1、batch 128、seq 4096、dropout 0.05、沿用预训练 z-loss。
- 预训练超参(Table 1):AdamW(β1=0.9, β2=0.95, ε=1e-5),4000 步线性 warmup + 指数衰减到 0,weight decay 0.1,全局梯度裁剪 1.0,LR 均为 1.0e-4。Chameleon-7B 用 dropout 0.1 + z-loss + QK-Norm;Chameleon-34B 不用 dropout(用 norm 重排 + z-loss + QK-Norm)。7B 全局 batch ≈ 8M token(2^23),34B ≈ 12M token(3×2^22)。
- 稳定性发现:标准 LLaMa 架构在训练中后段(即便已跑 20–30%)会因缓慢 norm 增长而发散;监控最后一层输出 norm 的失控增长可强预测后续 loss 发散。关闭图像生成的消融(7B w/o image generation)则不发散——印证发散根源在多模态共享 softmax。
- 蒸馏/加速:本工作未涉及 consistency/LCM/ADD/步数蒸馏(这是自回归 token 生成,不是少步扩散范式)。
Infra(训练 / 推理工程)
- 算力(Table 2):预训练全程 NVIDIA A100 80GB。Chameleon-7B 用 1024 张并发 GPU、856,481 GPU·小时;Chameleon-34B 用 3072 张并发 GPU、4,282,407 GPU·小时(约 428 万 A100 小时)。预训练在 Meta RSC(Research Super Cluster,Quantum InfiniBand 互联),对齐在内部研究集群(Elastic Fabric 互联)。
- 精度:bf16(发散问题正是源于 norm 增长超出 bf16 有效表示范围)。
- 并行/分布式细节:论文未披露具体并行策略(TP/PP/FSDP 配置、吞吐数字未报告)。
- 推理工程:自建基于 PyTorch 的独立推理流水线,GPU kernel 用 xformers。混合模态自回归生成有三大独特挑战并对应优化:
- 逐步数据依赖:是生图还是生文取决于当前 token,须每步把 token 从 GPU 拷回 CPU(阻塞)来引导控制流;
- 模态约束掩码:仅生成某模态(如纯图)时,把不属于该模态空间的 token 掩掉,再 de-tokenize;用 token masking 消除 GPU 上的分支;
- 固定长度图像块:图像是固定 1024 token 的块,非流式时可「融合」生成整块、免逐步条件计算;流式时则每步需 token 相关的条件逻辑。支持文本与图像流式输出。
- 部署形态:作为研究 artifact 开源(GitHub facebookresearch/chameleon,含独立推理代码 + viewer + 人评 prompt 数据;另有 HF collection 与门控 checkpoint,需申请访问)。注:论文 PDF 描述的是完整图文生成能力;而公开释出的 checkpoint 仅保留图文理解 / 文本生成、关闭了图像生成——这是发布层面的限制(广泛报道,非 PDF 内陈述,本地未落盘一手发布说明,标注来源为 release 行为)。README/miniviewer 中较大模型以
30b命名(论文正文 safety 段亦混用 “30B”,与 Table 1/5 的 “34B” 同指一个模型)。
评测 benchmark(把效果讲清楚)
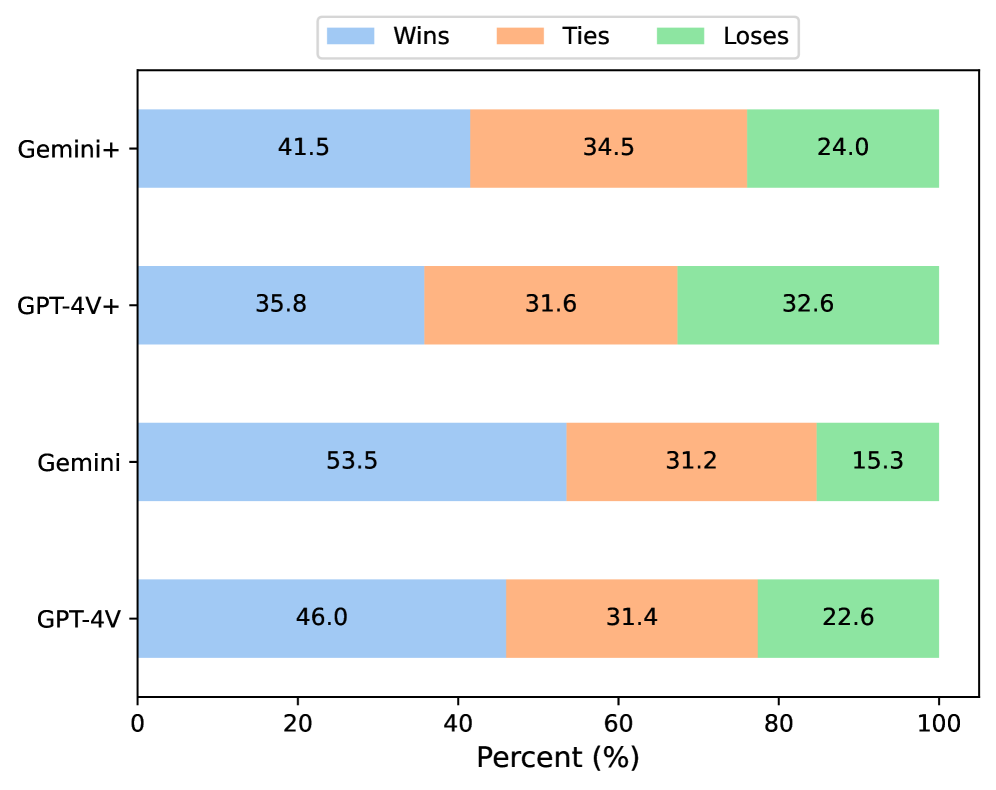
图源:Chameleon: Mixed-Modal Early-Fusion Foundation Models, Figure 9b(相对评测胜率 vs Gemini+/GPT-4V+/Gemini/GPT-4V)(arXiv:2405.09818) https://arxiv.org/abs/2405.09818
重要前提:因 Chameleon 能力太杂没有单一对标模型,论文按「每个子领域对标该领域最强模型」。图像生成质量未用 FID / GenEval / T2I-CompBench / MJHQ-30K / PickScore 等自动指标报告,仅通过人评衡量(源里无这些数字,故记「未报告」)。
文本(预训练模型,未 SFT,Table 6)——
- Commonsense/阅读理解(0-shot):Chameleon-34B 在 PIQA 83.3、SIQA 63.3、HellaSwag 82.7、WinoGrande 85.1、Arc-E 84.1、Arc-C 59.7、OBQA 54.0、BoolQ 86.0,在 5/8 任务上超过 Llama-2-70B,整体与 Mixtral 8x7B 持平。Chameleon-7B 全面优于 Llama-2-7B。
- 数学/知识:GSM8k——7B 41.6(maj@1)/ 50.9(maj@8,≈ Mistral-7B 52.1),34B 61.4(maj@1,超 Llama-2-70B 56.8)/ 77.0(maj@32,超 Mixtral 8x7B 75.1)。MATH——7B 11.5(maj@1)/ 12.9(maj@4),34B 22.5(maj@1)/ 24.7(maj@4,接近 Mixtral 28.4)。MMLU——7B 52.1,34B 65.8(接近 Mixtral 70.6 / Gemini-Pro 71.8)。结论:尽管为多模态付出代价,文本能力仍全面胜 Llama-2,逼近 Mistral/Mixtral;归因于多跑 2 epoch、加入代码数据、末 20% 高质量数据。
图像→文本(理解,Chameleon-34B,Table 7;CIDEr for COCO/Flickr30k,accuracy for VQAv2)——
- 图像描述 CIDEr(COCO Karpathy test):预训练 Chameleon-34B 120.2(2-shot),已超过 Flamingo-80B(32-shot 113.8)和 IDEFICS-80B(32-shot 116.6);微调变体 Chameleon-SFT 140.8(0-shot)、Chameleon-MultiTask 139.1(2-shot),均超过 Flamingo-80B-FT(138.1)与 IDEFICS-80B-Instruct(123.2),在开源预训练与微调两类里均为 COCO 上 SOTA。Flickr30k CIDEr:预训练 2-shot 74.7(与 Flamingo 75.1 / IDEFICS 73.7 持平),微调 SFT 82.3(2-shot)超过其他模型,MultiTask 76.2 接近(注:GPT-4V 8-shot 55.3、Gemini-Pro 4-shot 82.2*)。
- VQA-v2(test-dev,accuracy):预训练 Chameleon-34B 2-shot 66.0,匹配 Flamingo/IDEFICS 的 32-shot(67.6/65.9);微调 Chameleon-MultiTask 69.6(2-shot),接近 IDEFICS-80B-Instruct(68.8,32-shot)和 Gemini-Pro(71.2*),但落后 Flamingo-80B-FT(82.0)、GPT-4V(77.2)、Gemini Ultra(77.8)。论文称 Llava-1.5 在 VQAv2 上更高(得益于额外 GPT-4 对话/ShareGPT/GQA/区域级 VQA 微调),但其在其他任务显著落后——Table 7 未列 Llava-1.5 的具体数值,仅文字定性陈述。亮点:Chameleon 用**更少 in-context 样本(2-shot vs 32-shot)和更小模型(34B vs 80B)**就达到竞争力。
长文本混合模态开放生成(人评,本文新建的核心评测,Section 4)——
- 评测集:第三方众包 1,048 条自然 prompt(441 条 42.1% 混合模态、607 条 57.9% 纯文本),分 12 类任务。基线为 GPT-4V、Gemini-Pro(API 只能出文本),并构造增强基线 GPT-4V+/Gemini+(让其生成
<caption>,再用 DALL-E 3 配图替换)。 - 绝对评测(任务完成度):完全完成率 Chameleon 55.2% vs Gemini+ 37.6% vs GPT-4V+ 44.7%;对比原始 Gemini 17.6%、GPT-4V 23.1%(纯文本被视为只部分完成)。
- 相对评测(胜率,胜=1、平=0.5):对 Gemini+ 胜率 60.4%(41.5% 胜 / 34.5% 平 / 24.0% 负);对 GPT-4V+ 51.6%(35.8% / 31.6% / 32.6%);对原始 Gemini 69.1%、对原始 GPT-4V 61.7%。Chameleon 擅长 Brainstorming / Comparison / Hypothetical,在 Identification / Reasoning 偏弱。
- 安全(Table 5):2 万条众包 prompt,7B 安全率 99.2%(0.4% unsafe)、34B 99.7%(0.1% unsafe);445 条内部红队交互中 34B 安全 93.9%、unsafe 1.6%、unsure 4.5%。
- 关键消融:QK-Norm 是 7B/34B 稳定训练的必要条件(无之约 20% epoch 即发散,Fig 5b);34B 仅靠 dropout 不能稳,需 norm 重排(Fig 6c);关闭图像生成则不发散(Fig 6b),坐实多模态共享 softmax 为发散根因。
创新点与影响
- 核心贡献:(1) 首个把图文统一为离散 token、用单一从头训练的早融合自回归 Transformer 端到端建模任意交错图文文档的开源基座族,刷新开放多模态基座的标杆;(2) 提出使早融合 token-based 模型可稳定 scale 的架构与训练配方(QK-Norm + Swin 式 norm 重排 + z-loss),定位并解决多模态共享 softmax 的 logit-drift 发散;(3) 跨广谱视觉-语言基准达 SOTA 同时保持竞争性文本能力,且生成在同一模型内;(4) 首个大规模「开放式混合模态推理与生成」人评。
- 对后续工作的影响:Chameleon 成为「token-based 统一理解+生成」范式的代表与基线,直接启发后续早融合/统一自回归多模态工作(如 emu3、Transfusion、Show-o、Janus 等的对比与改进)。其稳定性配方(QK-Norm、z-loss、norm 重排)被广泛引用为大规模混合模态训练的标准技巧。
- 已知局限:(1) 图像 tokenizer 对含大量文字的图像重建差,重 OCR/图表理解能力受限(人评也刻意排除 OCR/Infographic 类);(2) 公开释出的权重关闭图像生成,外部难以直接复现其生成能力;(3) 未做偏好对齐(RLHF/DPO),仅轻量 SFT;(4) 图像生成质量缺乏标准自动指标(FID/GenEval 等)报告,只能靠人评,可比性弱;(5) 离散 token 化对图像是有损压缩,生成精细度受 codebook(8192)和分辨率(512²/1024 token)上限约束。
原始链接
- arxiv_abs: https://arxiv.org/abs/2405.09818
- arxiv_pdf: https://arxiv.org/pdf/2405.09818
- github: https://github.com/facebookresearch/chameleon
- hf_collection: https://huggingface.co/collections/facebook/chameleon-668da9663f80d483b4c61f58
- blog (Meta FAIR releases, 含 Chameleon): https://ai.meta.com/blog/meta-fair-research-new-releases/
- checkpoint download (gated): https://ai.meta.com/resources/models-and-libraries/chameleon-downloads
- (前身博客 CM3Leon,本地已存): https://ai.meta.com/blog/generative-ai-text-images-cm3leon/
一手源存档(sources/)
- arxiv-2405.09818.pdf (arXiv 原文 PDF,不入 git)
- chameleon-cm3leon—blog.md (前身 CM3Leon 官方博客,提供谱系背景)