一句话定位
Qwen2.5-Omni 是阿里 Qwen 团队 2025-03 推出的端到端全模态单一模型:同时感知文本/图像/音频/视频四种输入,并以流式方式同时输出文本与自然语音;核心创新是 Thinker-Talker 双脑架构(Thinker 出文本、Talker 出语音 token)与 TMRoPE 时间对齐位置编码(音视频逐帧时间戳对齐)。7B 版在 OmniBench 等多模态融合基准上拿到 SOTA(Avg 56.13%,远超 Gemini-1.5-Pro 的 42.91%),语音生成在 seed-tts-eval 上达到 test-zh/en/hard WER 1.42%/2.33%/6.54%(RL 后),优于 MaskGCT 与 CosyVoice 2。
背景与定位
此前 LLM 把视觉(LVLM)、听觉(LALM)分别端到端接入,但要在一个端到端模型里统一全部理解模态、并像人一样同时用文本流和语音流回应,仍是开放难题。报告点出三个关键挑战:
- 多模态联合训练 + 音视频时间同步——视频里画面和声音必须在时间轴上对齐;
- 多模态输出互不干扰——文本 token 与语音 token 同时生成时训练相互掣肘;
- 实时流式架构——低首包延迟地边理解边出语音。
Qwen2.5-Omni 的定位是 Qwen 系列的旗舰全模态开源模型,把 qwen2.5-vl 的视觉编码器、qwen2-audio 的音频编码器、Qwen2.5 的 LLM 三者整合进一个可端到端训练/推理的系统,并新增流式语音输出。它对标的是 OpenAI GPT-4o 这类闭源 omni 模型,而以完全开源(Apache-2.0,7B/3B 双尺寸 + GPTQ/AWQ 量化版)的形态发布,是开源全模态的代表性工作。
模型架构
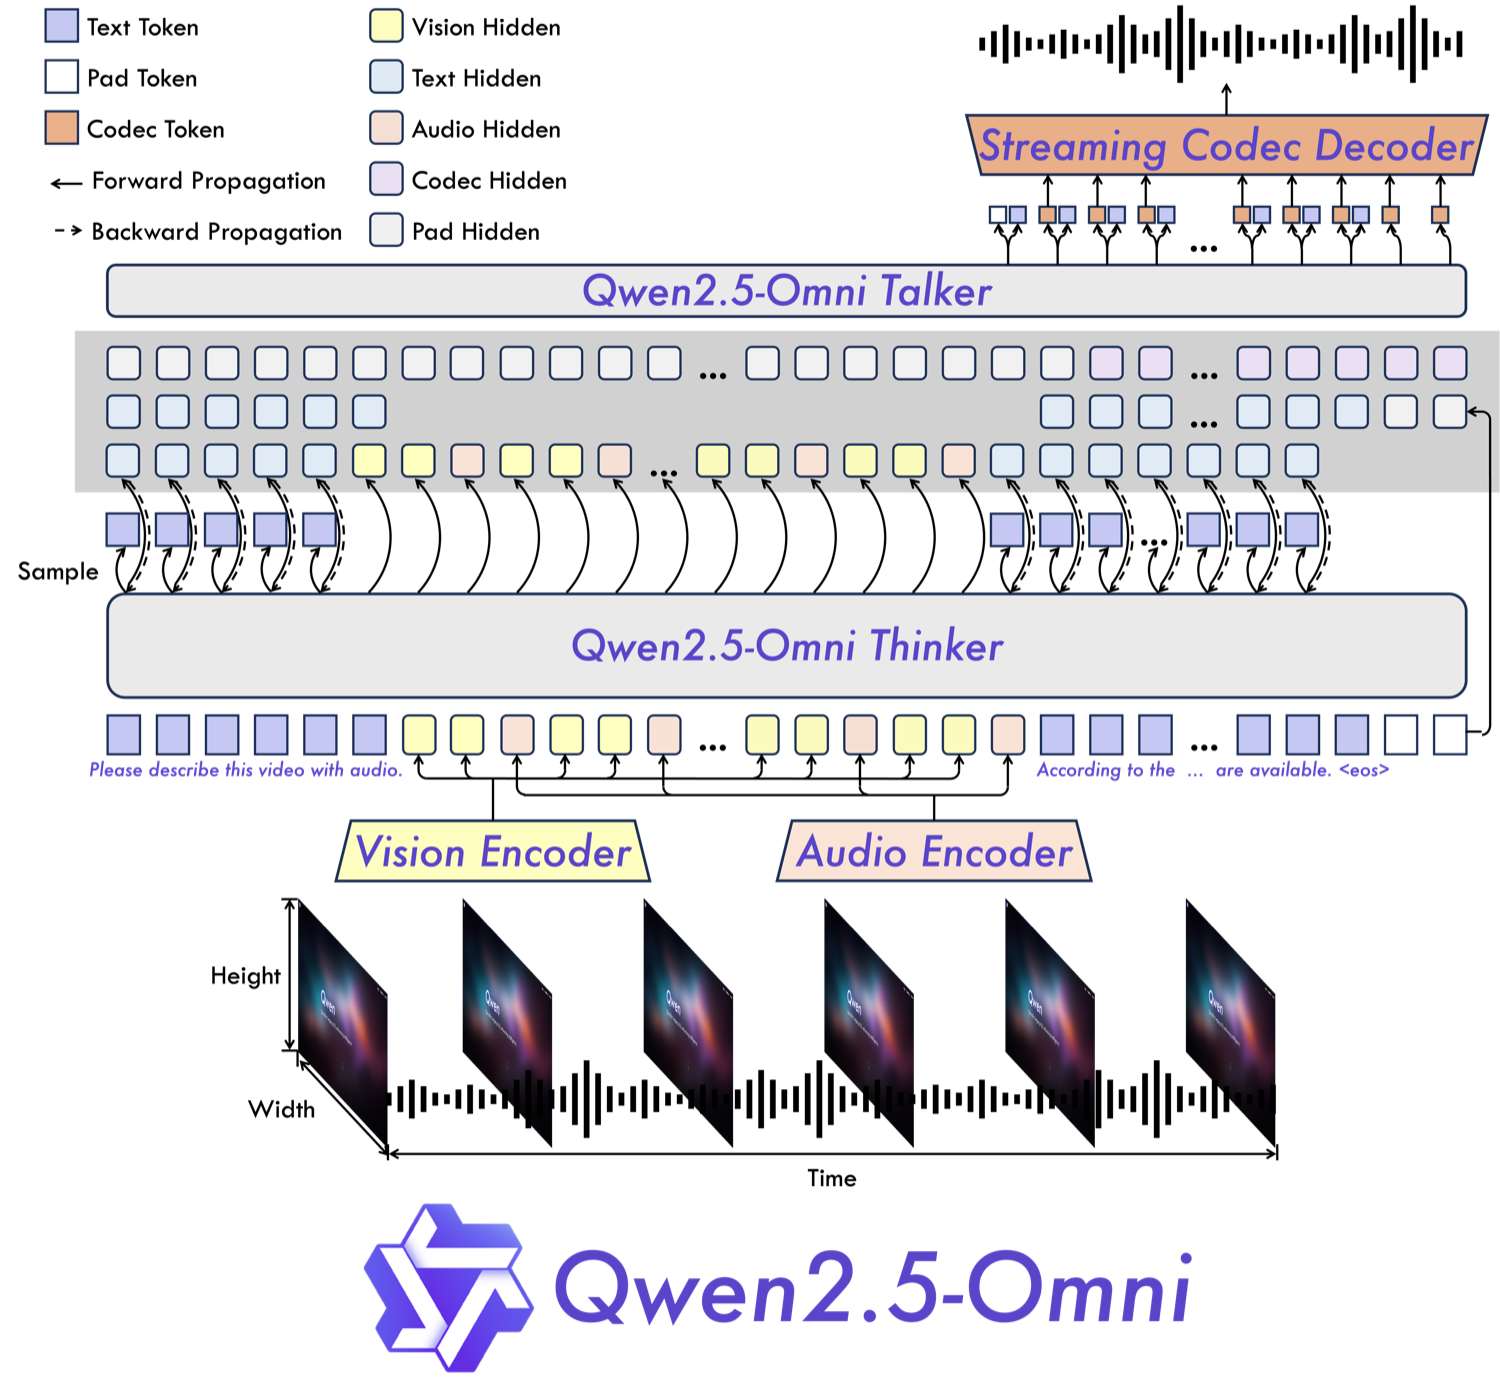
图源:Qwen2.5-Omni GitHub README(Model Architecture,overview.png)https://github.com/QwenLM/Qwen2.5-Omni
整体是 Thinker-Talker 架构(受 Mini-Omni 启发的双轨设计):
- Thinker(“大脑”):一个 Transformer decoder(LLM),外挂音频编码器、视觉编码器,负责理解文本/音频/视频输入并生成高层表示与文本。
- 文本 tokenizer:Qwen tokenizer,byte-level BPE,词表 151,643 个常规 token。
- 音频编码器:取自 qwen2-audio,初始化自 Whisper-large-v3。输入 16kHz 重采样、转 128 通道 mel 谱(窗 25ms、hop 10ms);每帧音频表示≈原始信号 40ms。
- 视觉编码器:取自 qwen2.5-vl 的 ViT,约 6.75 亿参数,图像/视频混合训练;patch size 14,相邻 2×2 token 经 MLP 合并为 1 个 token;视频用动态帧率采样以适配音频采样率,单张图像被当作两个相同帧处理。
- Talker(“嘴”):双轨自回归 Transformer decoder。它直接接收 Thinker 的高维隐表示并共享 Thinker 的全部历史上下文,同时也吃 Thinker 采样出的文本 token 的 embedding——高维表示传递语气/态度等隐含信息(让流式语音能”未读完文本先定调”),离散文本 token 则消除同音异义带来的不确定性(Thinker 表示空间是语义相近而非语音相近)。整套架构作为一个内聚单模型端到端训练/推理。
TMRoPE(Time-aligned Multimodal RoPE):在 M-RoPE(把旋转位置编码拆成 temporal/height/width 三分量)基础上显式加入绝对时间位置。文本三分量用同一 position ID(退化为 1D-RoPE);音频也用同一 ID 并加绝对时间编码,1 个 temporal ID = 40ms;图像 temporal ID 恒定、h/w 按 token 位置分配;带音频的视频按实际帧时间动态调整 temporal ID 保证 1 ID=40ms。多模态混排时,每个模态的位置编号从上一模态最大 position ID +1 起算。
音视频时间交织(time-interleaving):带音频视频按实际时间每 2 秒切块,块内视觉表示在前、音频表示在后交错排列,使模型同步接收视听信息。
语音生成路径:Talker 自回归产出离散音频 token(用自研编解码器 qwen-tts-tokenizer),再由 Flow-Matching DiT 把 code 转 mel 谱、经改造的 BigVGAN 还原波形。语音生成无需与文本做词级/时间戳级对齐,大幅简化训练数据与推理流程。
尺寸:发布 7B(旗舰)与 3B(2025-04-30 补发,便于更多平台运行)两个量级,以及 7B 的 GPTQ-Int4 / AWQ 4-bit 量化版(2025-05-16)。
数据
报告对全模态预训练数据披露了较具体的配比与规模(少见地给了 token 数):
- 预训练数据涵盖 image-text、video-text、video-audio、audio-text 以及纯文本语料多种类型。沿用 qwen2-audio 的做法,把层级化标签替换成自然语言 prompt,以提升泛化与指令遵循。
- 第二预训练阶段新增:图像与视频相关数据 8000 亿(800B) token、音频相关数据 3000 亿(300B) token、带音频视频数据 1000 亿(100B) token。强调纯文本数据对维持/提升语言能力不可或缺。
- 第一阶段两个编码器先各自训练 adapter、再训编码器,建立视觉-文本、音频-文本的核心对齐。
- 第三阶段引入长音频、长视频数据,把文本/音频/图像/视频数据扩到 32,768 token 序列长度训练。
后训练数据:用 ChatML 格式的指令微调数据,含纯文本对话、视觉对话、音频对话、混合模态对话四类。Talker 训练用大量带多模态上下文 + 口语回应的对话数据做语音续写;并用音色解耦(timbre disentanglement) 防止模型把特定嗓音绑定到低频文本模式。语音生成数据无需词级/时间戳对齐。具体数据来源、清洗过滤、合成数据占比等细节未披露。
训练方法
预训练三阶段:
- 阶段一:锁住 LLM 参数,只训视觉/音频编码器,用海量 audio-text、image-text 对增强 LLM 内的语义理解;LLM 由 Qwen2.5 初始化,视觉编码器同 Qwen2.5-VL,音频编码器由 Whisper-large-v3 初始化。
- 阶段二:解冻全部参数,用更广的混合多模态、多任务数据全面学习,加深听/视/文交互。
- 阶段三:用 32k 长序列数据增强长序列理解(前两阶段为效率限制在 8192 token)。
后训练 — Thinker:ChatML 格式做指令微调(纯文本 / 视觉 / 音频 / 混合模态对话)。
后训练 — Talker(三阶段):
- In-Context Learning (ICL):除文本监督外,做语音续写 next-token 预测,学到从语义表示到语音的单调映射,并习得韵律/情感/口音等可控属性;同时做音色解耦。
- DPO(Direct Preference Optimization):增强语音生成稳定性。构造三元组 (x, y_w, y_l)(输入、好/坏语音序列),依据与 WER 和标点停顿错误率相关的 reward score 对样本排序,用标准 DPO 损失优化——这一阶段报告里称为强化学习(RL)阶段,显著降低 test-hard 上的注意力错位、发音错误和不当停顿。
- 多说话人指令微调(speaker fine-tuning):让 Talker 采用特定嗓音,提升自然度与可控性。
流式相关训练/架构改造(降低首包延迟的四个来源——输入处理、文本到首语音 token、首段语音转音频、架构固有延迟):
- 分块预填充(chunked-prefills):把音频编码器从整段全注意力改成 2 秒一块的块内注意力;视觉编码器用 flash attention + 2×2 token 合并。
- 流式 codec 生成 — 滑动窗口块注意力 DiT:把相邻 code 分块,DiT 感受野限制为 4 块(回看 2 块 + 前看 1 块),Flow-Matching 分块生成 mel 谱,BigVGAN 也按 chunk 流式还原波形,从而降低初始包延迟。
Infra(训练 / 推理工程)
- 训练算力 / GPU·时 / 并行策略 / 吞吐:报告未披露(仅给出数据 token 规模与序列长度策略)。
- 推理 / 部署(主要来自 GitHub README):
-
支持
transformers与 vLLM;2025-04-11 起 vLLM 版本支持音频输出。官方提供 Docker 镜像。 -
不需要语音输出时可调
model.disable_talker(),省约 2GB 显存。 -
量化:7B 的 GPTQ-Int4 / AWQ 仅量化 Thinker 权重,并把 code2wav 模块改成流式推理避免预分配过多显存,显存占用降 50%+,可在 RTX 3080/4080/5070 等消费卡运行(量化版因 CPU offload 推理略慢)。
-
显存需求(transformers,BF16+FA2 理论下限,实测约 ×1.2):
模型 精度 15s 视频 30s 视频 60s 视频 3B BF16 18.38 GB 22.43 GB 28.22 GB 7B BF16 31.11 GB 41.85 GB 60.19 GB 7B GPTQ-Int4 11.64 GB 17.43 GB 29.51 GB 7B AWQ 11.77 GB 17.84 GB 30.31 GB (FP32 下 15s 视频 7B 需 93.56 GB,30s/60s 不推荐。)
-
输出语音支持两种音色:Chelsie(女)/ Ethan(男),默认 Chelsie,经
speaker参数切换。
-
评测 benchmark(把效果讲清楚)
图源:Qwen2.5-Omni GitHub README(Performance,bar.png)https://github.com/QwenLM/Qwen2.5-Omni
全部数字来自已落盘的技术报告(arxiv-2503.20215)。模型分理解(X→Text)与语音生成(X→Speech)两大类评测。
Text→Text(7B 纯文本对比,Table 1):Qwen2.5-Omni-7B 介于 Qwen2-7B 与 Qwen2.5-7B 之间,多数基准超 Qwen2-7B。例:MMLU-Pro 47.0、MMLU-redux 71.0、GSM8K 88.7、MATH 71.5、HumanEval 78.7、MBPP 73.2、LiveCodeBench(2305-2409) 24.6。
Audio→Text(Table 2/3):
- ASR:Librispeech test-clean/test-other = 1.8/3.4(优于 Whisper-large-v3、Qwen2-Audio);Common Voice 15 en/zh 等多语种 SOTA 级。
- 音频推理 MMAU:Sound/Music/Speech/Avg = 67.87 / 69.16 / 59.76 / 65.60,大幅超 Gemini-Pro-V1.5(54.90) 与 Qwen2-Audio(49.20)。
- 语音交互 VoiceBench:平均 74.12,超同尺寸音频/omni 模型(MiniCPM-o 71.69、Baichuan-Omni-1.5 71.14)。
- SER(Meld) 0.570、VSC(VocalSound) 0.939 均为 SOTA 级。
- 语音指令 vs 文本指令差距收窄(Table 4):在 MMLU*/GSM8K* 等把文本指令转语音后,Qwen2.5-Omni(语音输入)显著缩小与 Qwen2-7B(文本输入)的差距,例如 GSM8K* 85.4 对 Qwen2-7B 82.3,远好于 Qwen2-Audio 的 18.4——证明语音指令遵循已接近文本水平。
Image→Text(Table 5/6):与 Qwen2.5-VL-7B 相当,并在多项超过其他开源 omni 模型与 GPT-4o-mini。例:MMMU-val 59.2、MathVision 25.0、MMBench-V1.1-EN 81.8、TextVQA 84.4、DocVQA 95.2、ChartQA 85.3、OCRBench_V2 57.8。视觉 grounding:RefCOCO-val 90.5,开放词表检测 ODinW 42.2 mAP,point-grounding 66.5,均超 Qwen2.5-VL-7B。
Video→Text(Table 7):Video-MME(w/o sub) 64.3、(w sub) 72.4、MVBench 70.3、EgoSchema 68.6,优于全部开源 omni 模型与 GPT-4o-mini,对 Qwen2.5-VL-7B 持平或更优。
Multimodality→Text — OmniBench(Table 8,核心亮点):Speech/Sound/Music/Avg = 55.25% / 60.00% / 52.83% / 56.13%,大幅领先 Gemini-1.5-Pro(42.91%)、MIO-Instruct(33.80%)、UnifiedIO2-xlarge(38.00%)、MiniCPM-o(40.5%)、Baichuan-Omni-1.5(42.9%)——多模态融合理解 SOTA。
X→Speech(语音生成,Table 9/10):
- 零样本 TTS(seed-tts-eval,WER↓ test-zh/en/hard):ICL 版 1.70/2.72/7.97,RL 版 1.42/2.33/6.54,优于 MaskGCT(2.27/2.62/10.27) 与 CosyVoice 2(1.45/2.57/6.83);说话人相似度 SIM 与 Seed-TTS、CosyVoice 2 相当(RL 版 0.754/0.641/0.752)。RL 显著降低 test-hard 上的发音错误与不当停顿。
- 单说话人:speaker-finetune 后内容一致性接近人类(test-zh 1.29~1.37 vs Human 1.25),自然度 NMOS 4.48
4.51(zh)/ 4.584.62(en),接近 Human(4.51/4.46)。
关键消融/结论:RL(DPO) 对语音稳定性、speaker-FT 对自然度、TMRoPE 对音视频协同理解、32k 阶段对长序列均有明确正向贡献(报告以阶段对比与 ICL→RL 对比呈现,未给逐项数值化消融表)。
创新点与影响
核心贡献:
- Thinker-Talker 架构——文本与语音分两套自回归头但共享上下文与隐表示,端到端联合训练,解决”同时出文本+语音且互不干扰”。
- TMRoPE——首个把绝对时间戳显式编进多模态 RoPE 的方案,配合 2 秒块的音视频时间交织,真正实现逐帧音视频时间同步。
- 流式全链路——块状编码器(分块预填充) + 滑动窗口块注意力 DiT + 流式 BigVGAN,覆盖从感知到出声的低延迟流水线。
- 开源全模态标杆——7B 单模型在 OmniBench 等融合基准 SOTA,且语音指令遵循逼近文本指令,以 Apache-2.0 开源,附 3B / GPTQ-Int4 / AWQ 让消费级显卡可跑。
影响:成为开源 omni 模型的主要对标基线(对标 GPT-4o 的开源回应),后续 Ming-Omni、Baichuan-Omni 等工作普遍以其为比较对象;其 Thinker-Talker / 时间交织思路也被后续 Qwen 全模态迭代沿用。
已知局限:报告自陈 video OCR 与 音视频协同理解(audio-video collaborative understanding) 等问题长期被忽视、仍缺综合评测基准与研究数据;训练算力/分布式工程细节、数据具体来源与合成占比均未披露;语音生成评测受限于现有 TTS 式指标(缺端到端语音对话的成熟评测)。未来方向为更强更快、并扩展到图像/视频/音乐等更多输出模态。
原始链接
- arxiv_abs: https://arxiv.org/abs/2503.20215
- arxiv_pdf: https://arxiv.org/pdf/2503.20215
- github: https://github.com/QwenLM/Qwen2.5-Omni
- hf: https://huggingface.co/Qwen/Qwen2.5-Omni-7B
- hf(3B): https://huggingface.co/Qwen/Qwen2.5-Omni-3B
- hf(GPTQ-Int4): https://huggingface.co/Qwen/Qwen2.5-Omni-7B-GPTQ-Int4
- hf(AWQ): https://huggingface.co/Qwen/Qwen2.5-Omni-7B-AWQ
- modelscope: https://modelscope.cn/organization/qwen
一手源存档(sources/)
- arxiv-2503.20215.pdf (技术报告 PDF,.gitignore 排除,本地精读)
- arxiv-2503.20215.txt (PDF 全文抽取,已读全文)
- readme.md (GitHub README 快照,含 3B/量化/显存/部署)
- hf-modelcard.md (HuggingFace 7B model card 快照)